
MAI-Base-2 в 4–12 раз экономнее DeepSeek на предобучении
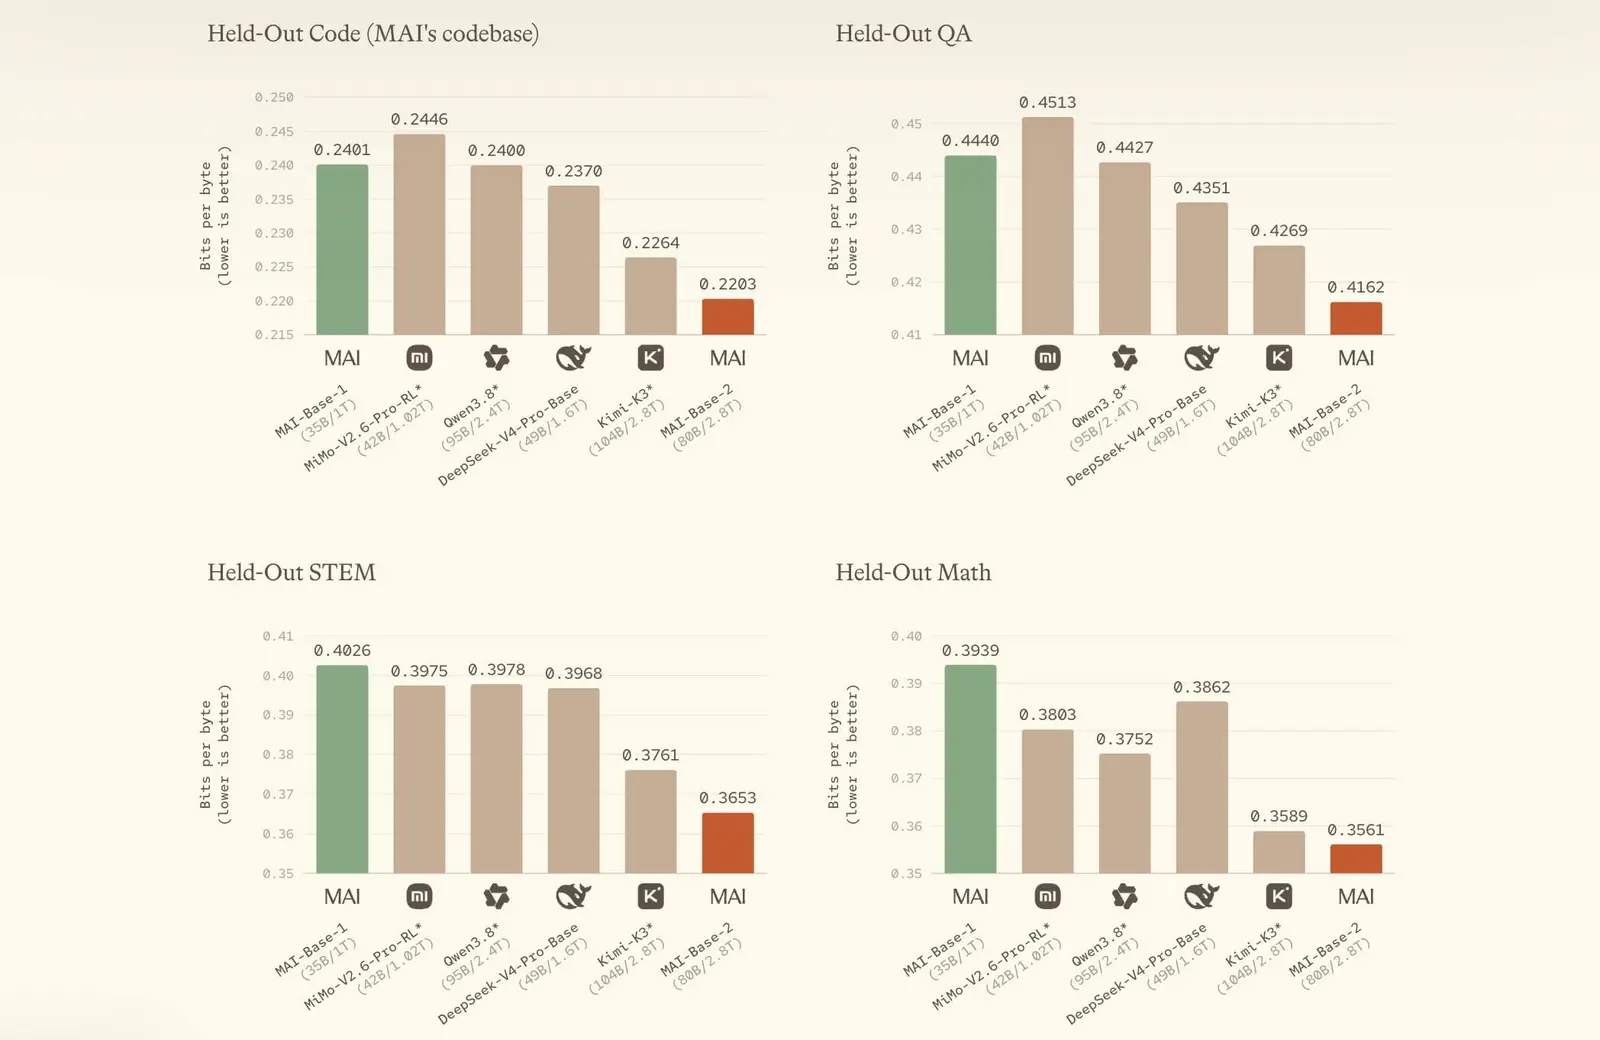
Microsoft AI закончила предобучение базовой модели MAI-Base-2 и 15 октября рассказала, как оно было устроено. Главная цифра в посте Microsoft AI такая: по оценке компании, на предобучении MAI-Base-2 в 4-12 раз эффективнее по FLOPs, чем DeepSeek-V4-Pro-Base, сильнейшая из открытых базовых моделей.
Почти весь остальной текст посвящён инженерии: как держать память под контролем в разреженной MoE-модели, как запустить оптимизатор Muon на 16K GPU и как удержать градиенты в узком коридоре.
Откуда 4-12x
«MAI-Base-2 превосходит все модели с открытыми весами, которые мы протестировали на наших отложенных оценках», говорят в Microsoft AI. Отложенные оценки здесь - наборы, которых модель не видела при обучении. Выигрыш в FLOPs компания, по её словам, оставила себе не как экономию: «мы вложили её в обучение более крупной модели».
Сравнение на первом графике поста идёт в весовой категории от триллиона общих параметров: MAI-Base-2 стоит там рядом с другими моделями такого размера на наборе оценок предобучения, где меньший результат лучше. Для Microsoft это знакомый класс. На Build 2 июня компания показала семь собственных моделей MAI, в том числе MoE-модель MAI-Thinking-1 на 1T общих и 35B активных параметров, обученную примерно на 33T токенов с нуля, без дистилляции из чужих моделей. Базы MAI нужны и продуктам поменьше: модель для быстрых решений Microsoft-Decision-1, сейчас это дообученная Qwen3.5-9B, компания обещала пересобрать в том числе на MAI.
Оба главных утверждения, и про превосходство над открытыми моделями, и про 4-12x, пока держатся только на собственных оценках Microsoft AI.
Эксперты с фиксированной ёмкостью
В MoE-модели каждый токен уходит к нескольким экспертам, и нагрузка на них гуляет: одному достаётся много токенов, другому почти ничего. Обычно это бьёт по памяти, потому что буферы приходится держать под худший случай. Microsoft AI решает задачу так. Экспертов на каждом ранге экспертного параллелизма объединяют в группы настраиваемого размера. Группа проходит раунды «разослать токены - посчитать - собрать результат», и у каждого эксперта в раунде фиксированная ёмкость по токенам.
Если эксперту пришло больше токенов, чем он вмещает, лишние обрабатываются в дополнительных раундах. Чтобы таких раундов было меньше, перегруженный эксперт может занять свободную ёмкость соседей по группе. В обратном проходе идёт точечный пересчёт по группам по тому же многораундовому расписанию. В итоге расход памяти не зависит от дисбаланса токенов.
Ёмкость - ручка с понятной ценой: больше ёмкости означает больше памяти, меньше ёмкости грозит лишними раундами и лишними вычислениями. На практике её подбирают так, чтобы в установившемся режиме хватало одного раунда.
Рассылка, вычисление и сбор идут конвейером через все раунды всех групп, поэтому с вычислениями экспертов не перекрываются только первая рассылка и последний сбор. В прямом проходе этот открытый остаток связи закрывают квантизацией весов и вычислением общего эксперта. В обратном проходе связь экспертов перекрыта полностью: входную рассылку прячут за пересчётом того же слоя, сбор градиентов - за вычислением градиентов весов.
Накладные расходы на каждого эксперта в Microsoft AI срезали четырьмя способами:
- вычисления и связь группируются по группам экспертов, что повышает эффективность GEMM и NVLink и снижает издержки на запуск ядер и «хвосты»;
- метаданные токенов живут на GPU, и all-to-all запускается прямо с GPU, без лишней синхронизации с хостом;
- симметричная память позволяет обменивать токены напрямую по NVLink без промежуточных копий, что поднимает пропускную способность и снижает конкуренцию за HBM, когда параллельно идут GEMM;
- loss балансировки нагрузки считается пакетно по всем слоям: одна редукция вместо all-reduce на каждом слое.
По словам компании, всё это даёт обучать более разреженные модели без заметной просадки MFU, доли пиковой производительности железа, которую обучение реально использует.
Muon на 16K GPU
При переходе к масштабу MAI-Base-2 Muon, как утверждает Microsoft AI, дал более стабильную динамику обучения и большой выигрыш в эффективности по сравнению с AdamW. Сколько именно, компания не уточняет. Независимый ориентир есть у Moonshot AI: в работе «Muon is Scalable for LLM Training» её эксперименты по законам масштабирования показывают для Muon примерно двукратную вычислительную эффективность против AdamW при compute-оптимальном обучении. Там же сказано, что для масштабирования Muon нужны weight decay и аккуратная подстройка масштаба обновления для каждого параметра.
Сложность в устройстве самого оптимизатора. Muon ортогонализует момент каждой матрицы весов итерациями Ньютона - Шульца, а это несколько матричных умножений над целой матрицей. ZeRO же режет момент на куски по data-parallel измерению, и целой матрицы ни на одной карте нет. Microsoft AI, следуя прежним работам, перераскладывает момент прямо на шаге оптимизатора:
- каждый GPU обновляет свой кусок момента в FP32 и переводит его в BF16;
- обмен all-to-all, сгруппированный по параметрам одной формы, отдаёт каждой карте набор целых матриц;
- карта ортогонализует их у себя ядром Ньютона - Шульца, которое учитывает симметрию;
- второй all-to-all возвращает обновления на исходные куски, где их переводят обратно в FP32 и применяют к весам.
Сверху для 16K GPU добавлено ещё несколько оптимизаций. Связь перекрывается с вычислениями за счёт предвыборки нескольких пакетов. Метаданные перераскладки кешируются, что особенно полезно в разреженных MoE-моделях с тысячами параметров одинаковой формы. Отдельные веса, например веса роутера MoE, не режутся, а копируются на все карты: для них первый обмен пропускают и после Ньютона - Шульца собирают обновления через all-gather.
Результат: Muon занимал 2,1%, или 165 мс, средней итерации обучения MAI-Base-2. Из этих двух цифр следует, что средняя итерация длится около 7,9 секунды. Теоретический предел для финальной конфигурации компания оценила в 55 мс, и упирается он в связь. Разрыв между пределом и замером Microsoft AI объясняет отстающими узлами, издержками на запуск ядер, дисбалансом нагрузки и копированиями и выделениями памяти во время перераскладки. Реализацию проверяли профилями на больших и малых стендах и по ним же выбирали, что чинить первым.
Последний приём - обрезка градиентов по активациям. Обычная обрезка смотрит на глобальную норму градиента весов по всему батчу, хотя выбросы, как правило, дают несколько примеров. Один такой выброс сжимает градиенты всего батча, вместе с вкладом нормальных примеров. Microsoft AI обрезает градиенты активаций в выбранных местах сети, и вместе с Muon это держит норму градиента MAI-Base-2 в куда более узком диапазоне, чем у MAI-Base-1.
Следующая итерация уже в работе: как утверждает Testing Catalog, Microsoft готовит цикл обучения MAI-Base-3.
Дальше
Прокуроры: инженер OpenAI взял билет в один конец
Билеты в один конец до Саудовской Аравии, из Сан-Франциско через Стамбул на 12 октября. По данным Bloomberg, этим прокуроры объяснили суду, зачем засекретить дело инженера OpenAI. Задержали его за три дня до вылета.
Читайте также
- У Microsoft-Decision-1 выходные токены бесплатные
- MAI-Transcribe-2 получил потоковую версию для голосовых агентов
- Microsoft переводит свои ИИ-сервисы на собственные чипы Maia
- Диффузионная модель выдаёт 1 107 токенов в секунду
- Claude угадывает белки, о которых никто не писал
- Модель Microsoft догнала GPT-6 Astra за 2% цены
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.