
Модели OpenAI помогли AMD улучшить флагманский GPU
OpenAI рассказала в своём блоге, что её модели помогли AMD улучшить флагманский GPU. Модель переписала код, которым описаны схемы чипа. По данным OpenAI, это дало до 14% выигрыша по энергопотреблению, скорости и площади на кристалле, причём сравнивали с вариантами, которые и так были сильно оптимизированы. Часть правок AMD уже включила в проект, недавно отправленный в производство. Этот же подход OpenAI раньше опробовала на собственном чипе Jalapeño.
Что было с Jalapeño
Jalapeño - первый собственный чип OpenAI. Он предназначен для инференса, то есть для работы уже обученных моделей. В июне 2026 года его представили вместе с Broadcom, а в августе OpenAI рассказала, что разработку ускоряли её модели. Теперь компания объяснила, что именно они сделали.
Модели подключили к проектированию в начале 2025 года, начиная с GPT-4o. Даже такая ранняя модель находила заметные улучшения в блоках, которые выполняют вычисления. Например, она переделала схему умножения так, что та заняла примерно на 15% меньше площади и стала выдавать результат за один такт вместо двух. По оценке команды, предложенные моделями правки уменьшили площадь в векторном блоке примерно на 13%, а в матричном на 10%. Эти улучшения подтвердились на первых настоящих кристаллах.
Что сделали с AMD
С AMD модель работала над кодом на SystemVerilog. На этом языке инженеры описывают, из каких схем состоит чип. По словам OpenAI, модель рассуждала о таком коде на уровне опытного архитектора: переписывала схемы, которые считают, управляют операциями или перемещают данные. После каждой правки она с помощью инструментов Synopsys, в которых инженеры проектируют и проверяют чипы, убеждалась, что блок работает как раньше, и оценивала, что выиграно и чем за это заплачено.
OpenAI называет результат примерно годом прогресса, достигнутым меньше чем за пять месяцев. Часть изменений AMD уже отправила в производство, остальные добавила в рабочие файлы проекта для будущих версий. На ключевых блоках своего следующего флагманского CPU AMD подтвердила выигрыш в несколько процентов на схемах, написанных моделью.
Как сравнивали модели
Чтобы понять, насколько каждое новое поколение моделей лучше справляется с проектированием, OpenAI дала им два небольших открытых процессорных ядра, PicoRV32 и Ibex. Модели нужно было ускорить ядро, то есть увеличить число команд, которые оно выполняет в секунду. Если ядро не проходило проверку в симуляции или занимало больше чем в 16 раз исходной площади, попытка получала ноль. При одинаковом бюджете около 112 000 токенов на попытку лучший средний результат на обоих ядрах показала GPT-6.2 Astra. На PicoRV32 её оценка примерно вдвое выше, чем у GPT-6 Astra.
Во втором задании модели проектировали ядро с нуля по письменным требованиям, и все пять моделей справились лучше, чем при улучшении готового ядра. OpenAI сама оговаривается, что сравнение не вполне честное. Проектируя с нуля, модели могли выбросить то, что есть в настоящих ядрах, например счётчики производительности и дополнительные команды, а это, возможно, отчасти объясняет разницу. Чтобы тест был ближе к реальному производству, по словам компании, нужно требовать эти функции, жёстче ограничить площадь и проверять, укладывается ли схема по скорости после физического синтеза.
Что дальше
Вместе с Synopsys OpenAI обучает новую модель GPT-Synopsys. Она должна научиться пользоваться программами проектирования чипов так же, как это делают опытные инженеры.
Дальше
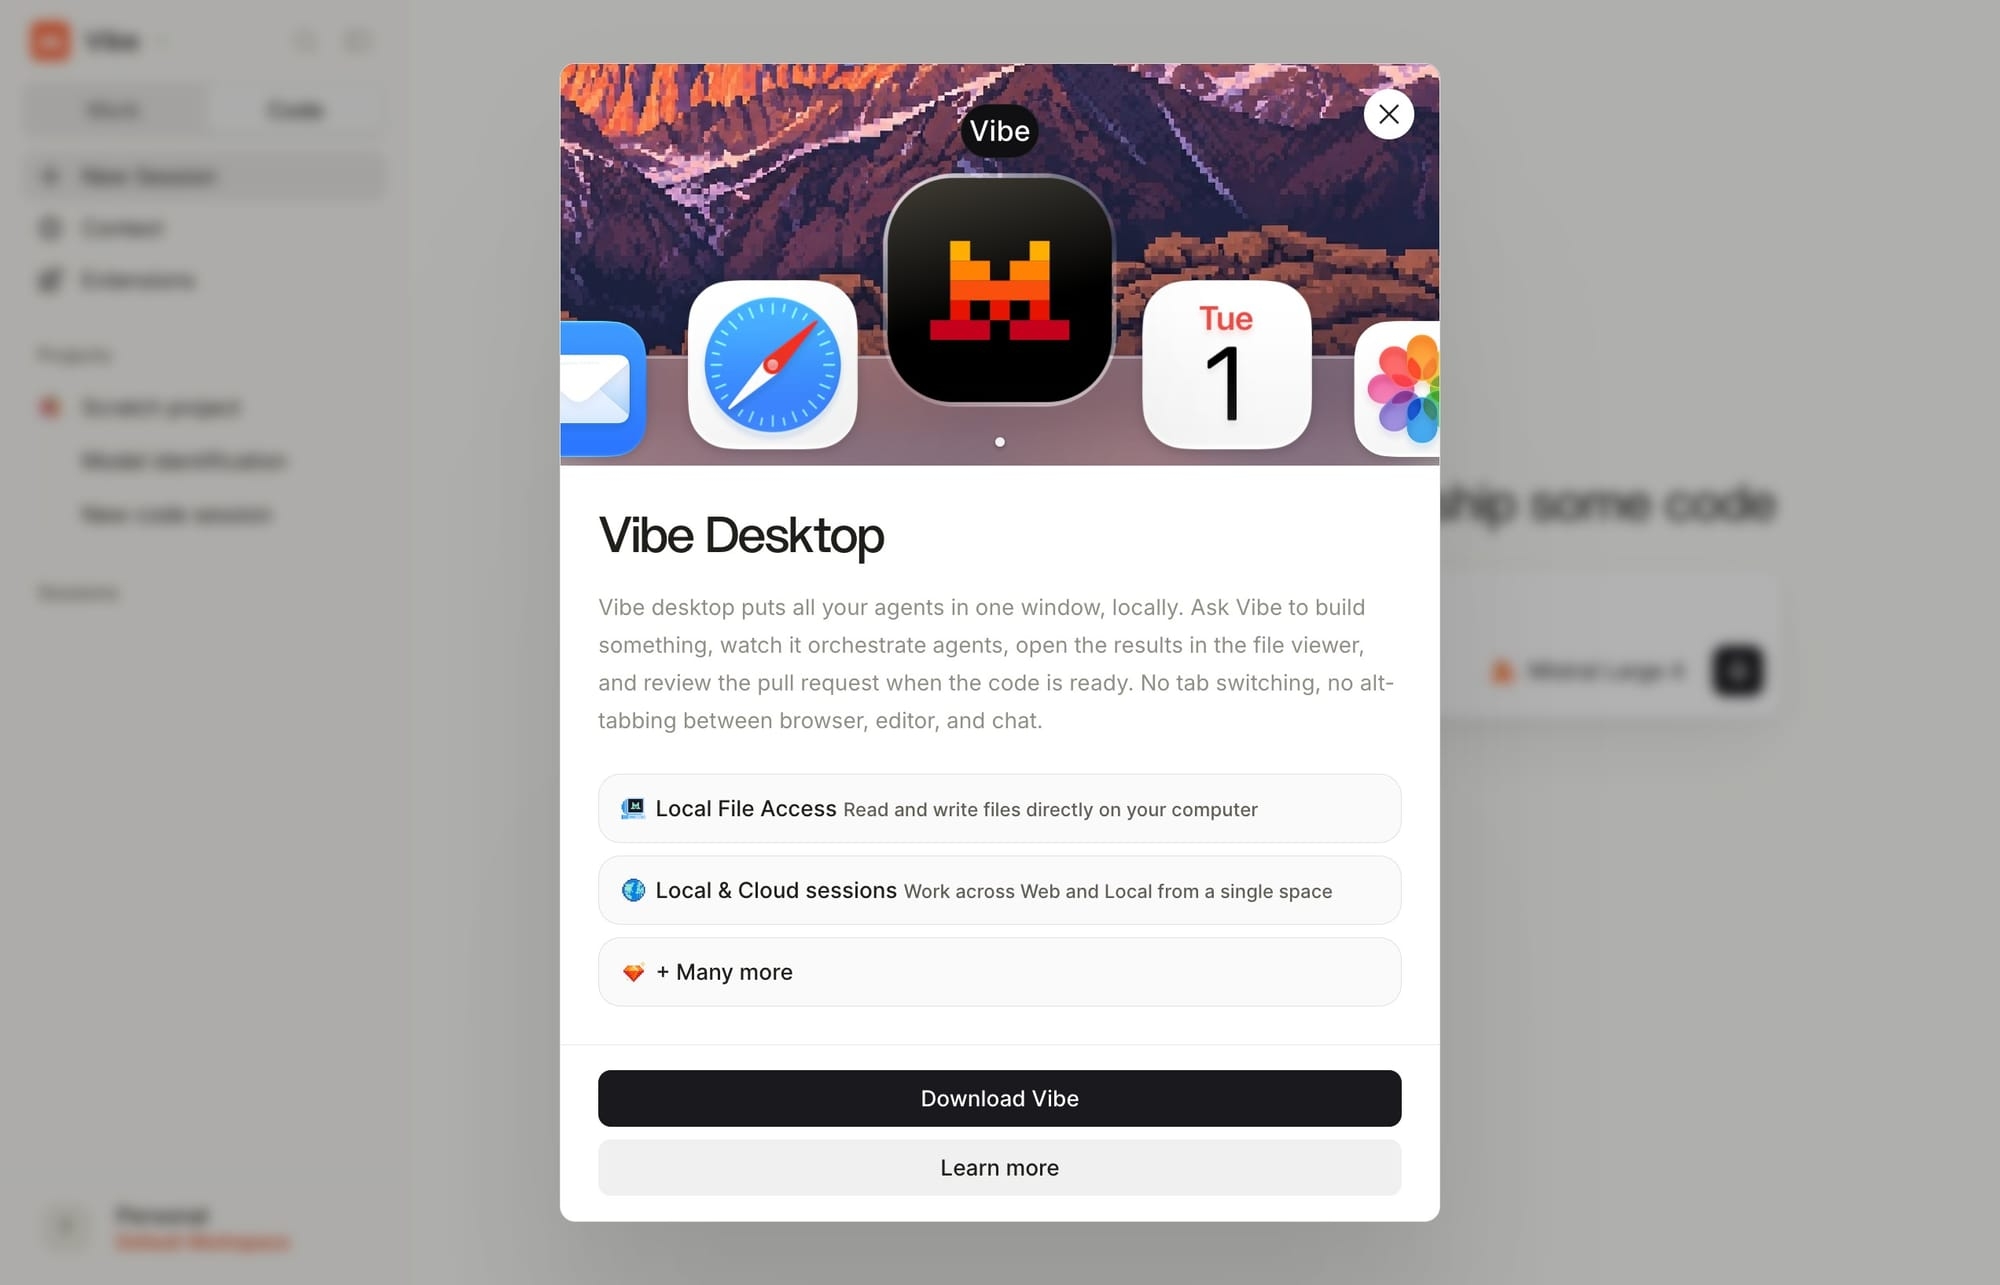
Mistral выпустила Vibe для macOS и Windows
У агента Mistral Vibe появилось приложение для macOS и Windows: ему можно раздать сразу несколько задач, смотреть, как агенты работают бок о бок, и тут же проверять их правки и пул-реквесты. Раздали бы агенту несколько задач сразу или ведёте их по одной?
Читайте также
- Свои модели вывели чип OpenAI на 88,94% потолка за 40 часов
- Хо из OpenAI: 99,99% точности мало для чипа Jalapeño
- Заказной чип OpenAI обещает быстрый инференс
- OpenAI проектировала Jalapeno от задержки, а не от флопсов
- GPT-6.2 Astra чаще умалчивает о проблемах
- Учёные считают, что ChatGPT ускоряет их работу в 1,9 раза
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.