
Сохранение рассуждений подняло ARC-AGI-3 с 13,3% до 38,3%
Агентов на GPT-5.6 OpenAI предлагает удешевлять тремя способами: брать младшие модели, снижать уровень рассуждений и включать новые настройки Responses API, говорится в руководстве OpenAI для разработчиков от 13 августа. С двумя из них, сохранением рассуждений между ходами и сжатием длинного контекста, та же GPT-5.6 Sol набрала на ARC-AGI-3 38,3% вместо 13,3% на стандартной обвязке и потратила примерно вшестеро меньше выходных токенов. Замер провела сама OpenAI.
Как сохранить рассуждения между ходами
Для GPT-5.6 рассуждения сохраняются автоматически, если передавать в Responses API ID предыдущего ответа: тогда они переходят через вызовы инструментов и ходы диалога, как описывает OpenAI в разборе обвязки ARC-AGI-3. Сжатие (compaction) включается отдельной настройкой того же API и сводит старый контекст в краткое резюме вместо того, чтобы его выбросить.
Официальная обвязка ARC-AGI-3 после каждого игрового хода стирала скрытые рассуждения модели: Sol видела запись прошлых ходов и короткие заметки, но не планы и догадки за ними, и на каждом ходу разбиралась в игре заново. Когда переписка превышала 175 000 символов, самые старые сообщения отбрасывались, и вместе с ними модель теряла ранние наблюдения и действия. С сохранёнными рассуждениями Sol меньше думала перед каждым ходом, гораздо лучше училась по ходу игры и держалась связной стратегии.
ARC Prize Foundation, как сообщает OfficeChai, ответила на разбор OpenAI защитой своих проверенных результатов: их намеренно получают «без обвязки», с одинаковыми для всех моделей наблюдениями, системным промптом и лимитами действий, а состояние диалога ведёт клиент через стандартный интерфейс в стиле completions, без фирменного управления сессиями какого-либо провайдера. ARC также сообщила, что вместе с OpenAI и другими лабораториями прорабатывает, как можно было бы учесть хранение состояния на стороне сервера в проверенном тестировании, не дав преимущества ни одному провайдеру.
Luna, Terra и уровень рассуждений
Для длинных агентных задач раньше лучше всего подходил флагман на максимальном уровне рассуждений: младшие модели заметно хуже справлялись с длинным контекстом и вызовом инструментов. В семействе 5.6 Luna и Terra, если дать им больше вычислений на этапе ответа, часто выступают на уровне GPT-5.4 и GPT-5.5 и при этом стоят заметно дешевле.
В BrowseComp, бенчмарке на поиск малоизвестных фактов, GPT-5.5 на уровне рассуждений Extra High за три месяца до выхода руководства набрала 84,36%, и прогон обошёлся в $33,27. GPT-5.6 Luna на том же уровне на старте дала почти тот же результат, 84,04%, за $1,33, примерно в 25 раз дешевле. Причём $1,33 посчитаны по стартовым ценам: 30 июля Luna в API подешевела на 80%, Terra на 20%.
Младшие модели OpenAI советует ставить на большие объёмы запросов, на взаимодействия, чувствительные к задержке, и на повторяющиеся шаги внутри агентных сценариев. Пример из руководства: юридический стартап, который разбирает рукописные служебные записки перед агентным анализом, может отдать этап извлечения Terra или Luna, не гоняя флагман на всём пути, и заметно сэкономить.
При той же обвязке GPT-5.6 Sol с уровнем рассуждений low на Agents' Last Exam обошла GPT-5.5 с уровнем high. По словам OpenAI, стартапы в продакшн-тестах заметно сэкономили на целом ряде сценариев, опустив уровень рассуждений ниже прежних значений по умолчанию.
Кэш, JavaScript и подагенты
Минимальный срок жизни кэша промптов во всём семействе вырос до 30 минут, а точки кэширования (cache breakpoints) теперь можно ставить детерминированно внутри контекстного окна; стартапам это, как утверждает компания, заметно подняло долю попаданий в кэш. Подходящий prompt_cache_key при этом стоит передавать и дальше: так выше шанс, что запрос попадёт на тот же движок инференса, который уже обслуживал такой же префикс, и задержка снизится.
Программный вызов инструментов (Programmatic Tool Calling) отделяет работу, где нужно суждение, от перекладывания, фильтрации и сведения данных. GPT-5.6 пишет JavaScript, который вызывает инструменты, запускает независимые вызовы параллельно и обрабатывает их выводы вне контекстного окна. Если агент достаёт 100 отчётов, фильтрует их по дате и ищет нужные транзакции, модели не приходится рассуждать над каждым промежуточным результатом. Токены модели остаются для суждений, а стоимость, задержка и context rot, падение качества по мере разрастания контекста, снижаются.
На сложных задачах, которые можно распараллелить, работа нескольких агентов ускоряет решение и повышает его качество: главный агент раздаёт задачи подагентам, те параллельно идут к своим целям и возвращают результат ему для итоговой сводки. Такой режим включается в Responses API, и так же устроена настройка ultra в ChatGPT. GPT-5.6, по словам OpenAI, сама хорошо чувствует, сколько подагентов нужно и когда их запускать, но поведение управляемо: если прописать в инструкциях, когда вызывать подагентов, модель чаще запускает их только там, где лишние токены дают лучший результат.
Дальше
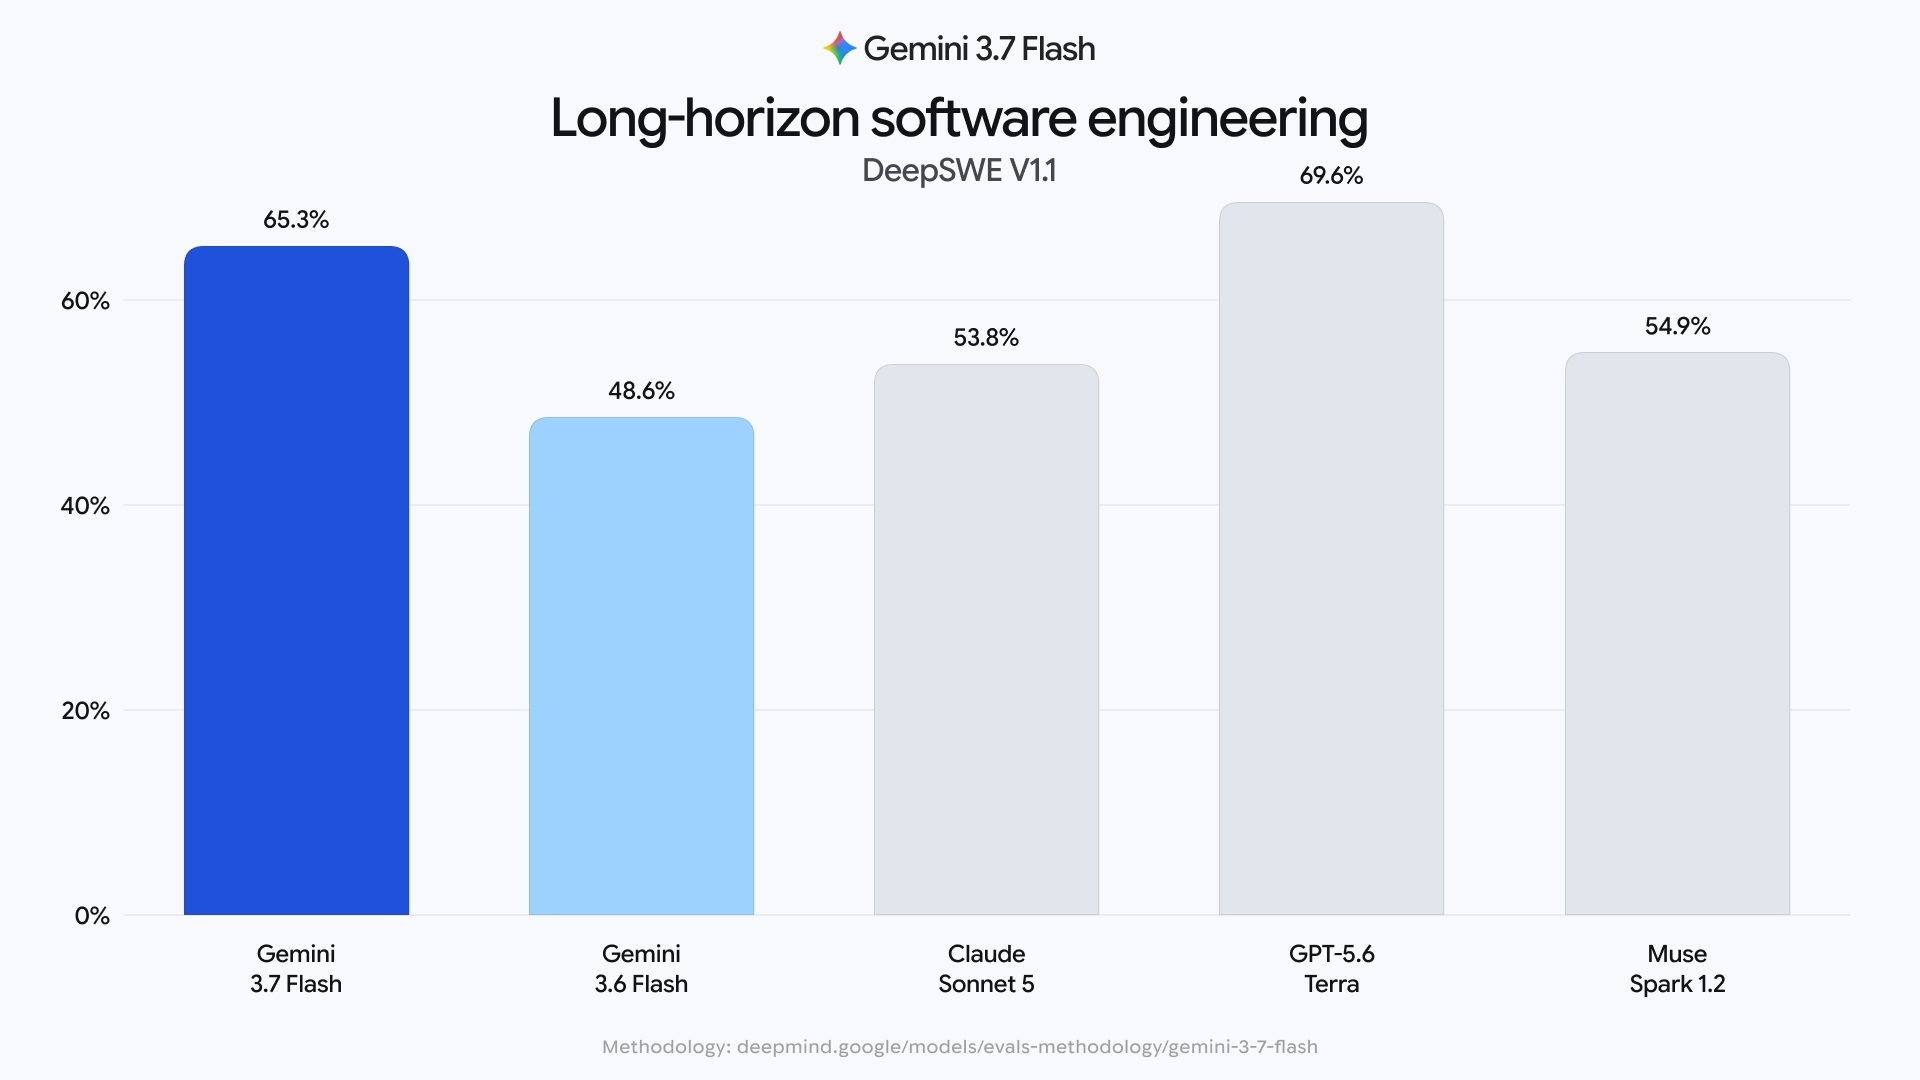
Цена Gemini 3.7 Flash вдвое ниже, чем у 3.6 Flash, Видео
65% на DeepSWE V1.1 набрала Gemini 3.7 Flash, сообщает Testing Catalog, почти догнав GPT-5.6 Terra. При этом новая модель Google стоит на 50% дешевле, чем Gemini 3.6 Flash.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.