
Зрение GPT-5.6 подтянулось, но Gemini 3.5 Flash дешевле
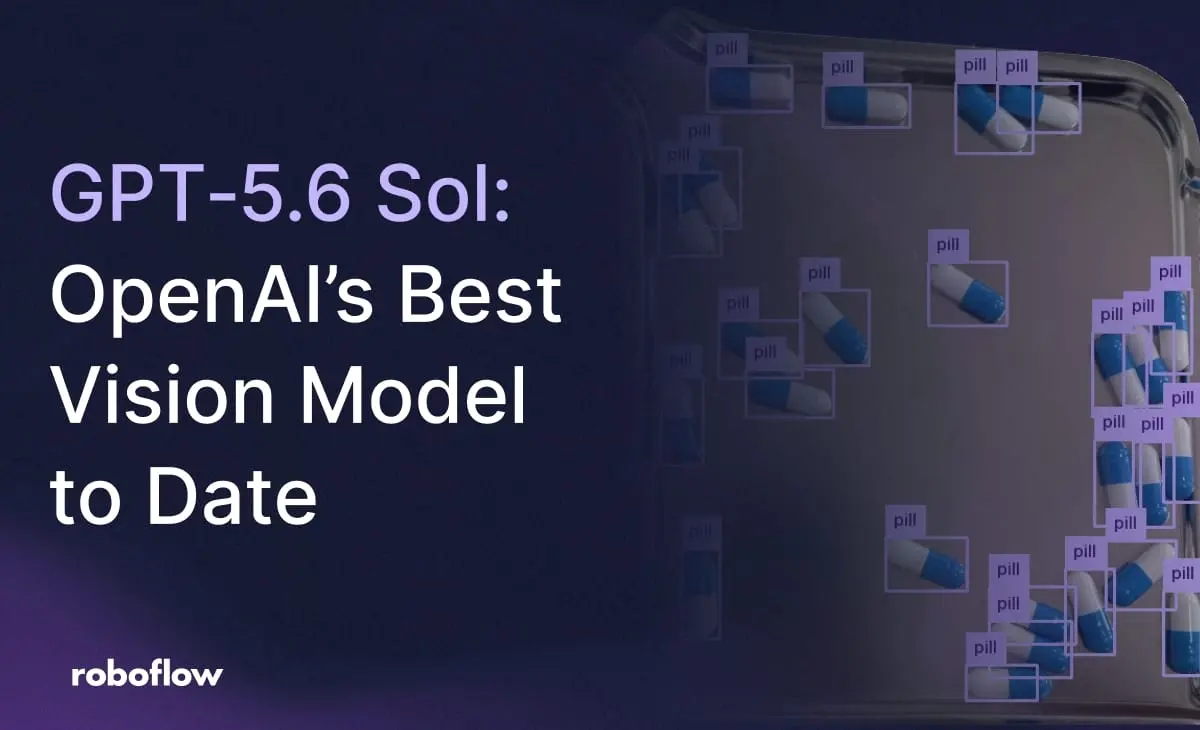
Sol, старшая модель линейки GPT-5.6, в тестах Roboflow от 17 августа набрала в детекции объектов 46,2 по метрике точности рамок mAP@50 против 13,8 у GPT-5.5, и для лучшего результата рамки у неё нужно просить в абсолютных пиксельных координатах XYXY: с неподходящим форматом модели GPT-5.6 теряли в детекции около 15 пунктов. Gemini 3.5 Flash в том же бенчмарке по-прежнему первая в детекции и подсчёте объектов и стоит 0,8 цента за изображение против примерно 2,5 у Sol.
Замеры сделаны на собственном бенчмарке Roboflow для визуально-языковых моделей: детекция, подсчёт, OCR и извлечение данных, а сам бенчмарк компания обещает выложить в ближайшие недели. В майском тесте GPT-5.5 та же команда называла модель инструментом анализа, а не источником точных координат рамок, и советовала размечать ею данные, а детекцию в работающей системе оставлять небольшим специализированным моделям вроде RF-DETR или YOLO. Теперь Sol, по её оценке, лучшая из выпущенных OpenAI моделей для работы с изображениями, а детекция у GPT-5.6 из серьёзной слабости стала практической возможностью. Terra и Luna отстают от Sol ненамного: 44,7 и 43,3 mAP@50.
Одна из самых заметных сильных сторон GPT-5.6 - поиск элементов на странице документа: заголовки, абзацы, таблицы, изображения и подписи Sol находила хорошо, а с этого шага многие документные пайплайны начинаются перед OCR и извлечением данных. На плотных сценах, где похожие объекты лежат вплотную, как таблетки и яйца в тестовых примерах, Sol нашла большую часть объектов. Для визуально-языковых моделей такие сцены - частое слабое место: в отличие от классических детекторов, они выписывают метку и координаты каждого объекта текстом, и с ростом числа объектов ответ удлиняется, а риск пропусков, дублей и ошибок в координатах растёт.
Как просить рамки
Формат XYXY - это x и y левого верхнего угла рамки, затем правого нижнего, в пикселях исходного изображения. Gemini 3.5 Flash в тех же тестах давала лучший результат с порядком YXYX и координатами, нормированными к диапазону от 0 до 1 000. Если пайплайн писали под Gemini, формат в запросе при переходе на GPT-5.6 придётся поменять.
В нескольких случаях Sol ставила рамки в местах, которые выглядели случайными: многие совсем или почти не пересекались с эталонной разметкой и складывались в неестественные фигуры вроде ровных рядов и равномерно расставленных групп вместо видимых объектов. Roboflow передала примеры в OpenAI, и там подтвердили, что на изображениях около 2 000 на 2 000 пикселей и крупнее Sol становится менее стабильной, особенно на низком уровне рассуждений.
Более высокий уровень рассуждений стабильность повышает, но вместе с ним растут расход токенов, задержка и цена. Самый практичный обход - уменьшить или обрезать большое изображение до отправки в API OpenAI.
Счёт и текст
Подсчёт объектов вырос у всей линейки: Sol набрала 73,0% против 64,9% у GPT-5.5, Terra 67,6%, Luna 66,2%, и Luna, самая дешёвая модель в линейке, всё равно выше прежнего уровня OpenAI. Sol посчитала сильно перекрывающиеся металлические кронштейны и пробоины от пуль только внутри выбранных зон мишени. Блистеры дались намного тяжелее: пустые ячейки и оставшиеся в упаковке таблетки модель считала отдельными запросами, и обе задачи осложняли повторяющаяся раскладка, блики и мелкие различия между полными и пустыми ячейками.
В OCR, где модель переписывает весь видимый текст, Sol держится рядом с GPT-5.5: 90,7% средней схожести против 91,2%, у Terra и Luna 88,8% и 88,4%. В извлечении, где нужен конкретный фрагмент, Sol даже отступила: 82,5% против 87,6% у GPT-5.5, Luna и Terra набрали 81,4% и 79,4%. Рукописные заметки она разобрала в обоих режимах, а размер шины прочитала по изогнутому боку грязной изношенной покрышки. Срок годности на блистере Sol прочитать не смогла: текст был мелкий, вертикальный, низкоконтрастный и с бликами, что может объяснять ошибку.
Сколько стоит картинка
За прирост в зрении платят токенами: их расход вырос у всей линейки GPT-5.6, и на больших объёмах это напрямую поднимает стоимость обработки. Sol тратила в среднем около 10 секунд на изображение, Terra около 6, Luna чуть больше 5. Дороже Sol в бенчмарке обходилась только Claude Fable 5, Terra стоила около 1 цента за изображение, Luna меньше 0,5 цента.
Лучший баланс задержки и качества в линейке, по оценке Roboflow, у Luna: по скорости она близка к Gemini 3.5 Flash и при этом обходит GPT-5.5 в детекции и подсчёте объектов.
Дальше
65,1% расходов через Vercel AI Gateway у Anthropic
Токены Anthropic в июле стоили в 4,4 раза дороже среднего по всем лабораториям, и при этом на неё пришлось 65,1% расходов через Vercel AI Gateway при 30% объёма всех токенов.
Читайте также
- Сохранение рассуждений подняло ARC-AGI-3 с 13,3% до 38,3%
- Sol переписала ядра OpenAI и срезала 20% стоимости
- Haiku 5.5 заметила утечку, которую пропустил GPT-6.1 Sol
- Fable 5.2 обошлась в 13,39 доллара против 3,99 у Astra
- Opus 5.5 обошёл GPT-6 Astra в тесте на стабильность
- GPT-6 Astra набрала 66,7% против 43,8% у GPT-5.6 Sol
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.