
Промпт в 16 символов весит 0,3% запроса Codex
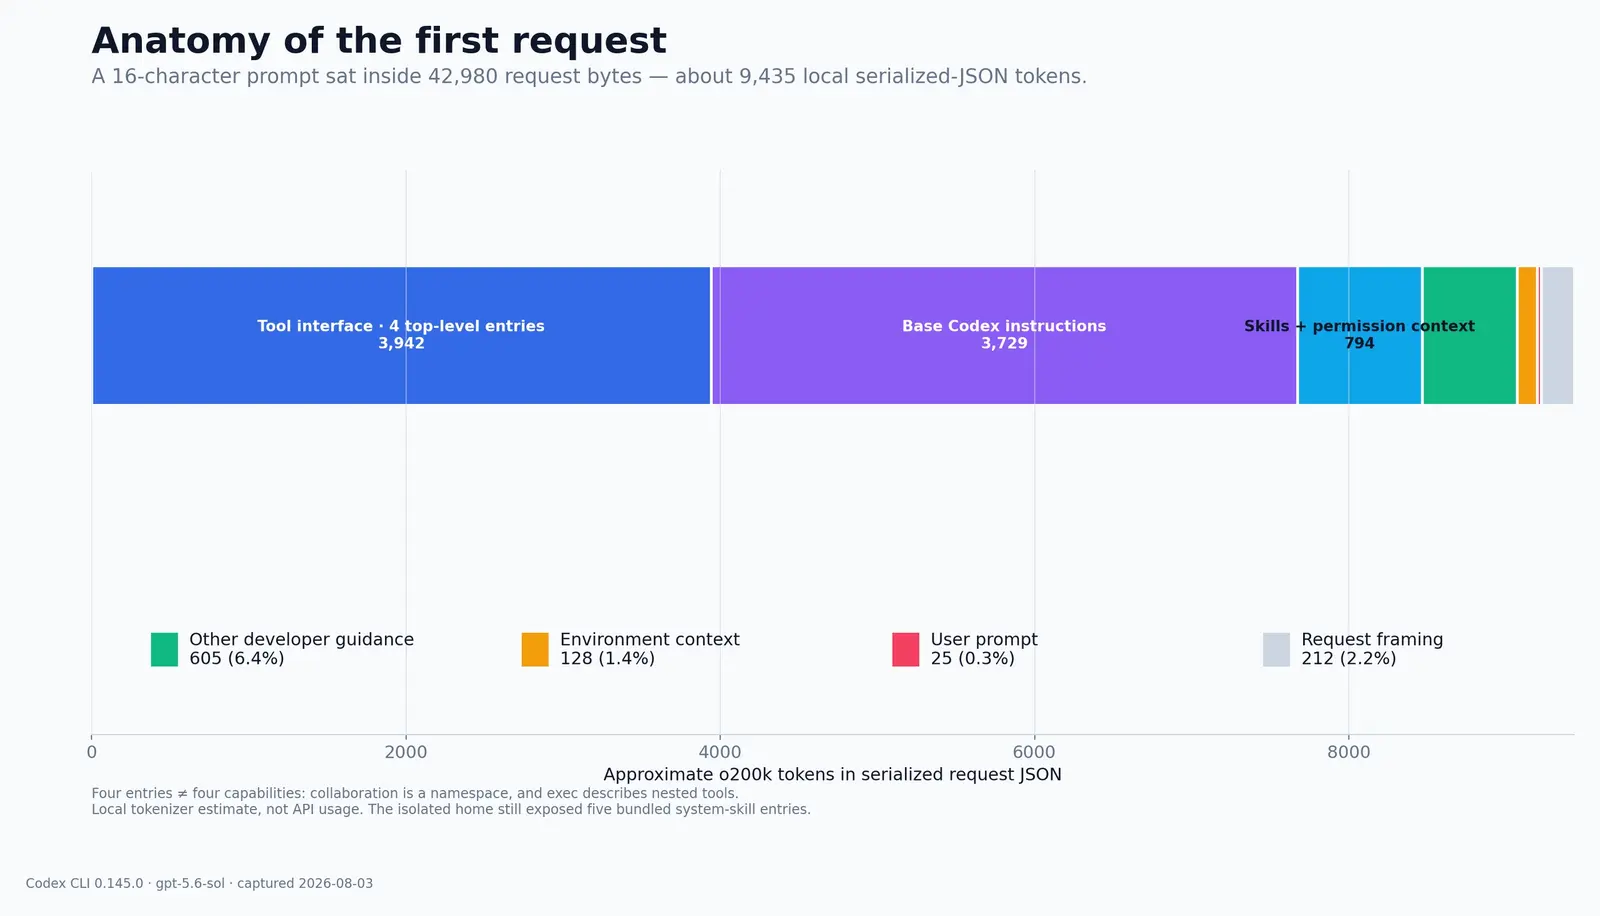
Автор блога 0xkato записал запросы, которые Codex CLI отправляет модели, и разобрал их по частям в посте в блоге 0xkato от 4 августа. В ответ на промпт «Reply with pong.» длиной 16 символов клиент отправил тело запроса в 42 980 байт, это около 9 435 токенов. Сам промпт вместе с обёрткой занял из них всего около 25 токенов, 0,3%.
Остальное Codex добавляет сам: инструкции, описания инструментов, права доступа, метаданные скиллов, контекст окружения и служебную разметку запроса. Дальше автор шаг за шагом смотрел, как запрос растёт, когда агент подгружает AGENTS.md, получает инструменты MCP, читает файлы, запускает команды, принимает картинки и сжимает историю. По этим трассировкам видно, какие данные уходят с машины сразу, а какие только после конкретного действия.
Как записывали запросы
Codex поддерживает собственные провайдеры моделей. 0xkato направил клиент на локальный HTTP-сервер, который сохранял каждый запрос, вычищал чувствительные заголовки и возвращал фиксированный фейковый ответ. Внешняя модель в эксперименте не вызывалась. Рекордер, очищенные тела запросов, файлы анализа и тесты автор выложил вместе с постом.
Мерили две величины: точный размер JSON-тела в байтах до очистки и примерное число токенов, полученное локальной кодировкой очищенного JSON токенизатором o200k_base. Автор отдельно оговаривает, что токены здесь оценка: ни реального расхода по API, ни биллинга рекордер не показывает. Не видно и того, что провайдер мог бы сделать с запросом после получения и какая часть попала бы в кеш. Тесты шли на Codex CLI 0.145.0 с моделью gpt-5.6-sol. Позже, 29 сентября, вышла версия 0.159.1, где моделью по умолчанию стала GPT-6.1 Sol.
Базовую точку автор снимал в пустом временном Git-репозитории, с отключёнными инструкциями проекта и переменной CODEX_HOME, указывающей на пустую папку. Даже так запрос описывал пять встроенных системных скиллов, поэтому 0xkato называет эту точку базой изолированного окружения, а не минимально возможным запросом.
Из чего состоят 9 435 токенов
Три элемента дали 7 696 токенов. Крупнейший из них - developer-элемент additional_tools с четырьмя верхнеуровневыми записями инструментов: 16 741 символ, около 3 942 токенов. Следом идёт developer-сообщение с основными инструкциями Codex: 17 730 символов текста и около 3 729 токенов. Сообщение пользователя заняло 16 символов и 25 токенов.
Четыре записи называются exec, wait, request_user_input и пространство имён collaboration, но действий за ними больше четырёх. В collaboration шесть подынструментов, а exec описывает выполнение команд, наложение патчей, просмотр изображений, обновление плана и другие вложенные инструменты. Ещё одна деталь формата: в этом прогоне Codex положил описания инструментов и базовые инструкции внутрь массива input, а верхнеуровневые поля instructions и tools не использовал.
AGENTS.md, скиллы и MCP
Цепочку инструкций проекта Codex собирает от корня репозитория до папки, в которой его запустили. На каждом уровне он ищет AGENTS.md и ставит инструкции, более близкие к папке запуска, позже. Автор создал AGENTS.md в корне и в дочерней папке, по 100 уникальных маркеров в каждом. При запуске из корня в запрос ушли все 100 корневых маркеров и ни одного дочернего, при запуске из дочерней папки ушли все 200. Если запустить Codex в корне и потом выполнить ls child, дочерние инструкции не добавляются. Автоматическую цепочку определяет папка запуска, хотя явное чтение дочернего файла всё равно добавит его содержимое в историю как обычный вывод инструмента.
Инструкции передаются целиком. В трассировке из двух запросов с 250 маркерами все 250 были в обоих. 250 синтетических маркеров добавили к первому запросу 5 947 байт и около 2 530 токенов, 1 000 маркеров добавили 24 197 байт и около 11 030 токенов, и запрос вырос до 20 465 токенов. Автор предупреждает, что это не стоимость вашего собственного AGENTS.md. Маркеры вида PAIRED_AGENTS_1000_0001 специально высокоэнтропийные, o200k_base режет каждый на 11 токенов, а слова обычной прозы так не дробятся.
Скиллы из .agents/skills/ грузятся в два этапа. Сначала в запрос попадают только имя, описание и путь, тело SKILL.md появляется лишь после того, как его прочитали. Каждый тестовый скилл имел описание из 12 слов и тело из 200 слов. Один такой скилл добавил к первому запросу 481 байт и около 125 токенов, десять скиллов дали 4 810 байт и около 1 250 токенов. Ни одного маркера из тел скиллов в первых запросах не нашлось.
Описания инструментов MCP Codex тоже откладывает. С одним локальным сервером на три инструмента и с двумя серверами на семь инструментов первые запросы весили одинаково: 46 582 байта и около 10 410 токенов. Ни имён, ни описаний пользовательских инструментов в них не было, только общая инструкция по поиску MCP-инструментов внутри exec. Когда сервер отключали, запрос возвращался к базе. Описания появлялись после того, как exec выводил найденные отложенные записи, и дальше оставались в истории:
- один сервер, три инструмента по 40 маркеров: плюс 5 894 байта и около 1 522 токенов;
- два сервера, семь инструментов (три по 40 маркеров, четыре по 60): плюс 15 970 байт и около 4 210 токенов;
- один сервер с разрешённым списком из одного инструмента: плюс 2 288 байт и около 578 токенов.
Отдельно автор проверил описание инструмента на 5 000 маркеров. Codex его обрезал, оставив начало и конец, но и в этом фрагменте сохранились 1 046 маркеров, а следующий запрос вырос на 40 607 байт и около 9 631 токена.
Что попадает в историю после действий
Для задачи на исправление кода автор собрал маленький проект на Python с ошибкой в конфигурации: явное значение false подменялось пользовательским значением по умолчанию. Codex должен был исправить приоритет, добавить регрессионный тест и прогнать тесты. Действия агента были заданы заранее, так что трассировка показывает рост запроса, а не рассуждения модели. За девять шагов (поиск, чтение файлов, тесты, падение регрессии, исправление, проверка диффа) запрос вырос с 9 815 до 11 889 токенов, на 8 200 байт. Результаты поиска, содержимое файлов, падение теста, патч и итоговый дифф оставались доступны всем последующим ходам. В реальной сессии, как предупреждает автор, на каждом ходу переносится больше, чем в этих трассировках.
Репозиторий Codex автоматически не выгружает. Автор положил пять безобидных файлов с маркерами: обычный исходник, файл из .gitignore, фейковый .env, игнорируемый лог на 20 000 строк и файл, упомянутый в AGENTS.md. В первом запросе не оказалось содержимого ни одного из них. Команда rg --files -uu добавила только имена файлов. Но после явного чтения обычный файл, игнорируемый файл, фейковый .env и большой лог ушли в последующие запросы, и .gitignore ни одно такое чтение не остановил. Лог перед следующим запросом урезали до начала и конца, но запрос всё равно вырос с 10 418 до 20 350 токенов.
С выводом терминала то же самое. Результаты на 10 и 100 строк дошли до следующих запросов дословно. Вывод на 10 000 строк обрезали до начала и конца, но запрос вырос с 43 337 байт и примерно 9 584 токенов до 88 480 байт и 25 835 токенов. Повторяющийся вывод не дедуплицировался, текст с ANSI-разметкой и трейсбек упавшего Python-скрипта тоже остались в истории.
Картинки уходят как data URL с base64 внутри. Синтетический PNG 32×32 превратился в строку data:image/png;base64,… длиной 442 символа. Крупный PNG с градиентом Codex перед отправкой уменьшил и перекодировал: 71 666 символов data URL при декодировании дали PNG 1600×1600. Тела запросов весили 43 955 байт с маленькой картинкой, 115 265 байт с большой и 115 886 байт с обеими. Токены для картинок автор не оценивал: локальная токенизация base64 как текста не имеет отношения к тому, как считаются изображения.
До первого вызова инструмента с машины уходят инструкции Codex, видимые интерфейсы инструментов, найденная цепочка AGENTS.md, метаданные скиллов, контекст окружения и сам промпт. Содержимое файлов, вывод команд, описания MCP и картинки появляются только после чтения, запуска, поиска или прикрепления. Непрочитанные файлы репозитория, игнорируемые файлы и фейковый .env сами по себе в запросы не попали.
Как Codex сжимает историю
Когда история становится слишком большой, Codex прогоняет её через ещё один запрос к модели, заменяет пересказом и продолжает работу. С OpenAI или Azure для этого есть отдельный эндпоинт, а с собственным провайдером вроде рекордера клиент собирает запрос на пересказ сам. Этот путь 0xkato и записал. Сжатие он вызвал искусственно, сообщив клиенту 13 000 входных токенов при окне контекста в 20 000 и пороге сжатия в 12 000 токенов.
Получилось три запроса. Исходный весил 42 030 байт, около 9 378 токенов, и содержал обычные инструменты и запрос пользователя. Запрос на сжатие весил 68 375 байт и около 21 408 токенов: накопленная история, крупный результат инструмента и промпт для пересказа, а список инструментов был пуст. Возобновлённый запрос весил 42 646 байт и около 9 500 токенов. В нём вернулись обычные инструменты и исходное сообщение пользователя, а сырой вызов инструмента с его выводом заменил пересказ.
Возобновлённый запрос оказался на 25 729 байт и примерно 11 908 токенов меньше запроса на сжатие. Пересказ в эксперименте был нарочно коротким, поэтому трассировка показывает механику замены, а о качестве пересказа, который написала бы настоящая модель, ничего не говорит.
После сжатия деталь из исходного сообщения или вывода инструмента может дожить до следующих ходов только в виде пересказа.
Дальше
100% на 28 задачах и 0,28 доллара за круг
Одна обвязка, 28 реальных задач, 17 моделей подряд: открытая glm-5.3 закрыла все пять категорий на 100% и стоила 0,28 доллара за круг, около пятой части от цены gpt-5.5. Ценой 16,3 секунды до первого токена.
Читайте также
- Юристы и рекрутеры OpenAI сами перешли на Codex
- Агентский цикл Codex можно встроить в своё приложение
- SDK для Codex на Python и TypeScript устроены по-разному
- Слепок памяти выдаёт токен и выпускает Codex из песочницы
- Тот же результат, вдвое дороже: Claude Code против Codex
- Новый бэкенд Git в OpenAI ускорил пуши почти в 5 раз
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.