
Claude Code 2.1.243 показывает расход по циклам /loop
Claude Code 2.1.243 подгоняет учёт расходов под реальный счёт. В /model и во встроенном навыке claude-api цена Sonnet 5 в 2 доллара за миллион входных токенов и 10 долларов за миллион выходных теперь значится стандартной прайсовой, а не временной промо-акцией. Организации получили настройку, которая подставляет в /cost их договорные ставки.
Релиз вышел 24 августа, полный перечень изменений лежит в заметках к релизу на GitHub. Кроме денег, там есть разбивка /usage по циклам /loop, раздельное время жизни кеша для основного диалога и субагентов и нативный бинарник, который ужали в четыре с лишним раза.
Четыре релиза за пять дней
Расходы в Claude Code правят уже не первый релиз подряд:
- 20 августа: 2.1.237 чинит кеширование промптов в сессиях через LLM-шлюз или собственный base URL и добавляет стиль вывода Concise.
- 21 августа: 2.1.238 вводит настройку keybindingFlavor, заголовки для маркетплейсов плагинов и флаги для self-hosted-runner.
- 22 августа: 2.1.239 включает наценку 1,1× за инференс только в США в оценки /cost, строки статуса и
--max-budget-usdдля воркспейсов с резидентностью данных. - 24 августа: 2.1.243 добавляет modelPricing, раздельный TTL кеша и разбивку по циклам в /usage.
В 2.1.239 наценка ложилась поверх прайс-листа. Управляемая настройка modelPricing меняет саму базу расчёта: администратор задаёт договорные ставки по моделям и множитель скидки, и /cost, строка статуса и стоимость в телеметрии считаются по ним вместо прайса. Раз настройка управляемая, её раздаёт организация, а не каждый разработчик у себя.
Куда уходят токены
В /usage появился раздел Loops. По каждому циклу /loop там видно число запусков, суммарные токены, токены на один запуск и время последнего запуска. Задача, которая просыпается слишком часто или тратит на каждое пробуждение лишнее, видна сразу. Заодно терминал стал тише: подряд идущие пробуждения, на которых Claude нечего делать, сворачиваются в одну строку.
Настройки promptCacheTtl и subagentPromptCacheTtl рассчитаны на тех, кто работает по API-ключу или через облачного провайдера. Кеш промптов хранит уже обработанный префикс диалога, и повторная отправка того же контекста обходится дешевле, пока запись жива. Теперь основной диалог может держать кеш час, а субагенты остаются на пяти минутах. Длинную сессию с паузами на чтение кода такой кеш, судя по всему, переживает, а короткоживущие субагенты не держат часовые записи зря.
Видно и то, на чём работали субагенты: /tasks и карточки агентов показывают модель и уровень effort каждого. Поля rate_limits в строке статуса и /usage перестали показывать процент использования из прошлого окна лимитов, если окно сбросилось, пока сессия простаивала. А modelPicker собирает собственный упорядоченный список моделей с подписями в /model, принимает id в любом написании, включая Vertex и Bedrock, и дописывается к встроенному набору или заменяет его.
Вход без API-ключа
В /login → Anthropic Console рядом с созданием ключа появился пункт «Sign in with your Console account», и он помечен как рекомендуемый. Его адресовали организациям, где API-ключи запрещены. Для администраторов есть ещё три мелочи: строка Skipped sources в /status перечисляет источники управляемых настроек вроде managed-settings.json, которые лежат на диске, но не применяются из-за источника с более высоким приоритетом; в /mcp и /plugins коннекторы claude.ai, чью авторизацию ведёт организация, получили отметку managed; телеметрия сессий с ANTHROPIC_AUTH_TOKEN напрямую к Anthropic API теперь привязывается к организации, так что на неё распространяются её правила обработки данных.
В CI починили федерацию workload identity. Процессы одного джоба делят уже обменянный токен, а не пытаются заново обменять одноразовый, а отклонённый обмен сразу падает с сообщением сервера.
Легче на 265 МБ
Нативный бинарник теперь сжат zstd: на Linux x64 установка и автообновление скачивают около 75 МБ вместо 340 МБ. Ещё около 2 МБ сэкономили на более компактном хранении встроенных навыков и промптов. Код нативных сборок подгружается по требованию, а не держится в памяти целиком, и сессия занимает примерно на 40-70 МБ меньше. В долгих сессиях сборщик мусора срабатывает раньше по мере роста кучи. Старт тоже ускорили: поднятие песочницы и MCP-серверов больше не задерживает первый кадр.
Из исправлений надёжности два заметнее остальных. Удалённые MCP-серверы в неинтерактивном режиме -p и в SDK после обрыва связи раньше не восстанавливались, теперь они переподключаются сами или помечаются как упавшие. Сессии, которые молчали по 10 минут и дольше, когда API так и не начинал ответ, теперь ждут около трёх минут, повторяют запрос один раз и показывают API Error: No response from API. Ошибки авторизации, доступности модели и прочие сообщения, которые генерирует сам клиент, наконец выводятся строками ошибок, а не текстом в стиле ответа модели.
Что придётся переделать
Флаг --agents на невалидном JSON или кривом определении агента теперь завершается с понятной ошибкой, как --mcp-config, а не игнорирует его молча. Промпт песочного Bash перестал перечислять разрешённые сетевые хосты: Claude пробует запрос, а вы одобряете новый хост, вместо того чтобы модель заранее считала неперечисленные хосты закрытыми. На macOS клик по рабочему столу, Dock или окну Finder в режиме computer use требует выдать доступ Finder через диалог, как любому другому приложению. На Bedrock, Vertex и Foundry, а также при выключенной телеметрии /model, /fast и /effort срабатывают сразу и не ждут конца хода.
Условия if в хуках вида Bash(cat *) раньше срабатывали на посторонние команды, если в них была подстановка через $() или обратные кавычки и после неё шли ещё аргументы. Это исправили.
Сокет входящих сообщений для обмена между сессиями теперь закрывает соединение, если за 30 секунд по нему не пришло ни одной полной строки. Скрипты, которые туда пишут, должны подключаться, когда данные уже готовы.
Дальше
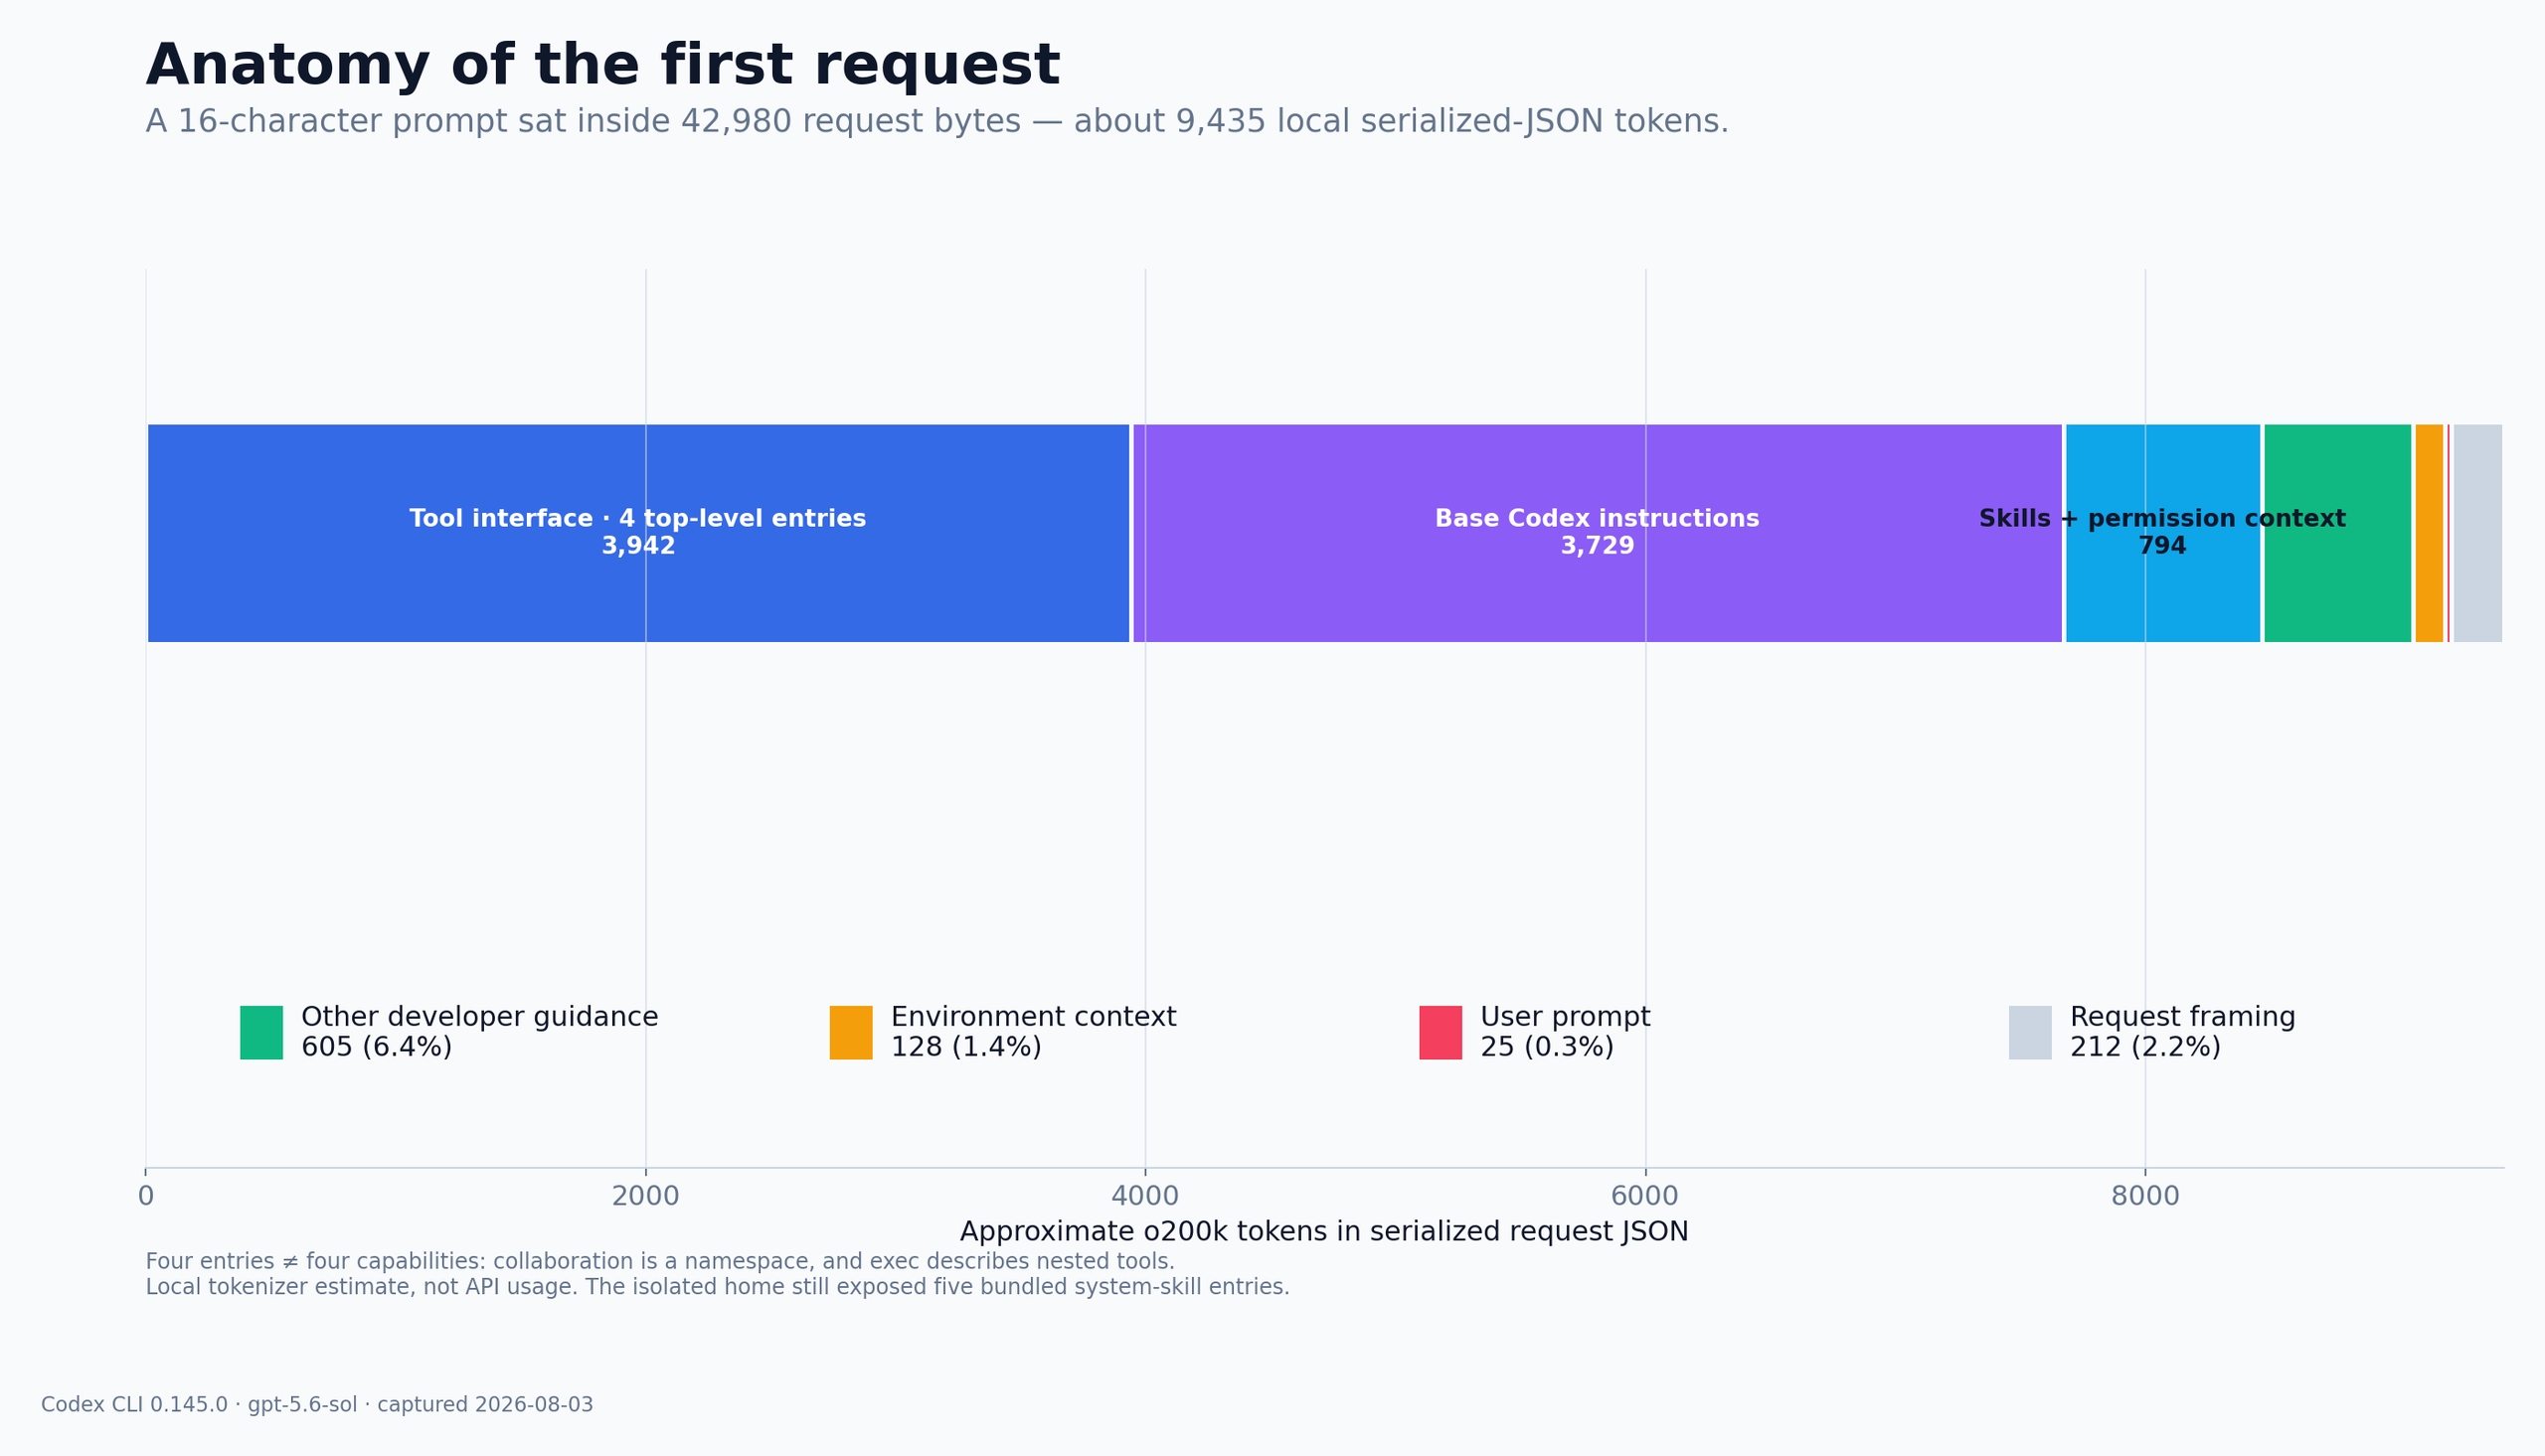
Промпт в 16 символов весит 0,3% запроса Codex
Промпт из 16 символов дал запрос на 42 980 байт, и сам текст занял в нём около 0,3%. Остальное набрали инструкции Codex и описания инструментов, показал эксперимент с локальным рекордером запросов.
Читайте также
- Claude Code 2.1.248: режим --restricted
- Claude Code 2.1.246: предупреждение о звёздочке в Bash
- Claude Code 2.1.239 считает наценку за резидентность данных
- В Claude Code 2.1.237 появился стиль вывода «Concise»
- pxpipe прячет текст в PNG и режет расходы на токены до 70%
- CCLimitPing: автопродление 5-часового окна лимитов Claude Code
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.