
openai
Свои модели вывели чип OpenAI на 88,94% потолка за 40 часов
Promtime
 openai
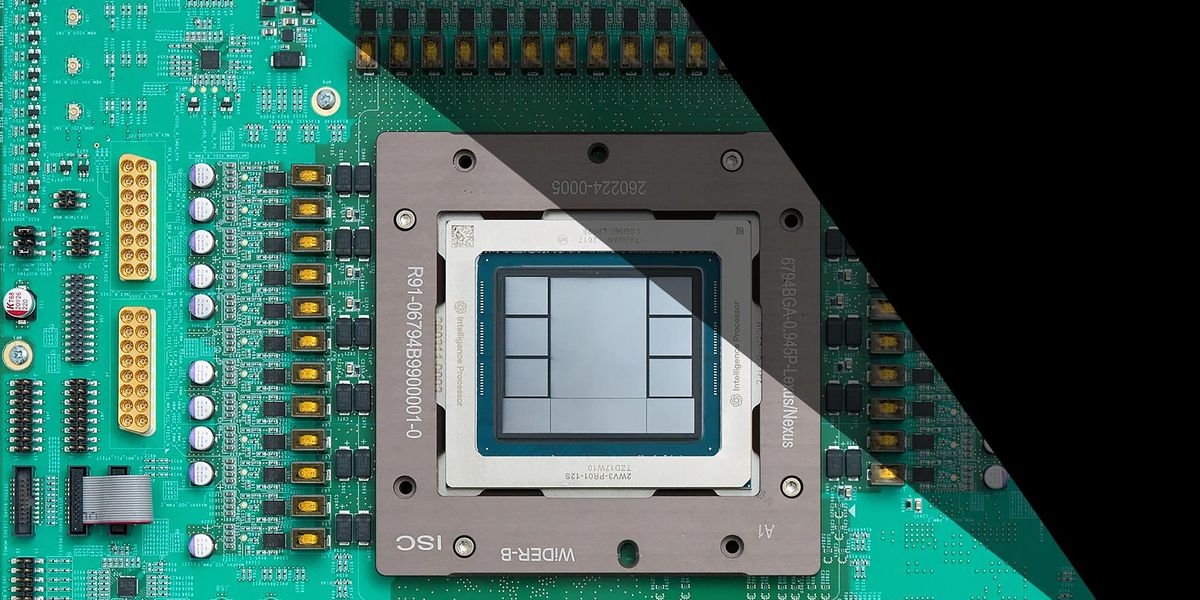
За примерно 40 часов внутренние модели OpenAI подняли результат на бенчмарке ядра multi-head latent attention от DeepSeek с 0,31% теоретического потолка до 88,94%. Речь про Jalapeño, первый собственный ИИ-ускоритель компании, который полностью показали 25 августа; о том, как его проектировали, в OpenAI рассказали IEEE Spectrum.
Коротко
- От первой концепции архитектуры до первого кремния Jalapeño прошёл меньше чем за 20 месяцев, от первого RTL до тапаута за девять, а команда в среднем держалась меньше 100 человек.
- Передний край маршрута собрали вокруг открытого XLS: инженер пишет на DSLX или C++, XLS переводит написанное в Verilog, и модели работают с кодом, который выглядит как обычный софт.
- Бэкенд отдали Broadcom, внутренние модели, дообученные под проектирование чипов, OpenAI не называет, а цифры производительности идут из бенчмарков, на которые ссылается сама компания.
Если вы не следили: проект стартовал в октябре 2024 года, партнёром по кремнию стал Broadcom, а инференс OpenAI сейчас крутится в том числе на Nvidia GB300, с которым Jalapeño и сравнивают. Ричард Хо, вице-президент по железу в OpenAI, в теме давно: в 2016 году он, ещё инженер Google, выступал с докладом на воркшопе IEEE Design Automation Futures и уже тогда считал срок разработки чипа функцией от числа итераций, которые команда успевает сделать за день.
13,4 петафлопса в 4 битах и до 3,6x по задержке против GB300
Jalapeño выдаёт до 13,4 петафлопса четырёхбитных вычислений и работает с 232 гигабайтами самой передовой из доступных сегодня памяти на скорости 15,4 терабайта в секунду. Чип рассчитан на поды по 2048 штук.
По бенчмаркам, на которые ссылается OpenAI, Jalapeño сокращает сквозную задержку, то есть время от промпта до последнего токена, до 3,6 раза по сравнению с Nvidia GB300, и при этом потребляет меньше энергии. Как эти цифры поведут себя, когда чип массово встанет в парк инференса компании, пока вопрос открытый, и в OpenAI это признают.
Девять месяцев от первого RTL до тапаута и команда меньше 100 человек
RTL, register-transfer level, это код, задающий логику чипа; тапаут — момент, когда готовый дизайн уходит на производство. Между этими двумя точками у команды Jalapeño прошло девять месяцев. Хо говорит, что группа в среднем была меньше 100 человек и примерно столько же насчитывает сейчас, когда занимается вторым и третьим поколениями. В это число входят системный дизайн, софт и снабжение, но не люди Broadcom.
Разделение труда шло по линии «дизайн против реализации»: OpenAI отвечала за сквозную архитектуру системы, включая сам ускоритель, иерархию памяти и сеть, Broadcom взял физический дизайн начиная с вентилей. Дэвид Чин, сооснователь стартапа агентного проектирования чипов Verkor.io, называет график «вполне правдоподобным», но считает, что без Broadcom он был бы невозможен: начни кто-то с нуля, так не получится. Его сооснователь Рави Кришна назвал скорость «относительно впечатляющим результатом». Профессор UC San Diego Эндрю Кан считает её «вероятно, лучшей в классе на сегодня».
Почему модели пустили через XLS, а не сразу в Verilog
XLS, Accelerated Hardware Synthesis, это открытый набор инструментов высокоуровневого синтеза, начатый в Google. Инженер описывает логику на DSLX, языке в духе Rust, или на C++, а XLS сам переводит описание в Verilog. Крис Лири из OpenAI говорит, что ИИ заметно лучше справлялся с тем, что похоже на софт, а XLS как раз похож на софт; сам Лири и запустил этот проект, когда работал в Google.
Работает это как компилятор: вы пишете на привычном языке, а низкоуровневые инструкции получаются сами. Анкур Шривастава из Университета Мэриленда напоминает, что автоматизация в проектировании чипов существует десятилетиями, и новизна моделей в другом: они понимают язык и код, поэтому хороши там, где задача ещё «в лингвистической области». Кан согласен, что ускорять высокоуровневый синтез логично: с ним модели работать естественнее, а итерации быстрее.
По ходу проекта менялись и модели. Начинали с помощью o3, публично вышедшей в апреле 2025 года, а заканчивали на предшественниках GPT-6 Astra, которую выпустили 3 сентября 2026-го. Эти модели пишут Verilog напрямую, без перевода через XLS, и, по словам Лири, близки к тому, чтобы самостоятельно управлять проприетарными инструментами проектирования.
Бэкенд ушёл Broadcom, но 10% площади у матричных блоков отыграли
Бэкенд — это разводка межсоединений, тактовые и питающие спецификации, подготовка данных для фабрики. Основную его часть вёл Broadcom, но физические дизайнеры OpenAI работали со своими коллегами там и подсказывали по флорплану и разводке. На IEEE Hot Chips 2026 Хо и Лири привели цифру: оптимизация физического дизайна с участием ИИ дала 10% сокращения площади матричных блоков относительно оптимизированной человеческой базовой линии.
Broadcom при этом шёл по своему внутреннему маршруту и доступа к внутренним моделям OpenAI не имел, только к публичным коммерческим. Рави Кришна из Verkor.io считает подход OpenAI к бэкенду консервативным и связывает это со сроками проекта: по его словам, модели заметно подтянулись за последние четыре-пять месяцев, а с апреля 2026 года начали справляться с такими задачами лучше. Его сооснователь Суреш Кришна добавляет, что агентный цикл мог бы ускорить и бэкенд.
На наш взгляд, самая слабая точка истории в том, что главный инструмент остался неназванным: Хо подтвердил внутренние модели, дообученные под проектирование чипов, но от деталей отказался, так что повторить маршрут по описанию нельзя. Первые кристаллы вернулись с фабрики в мае, и софт под бенчмарки вроде InferenceX от SemiAnalysis писали уже модели, а Хо говорит, что результат воспроизводим и все плановые допущения теперь строятся на этом. Сами же он и Лири настаивают, что полной автоматизации не будет: собрать фронтирный ускоритель одним лишь Codex у постороннего не выйдет.
Что закладывают во второе поколение
Хо говорит, что в маршрут второго чипа ИИ вводят «во многих местах», прежде всего в верификации и физическом дизайне, а Лири называет второе поколение возможностью перенастроить всё с нуля. У команды уже есть инструменты автоматической работы с временными диаграммами, которые ищут тактовые сигналы, связанные со сбоями. Сроков по второму и третьему поколениям OpenAI не называет; обещано другое: Astra и следующие модели, по словам Хо, будут очень хороши в проектировании чипов.
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.
Из Google мы используем только имя и аватар. Почту не сохраняем.