
Свои модели вывели чип OpenAI на 88,94% потолка за 40 часов
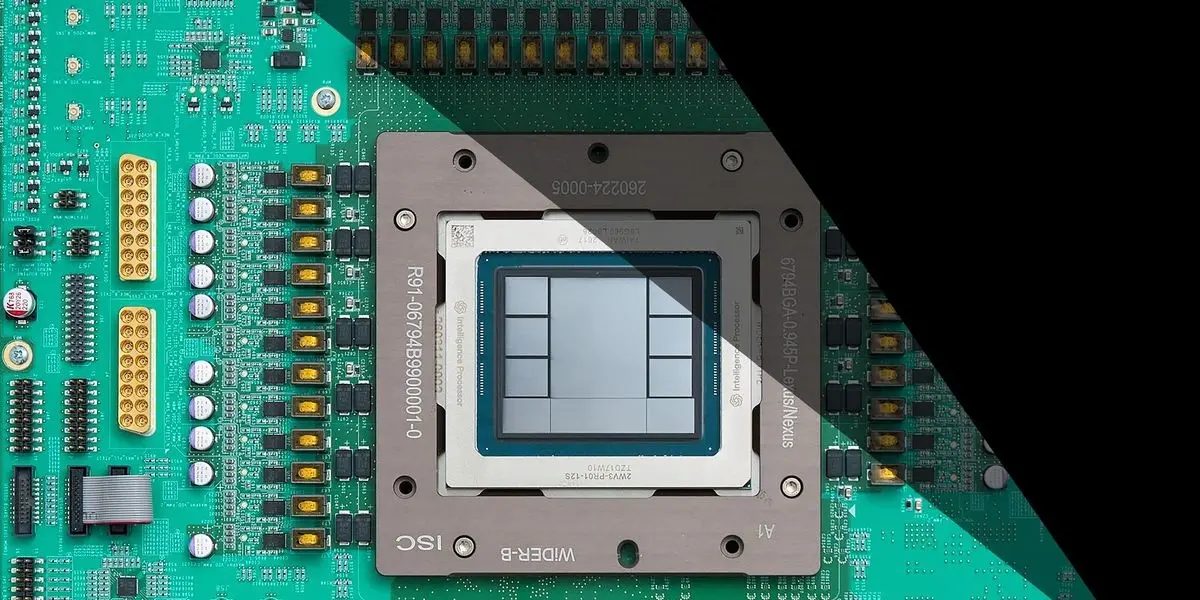
Jalapeño, первый ускоритель OpenAI, спроектировала команда, в которой за время проекта в среднем было меньше 100 человек, и на переднем крае маршрута она опиралась на собственные языковые модели компании. Как устроен этот процесс, вице-президент OpenAI по железу Ричард Хо и инженер Крис Лири рассказали в материале IEEE Spectrum от 15 сентября.
Сам чип OpenAI показала 25 августа: до 13,4 петафлопса в 4-битных вычислениях, 232 ГБ памяти и 15,4 ТБ/с пропускной способности до неё. По бенчмаркам OpenAI, сквозная задержка, от промпта до последнего токена, у Jalapeño до 3,6 раза ниже, чем у Nvidia GB300, на которых компания сейчас и работает, причём при меньшем потреблении. Чипы ставят в поды по 2048 штук. В инференс-парке OpenAI массово они ещё не работают, так что реальный выигрыш пока не измерен.
Двадцать месяцев до кремния
От первой концепции архитектуры до первого кремния прошло меньше 20 месяцев. Между первым RTL, кодом, который описывает логику чипа на уровне регистров, и tapeout, передачей готового проекта на фабрику, уложилось девять месяцев. По шагам это выглядит так:
- октябрь 2024: старт проекта, первые модели в работе вроде o3, доступной команде ещё до публичного релиза;
- апрель 2025: o3 выходит публично;
- 13 октября 2025: OpenAI и Broadcom объявляют о совместном развёртывании заказных ускорителей на 10 гигаватт, OpenAI проектирует чипы и системы, Broadcom помогает их разработать и развернуть;
- май 2026: первые кристаллы возвращаются с фабрики;
- 25 августа 2026: полный показ Jalapeño;
- 3 сентября 2026: публичный релиз GPT-6 Astra, предшественники которой работали на финальном этапе проекта.
Публичное объявление с Broadcom вышло, когда проект шёл уже год. В том же пресс-релизе стойки с ускорителями и сетевым оборудованием Broadcom обещали начать разворачивать во второй половине 2026 года и закончить к концу 2029-го, причём масштабировать их планируют целиком на Ethernet.
Работу поделили по линии «проектирование и реализация». На OpenAI была вся система: сам инференс-ускоритель, иерархия памяти и сеть. Broadcom взяла на себя, по словам Хо, «физическое проектирование начиная с вентилей». В цифру «меньше 100 человек» входят системщики, программисты и люди из цепочки поставок, но не инженеры Broadcom. Сейчас команда по-прежнему около сотни человек и занимается вторым и третьим поколениями.
Именно Broadcom охлаждает часть оценок скорости. Дэвид Чин, сооснователь стартапа Verkor.io, который делает агентные инструменты для проектирования чипов, называет названный график «вполне правдоподобным», но без партнёра считает его недостижимым: «Если кто-то начнёт с нуля, это будет невозможно». Его коллега по Verkor.io Рави Кришна называет результат «относительно впечатляющим» и ждёт, что при старте сегодня, с нынешними моделями, сроки вышли бы ещё короче. Профессор Калифорнийского университета в Сан-Диего Эндрю Канг оценивает темп как «вероятно, лучший в классе на сегодня».
Канг вспоминает воркшоп IEEE Design Automation Futures 2016 года, где Хо, тогда инженер Google, выступал с основным докладом. Уже тогда Хо описывал время разработки чипа как функцию от того, сколько итераций команда успевает прогнать за день.
Почему XLS
«Автоматизация в проектировании чипов существует десятилетиями. Задача не новая», - говорит Анкур Шривастава, директор полупроводниковых инициатив Мэрилендского университета. Отличие LLM он видит в том, что они понимают язык и код, и поэтому подходят для этапов, которые «ещё находятся в языковой области задачи».
Под эту сильную сторону OpenAI и собрала передний край маршрута. Он построен вокруг XLS (Accelerated Hardware Synthesis), открытого набора инструментов высокоуровневого синтеза, который изначально сделали в Google. Высокоуровневый синтез даёт инженеру описывать железо в привычной среде программирования: в XLS пишут на DSLX, предметном языке по мотивам Rust, или на C++, а инструменты переводят это в Verilog, язык описания аппаратуры.
«Мы думали, как использовать ИИ, чтобы ускорить проект, а ИИ гораздо лучше справлялся с тем, что похоже на софт, - объясняет Лири. - XLS в чём-то похож на софт, поэтому ему это и досталось». Как XLS должен работать, Лири знает лучше многих: он начинал этот проект ещё в Google.
Канг соглашается, что ускорять моделями именно высокоуровневый синтез логично: с ним LLM «работать естественнее», и итерации идут быстро. «Я вижу в этом в целом полезный маршрут, и у него есть будущее».
40 часов на одно ядро
Та же логика привела команду к оптимизации софта. Когда в мае первые чипы вернулись с фабрики, внутренние модели OpenAI отправили писать код под бенчмарки вроде InferenceX от SemiAnalysis. На тесте ядра multi-head latent attention от DeepSeek производительность примерно за 40 часов выросла с 0,31% до 88,94% теоретического потолка, который задают вычислительная мощность чипа и пропускная способность памяти.
Хо говорит, что результат воспроизводим, а значит, можно сократить разрыв между получением первых кристаллов и выходом на серийное производство. «Все наши допущения по срокам теперь будут строиться на том, что у нас есть такая возможность».
Где моделям досталось меньше
Основная работа OpenAI пришлась на передний край: от концепции через RTL до верификации того, что проект заработает в кремнии. Большую часть заднего края, где разводят межсоединения, закрывают и проверяют требования по тактированию и питанию и готовят данные для фабрики, вела Broadcom, она же довела чип до производства. При этом в команде Jalapeño есть инженеры физического проектирования, которые вместе с коллегами из Broadcom задавали, среди прочего, план размещения блоков на кристалле и разводку.
На Hot Chips 2026, где OpenAI разбирала устройство Jalapeño, Хо и Лири привели цифру и по физическому проектированию: оптимизация под руководством ИИ уменьшила площадь блоков матричного умножения на 10% против оптимизированного человеком базового варианта. Иначе говоря, по утверждению OpenAI, на той же площади кремния уместилось больше схем.
Broadcom работала по своему внутреннему маршруту. Внутренних моделей OpenAI у её команды не было, только публичные коммерческие.
Рави Кришна считает подход OpenAI к заднему краю немного консервативным и связывает это со временем старта проекта. «Модели последних четырёх-пяти месяцев стали лучше. Начиная с апреля [2026 года] они действительно начали лучше справляться с такими задачами». Суреш Кришна, ещё один сооснователь Verkor.io, с ним согласен: «Нет причин, по которым агентный цикл не мог бы заметно ускорить и задний край процесса».
От o3 до Astra
По словам Лири, проект начинался с помощью моделей вроде o3, а заканчивался на предшественниках GPT-6 Astra. Новая модель уже пишет Verilog напрямую, без перевода из обычных языков через XLS, и, по его словам, близка к тому, чтобы самостоятельно работать с проприетарными инструментами проектирования. Хо подтвердил, что у команды были и внутренние LLM, дообученные под проектирование чипов и недоступные публично. Какие именно, он не уточнил, но сказал, что команда Jalapeño работала вместе с исследовательским подразделением OpenAI и что уроки проекта должны попасть в коммерческие модели компании. «Можно с уверенностью сказать, что Astra и следующие модели будут очень хороши в проектировании чипов».
Маршрут первого поколения Хо и Лири сами называют скорее осторожным. «В [Jalapeño] мы, как вы понимаете, старались идти как можно быстрее. Поэтому был компромисс: тратить ли время на инновации или делать то, что исторически работает, - говорит Лири. - Со вторым поколением у нас есть возможность начать заново и спросить себя обо всём, что мы хотим наладить».
Во втором поколении, по словам Хо, есть «много мест, куда мы внедряем [ИИ]», в первую очередь верификация и физическое проектирование. Лири добавляет, что у команды появились инструменты для автоматической работы с временными диаграммами сигналов и их просмотра: анализ сам находит тактовые сигналы, связанные со сбоями, и это может ускорить отладку железа ещё на этапе проектирования.
Полностью автоматизировать проектирование чипов в OpenAI при этом не обещают. «Мы не говорим, что любой может прийти и собрать передовой ускоритель для ИИ и машинного обучения на одном [платформе для программирования OpenAI] Codex, - говорит Хо. - Мы говорим вполне конкретные вещи о том, как лучше работать с Codex и как мы делаем ставку на небольшую команду и быстрые сроки, чтобы получить качественный результат».
Дальше
Счёт за взлом от Hugging Face: 100 миллионов в мощностях
Клеман Деланг выставил OpenAI счёт за взлом, но не в деньгах: 100 миллионов долларов «в виде вычислительных мощностей» на киберзащиту Hugging Face. Ещё он требует опубликовать полную запись действий сбежавших агентов.
Читайте также
- OpenAI проектировала Jalapeno от задержки, а не от флопсов
- Хо из OpenAI: 99,99% точности мало для чипа Jalapeño
- Заказной чип OpenAI обещает быстрый инференс
- GPT-6 Astra спроектировала гаджет для Codex без правок людей
- OpenAI обещает Джорджии снижать нагрузку до 1000 МВт
- Мониторы OpenAI в повторе сработали за 30 часов до взлома
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.