
Предшественник архитектуры Qwen4 вышел как 125B MoE
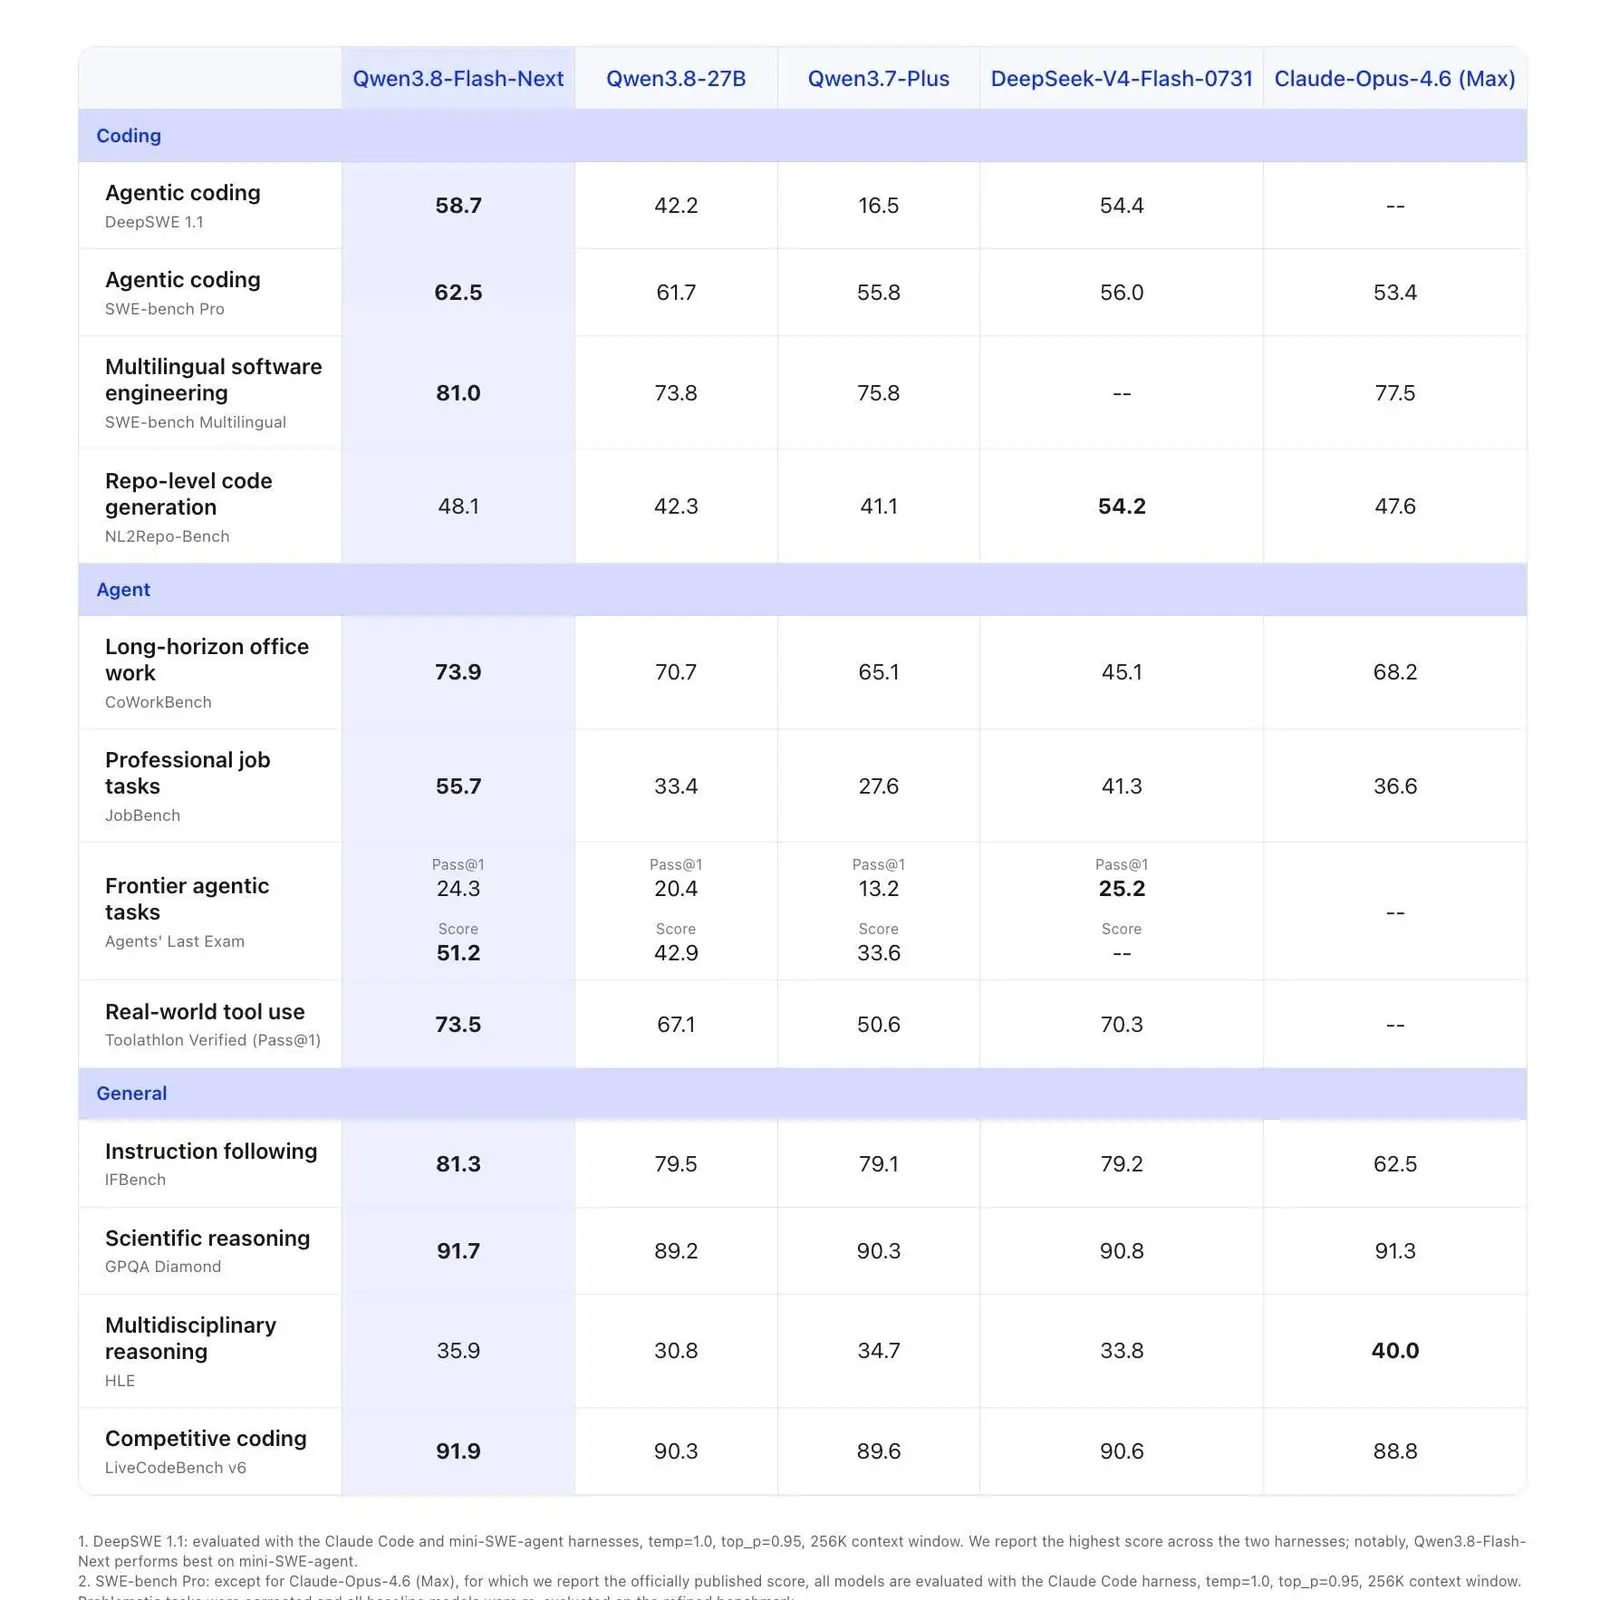
Alibaba выпустила мультимодальную модель Qwen3.8-Flash-Next с архитектурой Mixture-of-Experts и 125 млрд параметров; релиз получил нативное контекстное окно на 262 тысячи токенов и поддержку расширения до 1 млн токенов через YaRN.
О выпуске Alibaba сообщила в Threads, а карточка модели опубликована на Hugging Face. В описании Qwen3.8 Flash названа предшественником архитектуры, которая будет использоваться в Qwen4.
Коротко
- В карточке модели указаны мультимодальный режим и архитектура Mixture-of-Experts, где для обработки запроса активируется часть из 125 млрд параметров.
- Нативный контекст Qwen3.8 Flash составляет 262 тысячи токенов, а метод YaRN расширяет его до 1 млн токенов при работе с длинными входами.
- В QwenCloud API миллион входных токенов стоит $0,16, миллион выходных $0,47, а модель получила 58,7 на DeepSWE 1.1 и 62,5 на SWE-bench Pro.
Релиз выглядит как попытка Alibaba одновременно продвинуть новую архитектурную линию и сохранить низкий порог для её практического использования. Большое контекстное окно снижает необходимость разбивать длинные материалы на части, а цена API делает модель заметной для систем, где стоимость вывода напрямую влияет на архитектуру продукта.
Qwen3.8 Flash получила 125 млрд параметров в архитектуре Mixture-of-Experts
Mixture-of-Experts распределяет обработку между специализированными блоками, поэтому общий размер модели не означает, что все параметры участвуют в каждом отдельном вычислении. В случае Qwen3.8 Flash Alibaba указывает общий объём в 125 млрд параметров и одновременно относит модель к мультимодальным системам, работающим с несколькими типами входных данных.
Модель построена на новой архитектуре, которую Alibaba описывает как основу для Qwen4. Поэтому Qwen3.8 Flash имеет значение не только как отдельный выпуск с заданными характеристиками, но и как ранняя публичная реализация следующего архитектурного направления Qwen. Релиз последовал за открытыми весами Qwen3.8-27B.
Нативный контекст модели составляет 262 тысячи токенов и расширяется до 1 млн
Qwen3.8 Flash поддерживает нативное контекстное окно в 262 тысячи токенов. Контекстное окно определяет объём текста и других данных, который модель может учитывать в рамках одного запроса, поэтому этот параметр относится к работе с крупными входами, а не к размеру самой модели.
С помощью YaRN контекст можно расширить до 1 млн токенов. В карточке Qwen3.8-Flash-Next это указано как возможность расширения поверх нативного окна. Источник не сообщает о дополнительных ограничениях такого режима, поэтому сравнивать его с базовой конфигурацией по качеству или скорости нельзя.
Qwen3.8 Flash набрала 58,7 на DeepSWE 1.1 и 62,5 на SWE-bench Pro
На DeepSWE 1.1 модель получила 58,7 балла, а на SWE-bench Pro её результат составил 62,5 балла. Оба теста относятся к оценке способностей моделей в задачах программирования и агентной работе с кодом, но приведённые значения относятся к разным бенчмаркам и не образуют единую шкалу.
Доступ к Qwen3.8 Flash через QwenCloud API стоит $0,16 за 1 млн входных токенов и $0,47 за 1 млн выходных токенов. Такое разделение тарифов учитывает разные объёмы вычислений на чтение и генерацию, однако исходные данные не содержат условий для сравнения этой цены с другими режимами развёртывания модели.
Архитектура перед Qwen4
Alibaba уже связала Qwen3.8 Flash с архитектурой Qwen4, но отдельные сроки выхода Qwen4 в исходных материалах не указаны. Текущий релиз доступен как самостоятельная модель с карточкой на Hugging Face и API-доступом через QwenCloud, а заявленные цены и результаты дают ориентиры для ранних интеграций.
Дальше
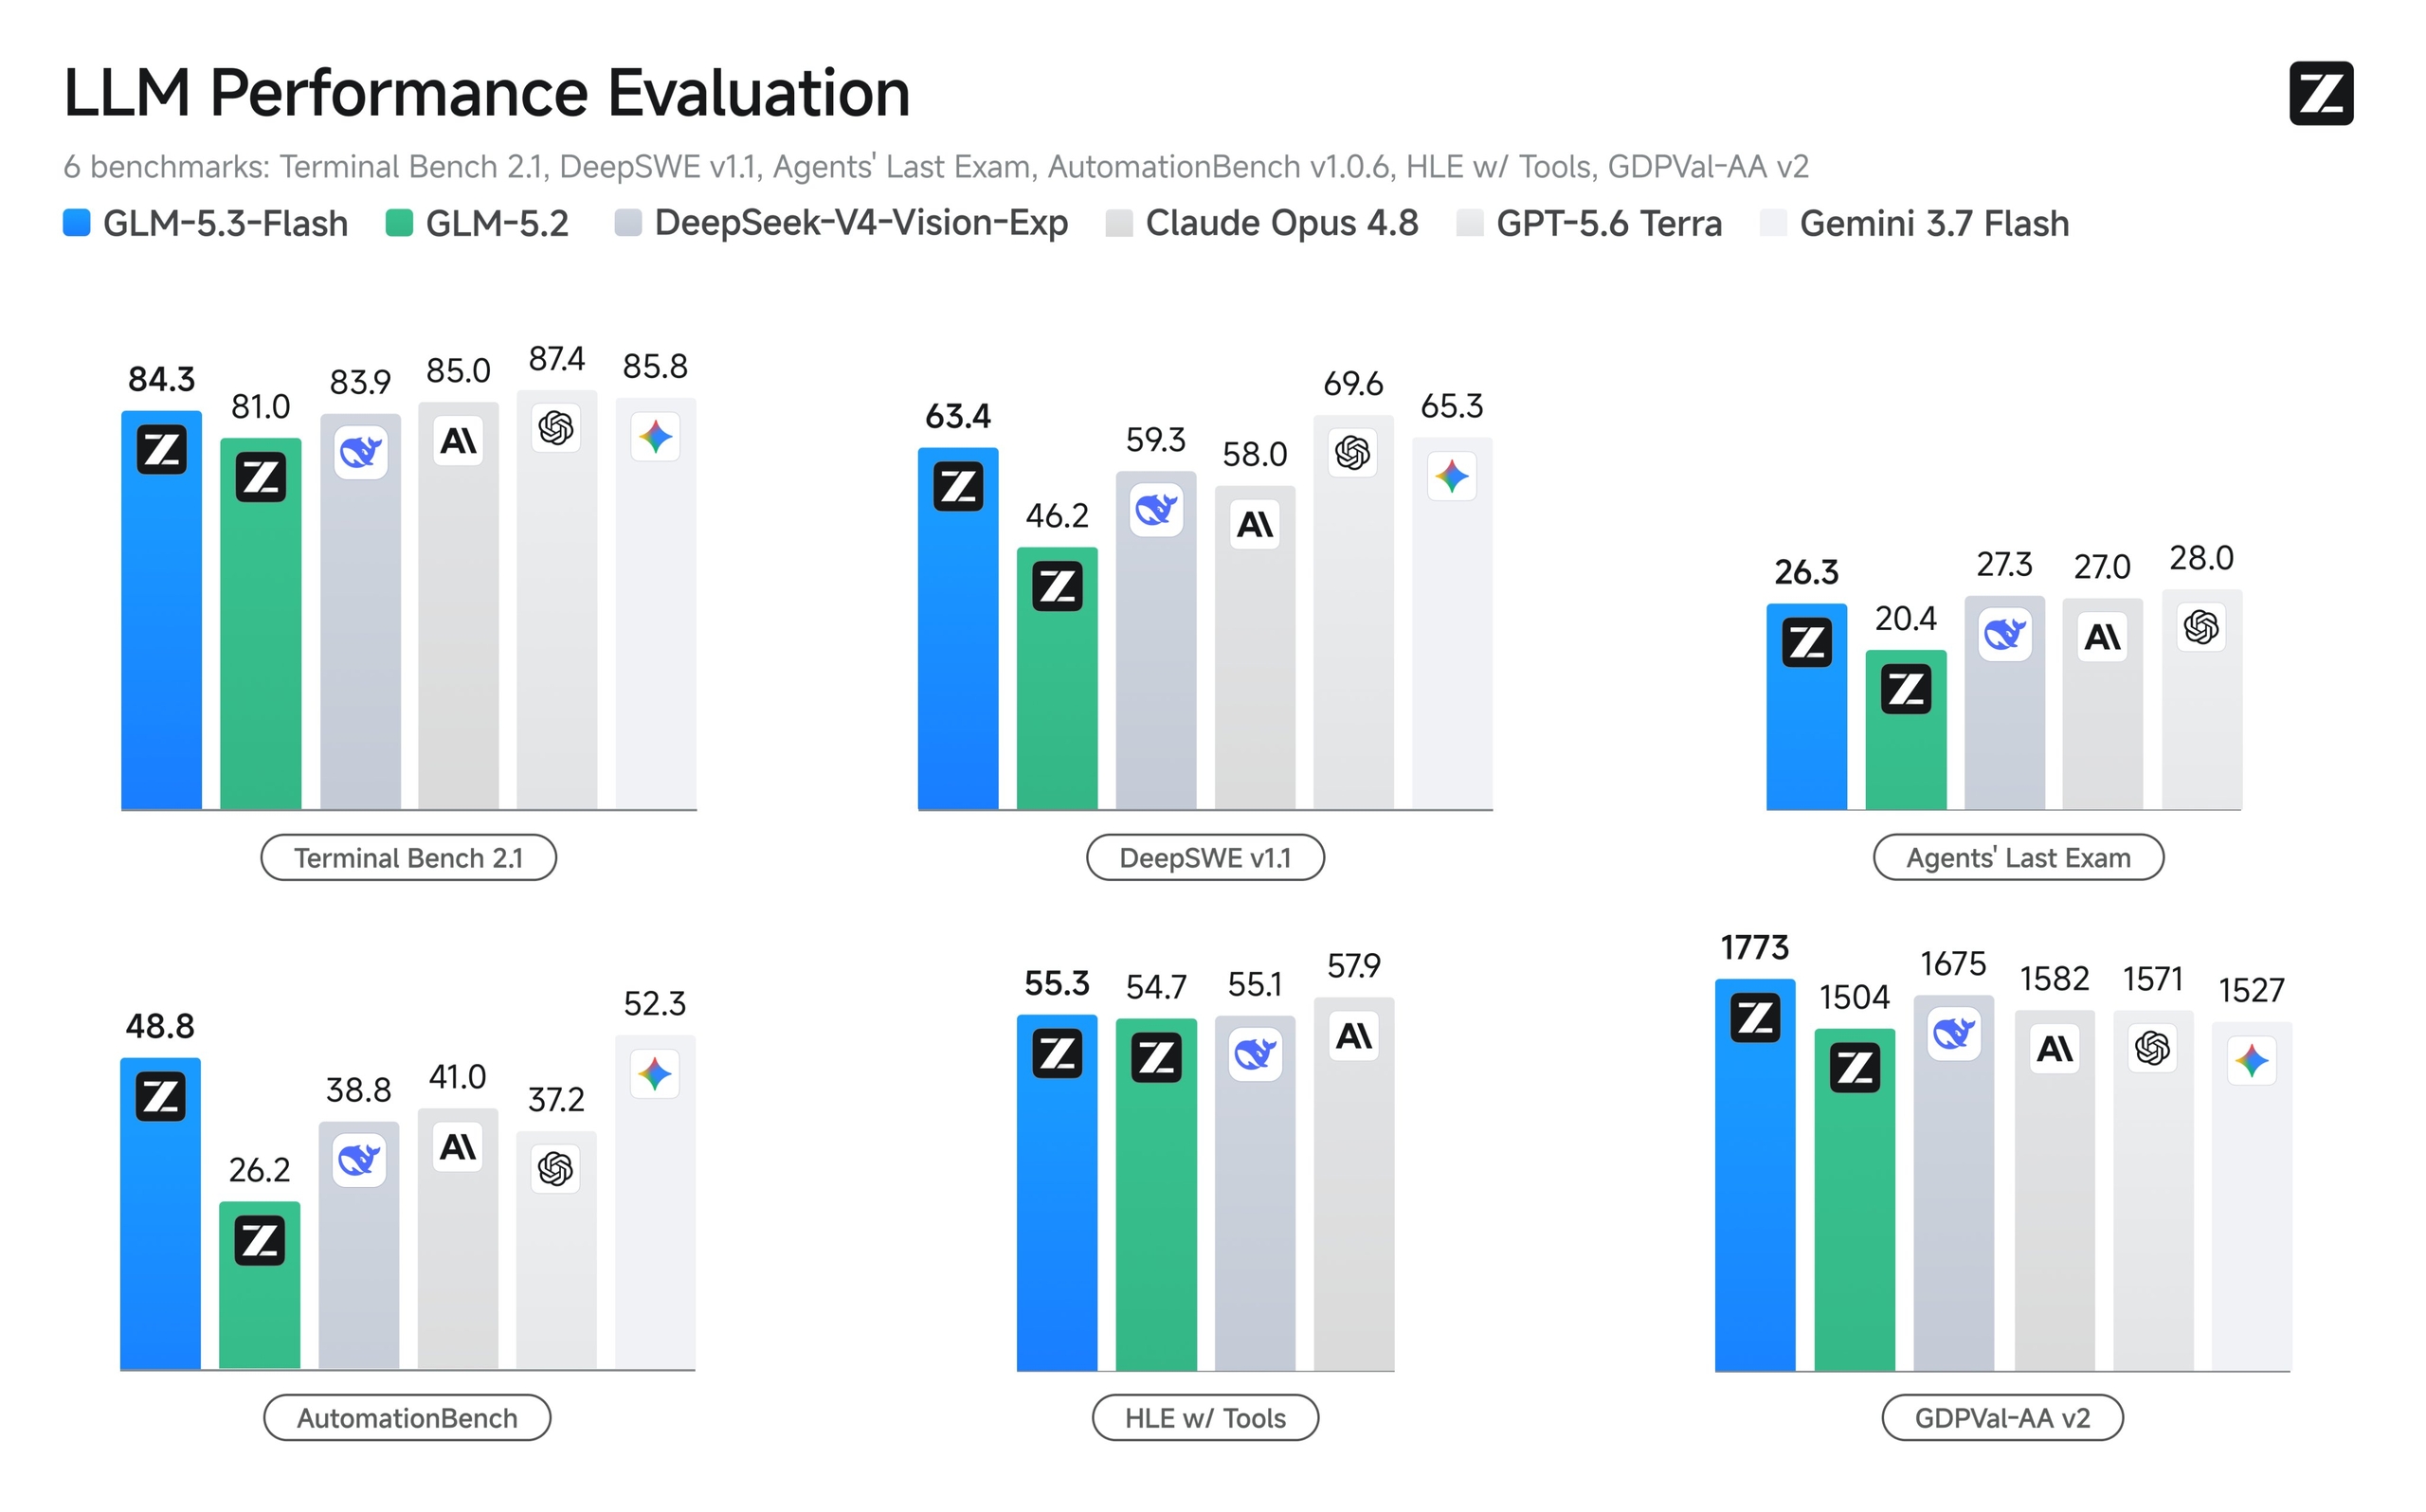
Стелс-модель Ox Alpha связывают с семейством GLM-5.3
Kingy AI отмечает, что название Flash официально никто не подтверждал, но техника сходится: стелс-модель Ox Alpha с OpenRouter выложена на Hugging Face как GLM-5.3-Flash, мультимодальная 320B-A18B под лицензией MIT.
Читайте также
- Qwen3.8-Omni-Flash слушает звук и смотрит видео
- Открытые веса как раннее превью архитектуры Qwen4
- Локальная Qwen3.8-27B вышла с контекстом 262K
- Веса Qwen3.8-27B обещают открыть на следующей неделе
- У LFM2.5 от Liquid AI из 24B параметров работают 2B
- Mistral Large 4 обошла GLM-5.3 на DeepSWE, пишет VentureBeat
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.