
У LFM2.5 от Liquid AI из 24B параметров работают 2B
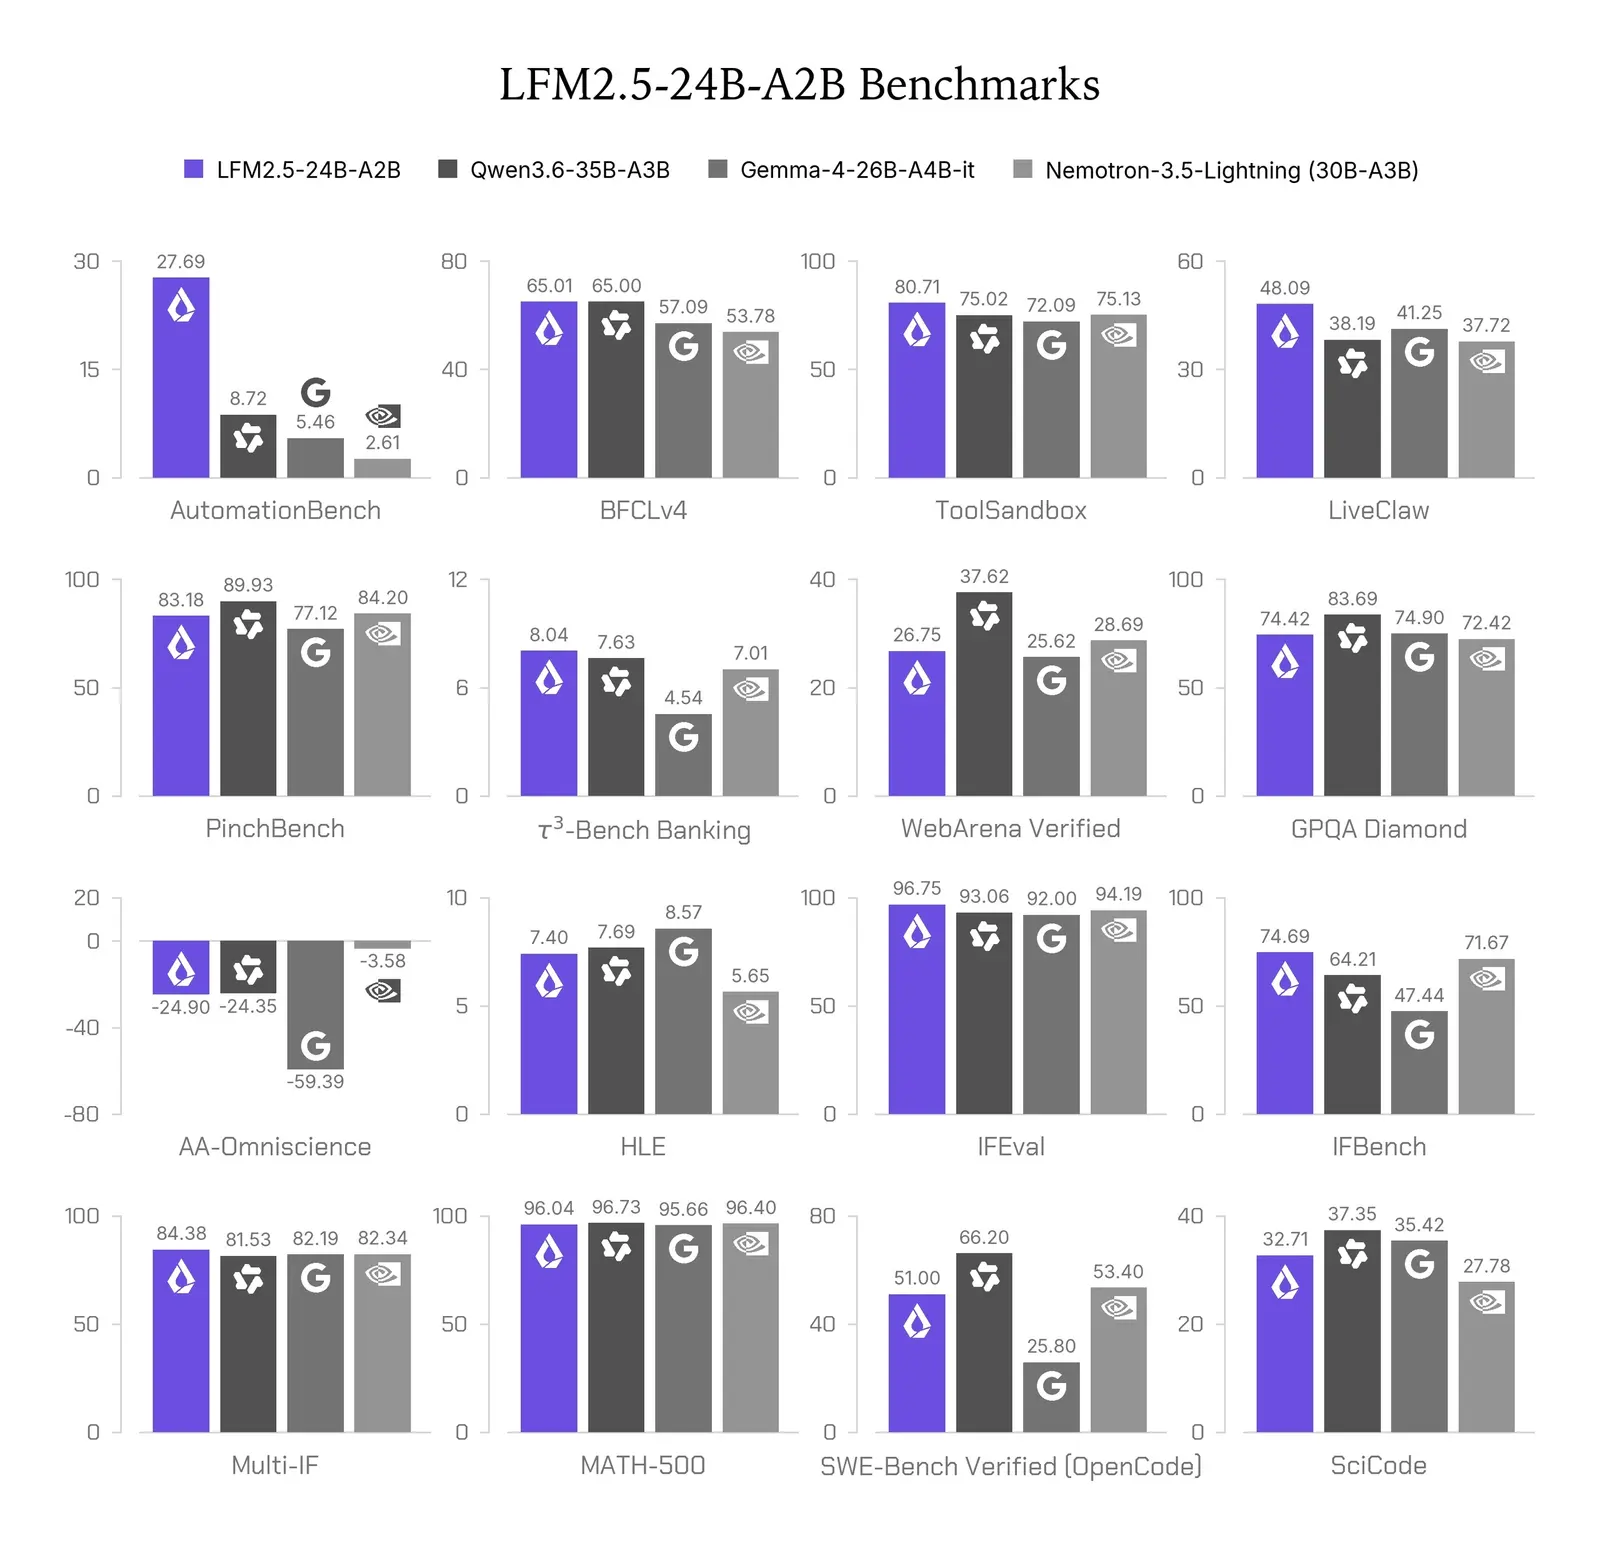
По данным Liquid AI, у LFM2.5-24B-A2B из 24 миллиардов параметров на каждый токен работают около 2,45 миллиарда, и при этом на агентском тесте LiveClaw она обходит Qwen3.6-35B-A3B, у которой общих и активных параметров примерно наполовину больше. Модель описана в карточке Liquid AI на Hugging Face как рассуждающая модель для быстрых и приватных агентов прямо на устройстве.
Коротко
- Liquid AI выложила на Hugging Face открытые веса LFM2.5-24B-A2B, самой крупной и последней модели семейства LFM2.5, которое теперь тянется от 230 миллионов до 24 миллиардов параметров.
- Модель устроена как смесь экспертов: в каждом блоке 64 эксперта, на токен выбираются четыре; в llama.cpp на Apple M5 Max с квантованием Q4_K_M и контекстом 4K она выдаёт 184 токена в секунду.
- Слабое место Liquid AI называет сама: для задач на знания модель в одиночку не рекомендуют, а в таблице компании Qwen3.6-35B-A3B заметно впереди на SWE-Bench Verified и GPQA Diamond.
Если вы не следили: Liquid AI выросла из лаборатории MIT CSAIL и строит модели LFM на архитектуре, которая происходит от так называемых жидких нейросетей, а не от классического стека трансформера. Семейство LFM2.5 стартовало 5 января 2026 года с моделей на 1,2B, а до нынешнего релиза его MoE-вариантом была LFM2.5-8B-A1B от 28 мая 2026 года. По данным Learn AI, первые LFM, включая MoE-модель LFM-40B, вышли в сентябре 2024 года.
На LiveClaw LFM2.5-24B-A2B набрала 48,09 против 38,19 у Qwen3.6-35B-A3B
Liquid AI сравнила модель с тремя MoE-конкурентами на 16 бенчмарках: Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it и Nemotron-3.5-Lightning (30B-A3B). Все модели запускали через vLLM. На LiveClaw, где температура стояла на 1,0, а ответ ограничивался 8 192 токенами, LFM2.5 получила 48,09 при 38,19 у Qwen, 41,25 у Gemma и 37,72 у Nemotron.
На AutomationBench разрыв с Qwen ещё заметнее: 27,69 против 8,72. В следовании инструкциям модель тоже сильна: IFEval 96,75 против 93,06 у Qwen, IFBench 74,69 против 64,21. На BFCLv4 счёт почти равный, 65,01 против 65,00, а на ToolSandbox 80,71 против 75,02.
На SWE-Bench Verified Qwen3.6-35B-A3B впереди: 66,20 против 51,00
Таблица при этом не односторонняя. На SWE-Bench Verified в связке с OpenCode у LFM2.5 51,00, у Qwen3.6-35B-A3B 66,20. На GPQA Diamond 74,42 против 83,69, на WebArena Verified 26,75 против 37,62, на PinchBench 83,18 против 89,93, на SciCode 32,71 против 37,35. На MATH-500 модели почти вровень: 96,04 и 96,73.
Ограничение Liquid AI проговаривает сама. Компания советует брать модель для агентов, которые рассуждают, вызывают инструменты и надёжно работают на вашем устройстве. Для задач, завязанных на знания, её рекомендуют дополнять поиском по документам или веб-поиском, где как раз пригодится сильная сторона модели в вызове инструментов.
На Apple M5 Max модель выдаёт 184 токена в секунду
Скорость на устройствах Liquid AI мерила на своей инфраструктуре Pipette через llama.cpp, с квантованием Q4_K_M и входным контекстом 4K токенов. В таких условиях LFM2.5-24B-A2B выдаёт 184 токена в секунду на Apple M5 Max и 114 на AMD Ryzen AI Max+ 395. По данным компании, она до 1,7 раза быстрее следующей модели из сравнения и занимает меньше всех памяти.
На сервере масштаб другой: больше 21 тысячи выходных токенов в секунду на одной NVIDIA B300 при высокой параллельной нагрузке. Замер шёл в SGLang 0.5.22 с весами BF16, 1 024 входными токенами и не более 256 выходных на запрос, причём завершённые запросы сразу заменялись новыми.
Вариантов весов несколько: исходный чекпойнт для Transformers, vLLM и SGLang, FP8 для серверов, GGUF для llama.cpp, ONNX для кроссплатформенного запуска и MLX в 4 битах для Mac. Для дообучения есть отдельная базовая LFM2.5-24B-A2B-Base.
Предобучение выросло примерно с 17 до 33 триллионов токенов
Всего на обучение ушло 36 триллионов токенов. Предобучение заняло около 33 триллионов против примерно 17 у LFM2-24B-A2B. Затем шло промежуточное обучение: 2 триллиона токенов с контекстом 32K на отобранных данных с упором на рассуждения, математику, код, инструкции и многоязычные тексты, потом 300 миллиардов токенов длинного контекста на 131K.
Пост-обучение включало обучение с учителем, специализацию моделей-учителей, две стадии дистилляции on-policy, неагентскую и агентскую, и обучение с подкреплением внутри агентских обвязок OpenClaw, Hermes Agent, Pi и OpenCode. По словам Liquid AI, так модель выучила их инструменты, системные промпты и манеру взаимодействия.
Из 40 слоёв LFM2.5-24B-A2B внимание стоит только в 10
В каждом MoE-блоке 64 эксперта, то есть небольших подсетей, и маршрутизатор для каждого токена выбирает четыре из них. Остальные в этот момент не считают ничего, поэтому на токен работают около 2,45 миллиарда параметров из 24. Похоже на большую поликлинику: пациента принимают четыре профильных врача, остальной штат занят своим. Хранить в памяти при этом приходится все веса.
Сами слои тоже разные. 30 из 40 устроены как короткие свёртки с двойным гейтингом: каждая смотрит лишь на несколько соседних токенов и обходится дёшево. Ещё 10 используют grouped-query attention, которое видит весь контекст. Архитектура та же, что у LFM2-24B-A2B; изменились окно контекста, выросшее с 32K до 131K токенов, и словарь, удвоенный с 65K до 128K ради лучшей токенизации нелатинских языков.
Модель всегда рассуждает перед ответом: шаблон чата сам вставляет тег <think>, чего у LFM2-24B-A2B не было. Инструменты она по умолчанию вызывает списком вызовов на Python между служебными токенами, а JSON можно попросить в системном промпте. Среди 16 поддерживаемых языков есть русский.
Все цифры здесь из карточки самой Liquid AI: и бенчмарки, и скорость измерены компанией, а про память сказано только, что модели нужно меньше всех, без конкретных гигабайт. На наш взгляд, режим «всегда думать» для модели под устройство имеет оборотную сторону: каждый токен рассуждения дешёвый, но сколько их уходит на ответ, карточка не сообщает. И 2B активных параметров, судя по всему, не отменяют того, что в памяти придётся держать все 24B.
Когда появится черновик DSpark
В списке форматов остаётся DSpark, черновая модель для спекулятивного декодирования в SGLang: маленькая сеть быстро предлагает несколько токенов, а большая проверяет их разом. Пока она помечена как «coming soon», и дата не называется. Новых размеров в LFM2.5 ждать не стоит: Liquid AI называет 24B-A2B финальной моделью семейства.
Дальше
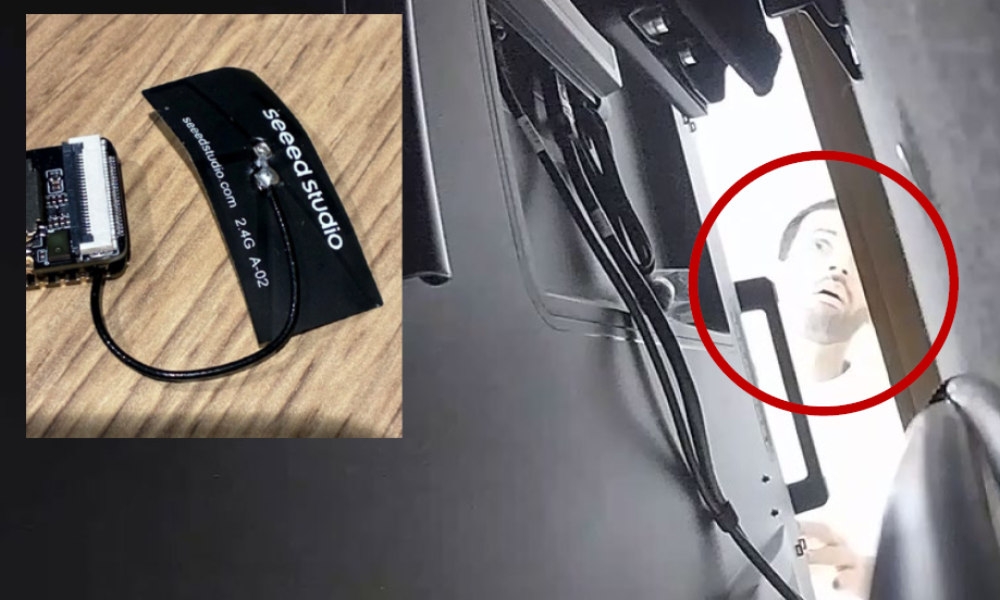
Жучок в переговорке OpenAI нашли с помощью моделей OpenAI
30 сентября в переговорной руководства OpenAI нашли записывающее устройство, завёрнутое в туалетную бумагу. Вычислить инженера, который его поставил, по словам компании, помогли модели самой OpenAI. У вас в офисе переговорные когда-нибудь проверяли на прослушку?
Читайте также
- Немецкая Kolibri с окном в 1M токенов вышла под Apache 2.0
- Mistral Large 4 обошла GLM-5.3 на DeepSWE, пишет VentureBeat
- Дообучение MiMo-V2.6-Pro обошлось Xiaomi в 2,62 миллиона
- Переводчик Cohere не рассуждает, и это ради экономии
- Предшественник архитектуры Qwen4 вышел как 125B MoE
- 4-битная сборка Qwen3.8-27B занимает 16,1 ГБ
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.