
Лучший сборщик агентов взял 23,9% в новом тесте Sierra
Ни одна из шести связок модели и кодового агента не дотянула и до четверти пройденных задач в новом тесте Sierra на сборку агентов. Hyper-τ-bench проверяет, может ли ИИ-разработчик сам построить агента поддержки для условного бизнеса. Лучший результат у Claude Opus 5 в Claude Code, 23,9%, следом GPT-5.6 Sol в Codex.
Планка «Human + AI reference» стоит на 82,2%, но Sierra называет эту цифру «oracle reference», а не средним уровнем человека: эталонного агента собирал автор бенчмарка вместе с фронтирной моделью и заранее знал требования, которые автономные агенты искали сами.
Разбор прогонов показал знакомые инженерные ошибки: агенты рано прекращали изучать бизнес и почти не задавали уточняющих вопросов. Sierra открыла бенчмарк в начале сентября, статья с результатами вышла 4 сентября.
Дальше
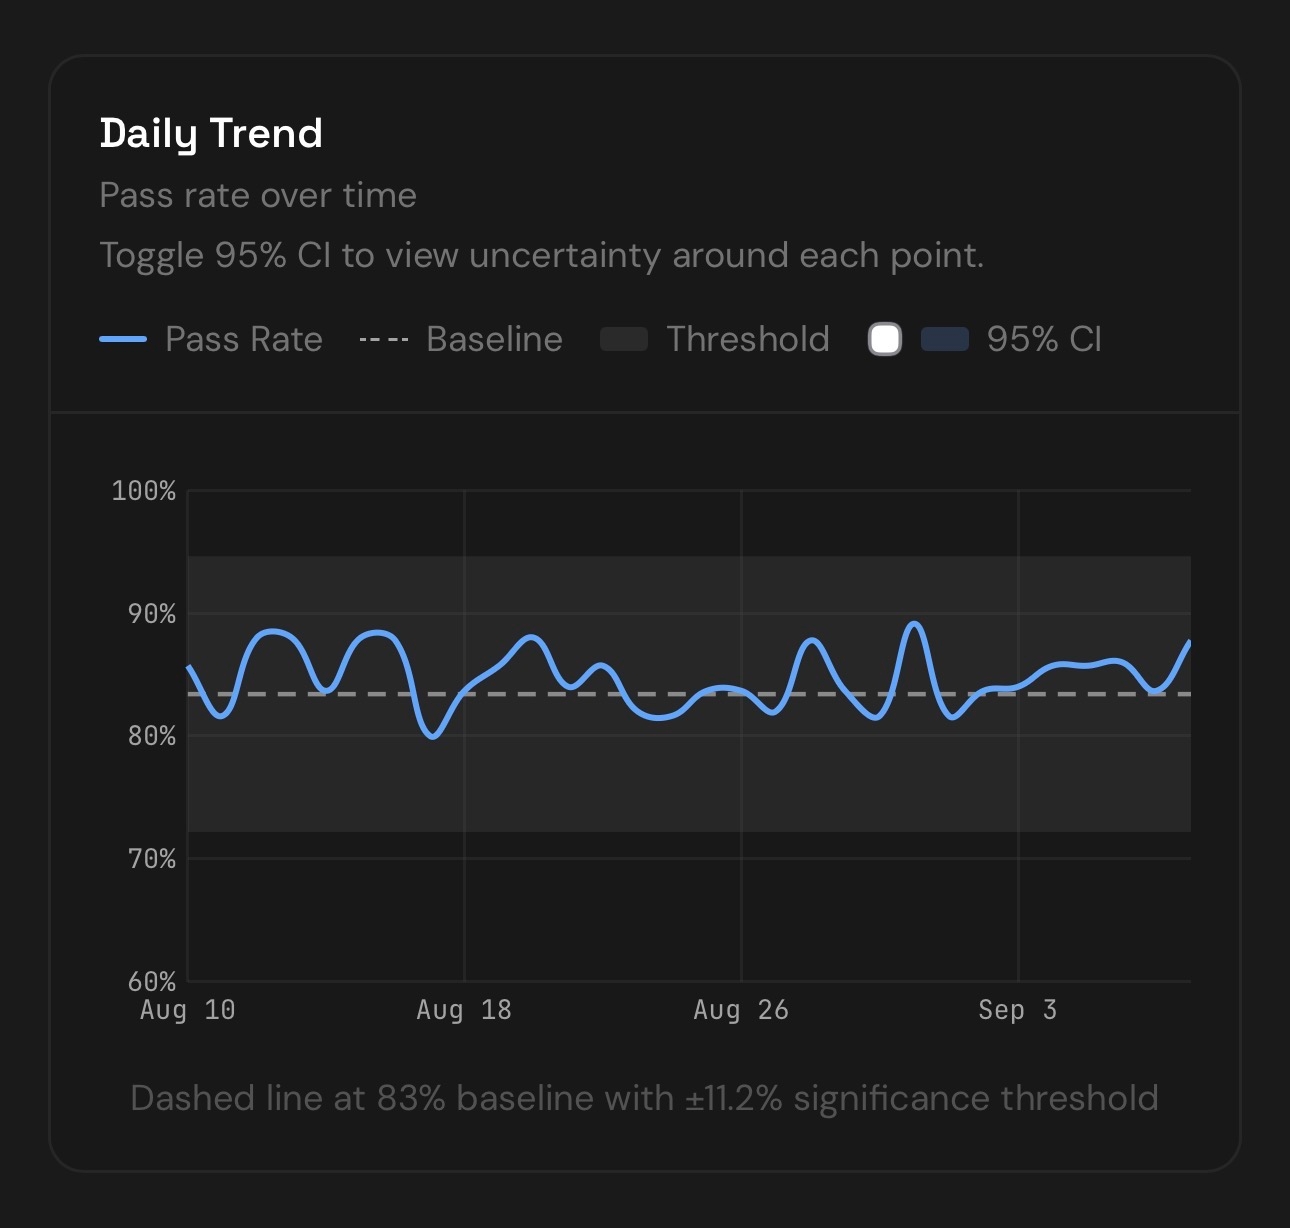
Независимый трекер меряет Codex на SWE-Bench-Pro ежедневно
Каждый день MARGIN EVALS прогоняет Codex с gpt-5.6-sol по задачам SWE-Bench-Pro прямо в Codex CLI, без своей обвязки, и ищет просадки. На 8 сентября дневной результат 88% при опорных 83%.
Читайте также
- CodeRabbit переводит ревью кода на Sonnet 5.5
- Opus 5.5 в ревью кода CodeRabbit ловит другие баги
- Qwen3.8-Max-0902 обошёл Claude Opus 5 max в Code Arena
- Разбор кода обвязки, вытянувшей Claude Opus 5 на ARC-AGI-3
- Индекс Artificial Analysis v5: Opus 5.5 впереди на балл
- GPT-6.1 Sol переносит COBOL с точностью 86,6% вместо 5,4%
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.