
Немецкая Kolibri с окном в 1M токенов вышла под Apache 2.0
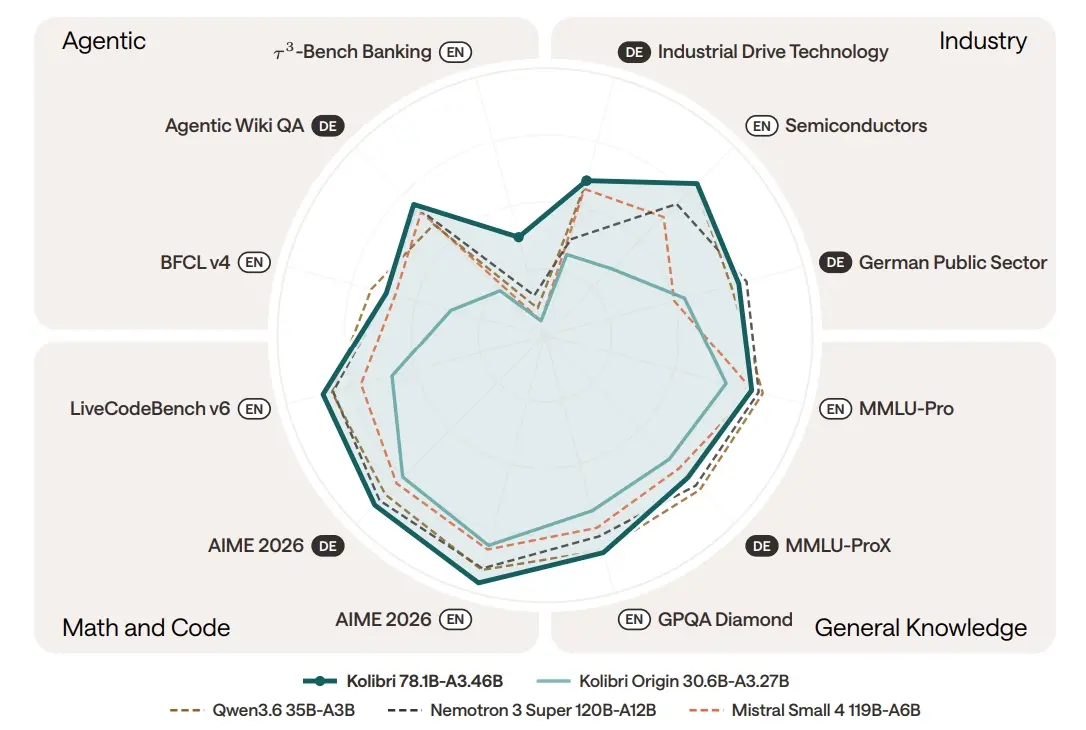
Всего в Kolibri 78,1 миллиарда параметров, но на каждый токен уходит лишь 3,46 миллиарда, и при этом модель обещает окно контекста в миллион токенов. Aleph Alpha выложила веса этой англо-немецкой модели на Hugging Face под Apache 2.0, о релизе рассказал пост в Threads.
Коротко
- Kolibri рассчитана на госструктуры и регулируемые отрасли: модель можно поднять на своём железе и не отправлять внутренние данные стороннему сервису инференса.
- Внутри смесь экспертов из 384 подсетей, из которых на каждый токен включаются шесть, а полное внимание работает лишь в 10 слоях из 50, в остальных скользящее окно на 512 токенов.
- Подвохов два: окно в 1 048 576 токенов обещают через настройки при адаптации до 256 000, а все бенчмарки, включая тест на отказы AA-Omniscience, Aleph Alpha прогоняла сама.
Если вы не следили: по данным справочника Skypage, Aleph Alpha основана в 2019 году в Гейдельберге и строит работу вокруг суверенного ИИ. По данным Aleph Alpha, сначала компания собрала конвейер обучения и проверила его на Kolibri Origin, модели на 30 миллиардов параметров с 3 миллиардами активных и окном всего в 65 тысяч токенов. Через тот же конвейер затем прошла и Kolibri.
Kolibri обучали на 768 видеокартах B200 и почти 24 триллионах токенов
Релиз пришёлся на 3 октября 2026 года, День германского единства. По данным Testing Catalog, Kolibri обучали на 768 GPU B200: сначала 20 триллионов токенов за 21 день, затем дообучение в середине цикла и адаптация к длинному контексту, всего почти 24 триллиона токенов. Опирались на Kolibri Origin и автоматизированную Model Factory компании.
На немецкий приходится 21,3% токенов предобучения. Словарь двуязычный, на 128 000 записей, а токенизатор устроен так, чтобы не дробить немецкие составные слова. У модели четыре режима рассуждений (none, low, medium и high) и вызов инструментов.
Специализацию Aleph Alpha описывает так: немецкий язык, математика, код, длинный контекст и агентные задачи. Для госуправления, автопрома, полупроводников, промышленных технологий и авиакосмоса компания собрала отраслевые наборы тестов без клиентских данных.
Kolibri построили в Германии, обучали в Германии и Финляндии. Полный контроль над отбором данных, обучением, оценкой, весами и развёртыванием, по словам компании, нужен для европейских требований к соответствию и суверенитету. Запускать модель предлагают через пакет инференса Aleph Alpha и отдельный плагин для vLLM.
На AIME 2025 Kolibri набрала 96,9 по замерам самой Aleph Alpha
Общий балл по английскому составил 75,5, по немецкому 70,8. На AIME 2025 у модели 96,9, на LiveCodeBench v6 85,9, на BFCL v4 в общем зачёте 61,4. Все цифры Aleph Alpha получила на собственных тестовых обвязках, где применимо, с самым высоким доступным режимом рассуждений.
Компания утверждает, что Kolibri лежит на парето-фронте качества и стоимости обслуживания для английского и немецкого. По словам Aleph Alpha, ни одна из сравниваемых моделей не даёт больше качества за ту же цену инференса или того же качества дешевле. На математике, коде, заземлении ответов, агентных и длинноконтекстных задачах, как заявляет компания, Kolibri догоняет модели, у которых активных параметров до четырёх раз больше.
Автор поста в Threads называет Kolibri, вероятно, первой универсальной моделью из ЕС, кроме Mistral, которая вышла на такой уровень. В релизе он видит знак, что к гонке подтягиваются и другие европейские лаборатории.
Почему из 78,1 миллиарда параметров на токен работают 3,46 миллиарда
Смесь экспертов (MoE) держит в слое много небольших подсетей. Как объясняет NVIDIA, обученный маршрутизатор выбирает для каждого токена малую их часть, и считаются только они, так что ёмкость растёт без полной цены вычислений. У Kolibri экспертов 384, на токен включаются шесть. Представьте большую поликлинику: врачей много, но пациент попадает к нескольким нужным специалистам, не обходя всех.
Вторая экономия спрятана во внимании. Полное внимание, при котором токен смотрит на весь текст, работает только в 10 слоях из 50. В остальных 40 каждый токен видит лишь 512 соседей в скользящем окне, и, по объяснению Aleph Alpha, так сдерживается стоимость инференса.
Отказам модель учили отдельно: на примерах, где правильно промолчать, и процедурой Merlin-Arthur, по данным Testing Catalog состязательной, которая учит не отвечать без подтверждения в документах. Kolibri избежала неверного ответа на 44% вопросов AA-Omniscience против 14,8% у Kolibri Origin, а по собственной метрике заземления M/A получила 0,23.
Окно в 1 048 576 токенов держится на настройках сервинга, адаптацию же довели до 256 000, и как модель ведёт себя за этой отметкой, в материалах не сказано. Неясен и знаменатель у 44%: Artificial Analysis считает свою долю галлюцинаций среди всех нескорректных ответов, то есть неверных, частичных и пропущенных, а не среди всех вопросов. На наш взгляд, рост отказов почти втрое против Kolibri Origin интереснее любого балла в таблице, но все эти цифры пока вендорские.
Миллион токенов на чужих тестах
Конарк Моди (Konark Modi) написал, что разместил Kolibri-1 и открыл к ней бесплатный доступ для всех на ближайшее время. Точный срок в доступном фрагменте его поста обрезан. Удержит ли модель качество за отметкой 256 000 токенов и подтвердится ли результат на AA-Omniscience, покажут только сторонние замеры. Когда они появятся, пока неизвестно.
Читайте также
- Шесть моделей K2 Horizon вышли с логами обучения
- Ideogram 4.5 заточили под правку и обещают открыть веса
- Дообучение MiMo-V2.6-Pro обошлось Xiaomi в 2,62 миллиона
- Переводчик Cohere не рассуждает, и это ради экономии
- V4.1 Flash: 552 миллиарда параметров и Encoder-Decoder
- Лицензия GLM-5.3 бьёт по гиперскейлерам
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.