
Claude Sonnet 5.5 вышел в тройку, но очень много пишет
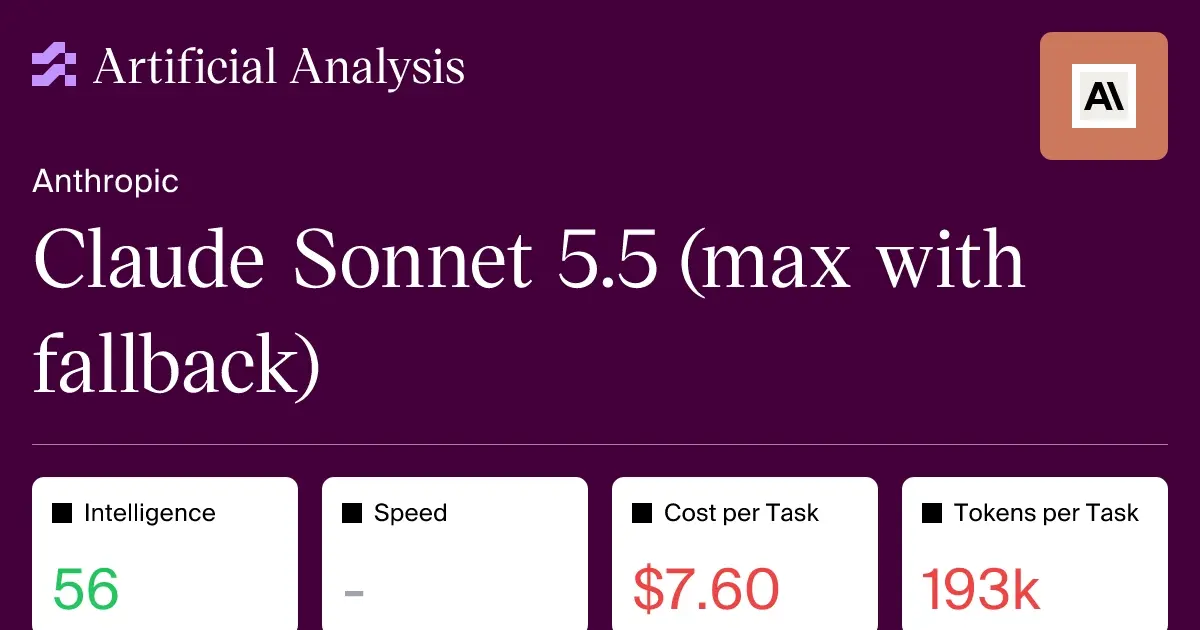
По данным Artificial Analysis, в режиме максимального усилия Claude Sonnet 5.5 потратила на прогон индекса 410 миллионов выходных токенов, хотя медиана класса составляет 88 миллионов. Зато результат высокий: 56 баллов при медиане 26 и третье место из 216 моделей.
Коротко
- Artificial Analysis протестировала Claude Sonnet 5.5 в конфигурации Adaptive Reasoning, Max Effort, Default Fallback. Эта модель Anthropic вышла 28 сентября 2026 года, её контекст вмещает миллион токенов.
- Цены в API Anthropic совпадают с медианой класса: 2 доллара за миллион входных токенов и 10 долларов за миллион выходных. Одна задача индекса в среднем обходится в 7,60 доллара.
- Главный минус в многословии: на прогоне индекса модель выдала почти в пять раз больше медианы. Скорость вывода Artificial Analysis не указала, поэтому по странице не понять, сколько придётся ждать ответа.
Если вы не следили: в линейке Anthropic модели Sonnet стоят посередине, между компактной Haiku и флагманской Opus. Sonnet 5.5 вышла 28 сентября 2026 года. Artificial Analysis сама прогоняет модели через свои тесты и в этот раз оценила новинку в конфигурации с адаптивным рассуждением на максимальном усилии.
Sonnet 5.5 набрала 56 баллов и заняла третье место из 216
Индекс Artificial Analysis версии 4.3.2 состоит из 10 тестов: AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience и AA-LCR v1.1. Terminal-Bench 4.0 и GDP.pdf помечены как новые, у CritPt стоит статус «на проверке».
В режиме Max Effort Sonnet 5.5 набрала 56 баллов. Медиана среди рассуждающих моделей того же ценового уровня составляет 26 баллов, так что отрыв больше чем двукратный. В рейтинге по интеллекту у модели третье место из 216.
Важно понимать, с кем её сравнивали. Проприетарные модели Artificial Analysis ставит рядом с закрытыми и открытыми моделями того же ценового диапазона. Диапазон определяется по смешанной цене, в которой вход и выход взяты в соотношении 3 к 1. Всего диапазонов три: дешевле 0,15 доллара за миллион токенов, от 0,15 до 1 доллара и дороже 1 доллара.
На прогон индекса ушло 410 миллионов токенов при медиане 88 миллионов
Больше всего на странице удивляет расход: 410 миллионов выходных токенов на весь прогон индекса в конфигурации Max Effort. У рассуждающих моделей того же ценового уровня медиана составляет 88 миллионов, и Artificial Analysis прямо называет Sonnet 5.5 очень многословной.
Деньги считаются от токенов. Одна задача индекса в среднем обошлась в 7,60 доллара. В расчёт идут цены на обычный вход, попадания в кэш, запись в кэш, рассуждение и ответ, а итог взвешивается по весу каждого теста в индексе. По стоимости задачи Sonnet 5.5 занимает 98-е место из 216, по многословию 102-е.
Скорости на странице нет. В графе с числом выходных токенов в секунду стоит N/A, и по этим данным нельзя оценить, сколько длится работа при таком количестве токенов.
Вход стоит 2 доллара за миллион токенов, выход 10 долларов
В API Anthropic модель стоит 2 доллара за миллион входных токенов и 10 долларов за миллион выходных. Медианы класса точно такие же, 2 и 10 долларов, поэтому по прайсу Sonnet 5.5 не дешевле и не дороже соседей.
На кэш действует скидка 90%: промпт, который уже обрабатывался, при повторной отправке оплачивается по сниженной ставке. Artificial Analysis смешивает попадания в кэш, обычный вход и выход в пропорции 7:2:1 и получает 1,54 доллара за миллион токенов. Запись и хранение кэша провайдеры тарифицируют отдельно.
Прочие характеристики такие. Контекст составляет 1 миллион токенов, это примерно 1 500 страниц A4, набранных шрифтом Arial двенадцатого кегля. На вход модель принимает текст и изображения, отвечает текстом. Веса закрыты, число параметров Anthropic не раскрывает. Через API модель доступна у трёх провайдеров, и цены у них могут различаться.
Токены рассуждения Artificial Analysis считает отдельно от токенов ответа
В этой конфигурации Sonnet 5.5 работает как рассуждающая модель: прежде чем ответить, она проходит решение цепочкой промежуточных шагов. Эти шаги тоже состоят из токенов. В расчётах Artificial Analysis они выделены в отдельную строку, токены рассуждения, рядом с токенами самого ответа.
Представьте экзамен, где платят за каждую написанную строчку, в том числе в черновике. Чистовой ответ может уместиться на полстраницы, черновик растянуться на десять, а счёт придёт за все одиннадцать. Что означает каждая часть полного названия конфигурации (Adaptive Reasoning, Max Effort, Default Fallback), на странице не объясняется. Сказано только, что описана рассуждающая версия и что вариант без рассуждения тоже может существовать.
Главное, о чём страница молчит, касается времени. Скорость вывода не указана, а при 410 миллионах токенов именно от неё зависит, подойдёт ли модель для интерактивной работы. На наш взгляд, с экономией токенов, которую Anthropic обещала в анонсе, такой расход вяжется плохо. Правда, замеряли только максимальное усилие, и на обычных настройках картина, вероятно, другая.
Когда появится скорость Sonnet 5.5
Графа скорости пока пуста, и когда Artificial Analysis её заполнит, на странице не сказано. Открытым остаётся и сравнение с другими уровнями усилия: описана только версия Max Effort, замеров для более экономных режимов и для варианта без рассуждения нет. Стоит следить и за тестом CritPt. Пока у него статус «на проверке», поэтому итоговый балл индекса ещё может измениться.
Читайте также
- Anthropic снова берёт деньги за отклонённые запросы
- Opus 5.5 в ревью кода CodeRabbit ловит другие баги
- Claude Code раздаёт сброс лимитов, который можно отложить
- Claude Opus 5.5 считает на 40% дешевле Opus 5
- Anthropic удалила пост про рост лимитов и признала минус 17%
- Vending-Bench: Astra обошёл Fable 5.1 почти втрое
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.