
Обвязка агента меняет расход токенов
Обвязка OpenClaw ещё до первого действия по задаче отправляет модели около 26 000 токенов: системный промпт, описания инструментов и настройку среды. Aider в режиме architect на том же этапе расходует примерно 700. Такие цифры получил независимый бенчмарк, проведённый в июне. Обвязкой (harness) называют программу, которая ведёт модель по задаче шаг за шагом.
1 сентября The New Stack разобрал этот бенчмарк вместе с двумя другими сравнениями, от Composio и Artificial Analysis. Модель во всех трёх фиксирована, но цена решённой задачи всё равно расходится в разы, и зависит это от обвязки.
Налог на старт
Автор июньского теста описал его в своём блоге. В тест вошли Aider, Claude Code, Codex, Goose, Hermes, Kilo, Kimi Code, Nanobot, OpenClaw, Opencode и Qwen Code, причём режим architect у Aider считался отдельной конфигурацией. Всего получилось 12 конфигураций и 12 одинаковых задач на Python. Все запросы шли через OpenRouter, поэтому API и модель у всех совпадали. Сначала тест прогнали на DeepSeek V4 Flash, затем на Nemotron 3 Ultra от Nvidia. У Nemotron на OpenRouter есть бесплатный тариф, так что повторить прогон может любой. Почти все обвязки решили почти все задачи, и сравнивать осталось только то, во что обошёлся результат. Расход на решённую задачу составил от примерно 3 500 токенов у Aider в режиме architect до 292 000 у OpenClaw.
В таблице автора для каждой обвязки указан диапазон по двум моделям и стартовый объём. У Hermes на задачу ушло 30-34 тысячи токенов при старте около 2 500, у Claude Code 52-55 тысяч при 4 500, у Codex 85-90 тысяч при 8 200, у OpenClaw 191-292 тысячи при 26 000. Стартовый объём почти не изменился при смене модели, и его рейтинг остался прежним. В рейтинге стоимости задачи поменялись местами только две соседние позиции. В августе отдельный эксперимент показал, из чего состоит запрос Codex: на промпт «Reply with pong.» пришлось около 25 токенов из примерно 9 435.
Между вызовами модель ничего не помнит. Поэтому на каждом ходе обвязка заново отправляет весь диалог вместе со стартовым грузом. Автор приводит пример: обвязка со стартом в 26 000 токенов за 15 ходов отправит около 390 000 входных токенов на одну служебную часть. Если умножить стартовый объём на число ходов, получится расход на решённую задачу с R² 0,99 на обеих моделях. Автор ожидал, что дорогими окажутся обвязки, у которых контекст растёт быстрее. Данные этого не подтвердили: у всех контекст прибавлял несколько сотен токенов за ход, просто дорогие обвязки изначально несут больший груз.
У теста есть ограничение: каждую комбинацию обвязки, задачи и модели прогнали один раз, а агенты работают недетерминированно, так что оценок разброса нет. У Artificial Analysis выборка статистически надёжнее. Её индекс объединяет DeepSWE, Terminal-Bench v2.1 от Laude Institute и SWE-Atlas-QnA от Scale AI: 326 задач, по три попытки на каждую. Для каждой пары обвязки и модели там публикуются цена задачи, расход токенов и время работы. Есть и отдельное сравнение Claude Code, Cursor CLI и Opencode на одной и той же Claude Opus 4.7.
Кэш меняет счёт
Composio сообщила, что Claude Code получил из кэша лишь 1,5% входных токенов. У Codex эта доля составила около 70%, у OMP 57%. Свежий вход стоит примерно впятеро дороже кэшированного. В итоге Claude Code тратил сопоставимое с конкурентами число токенов, но счёт у него выходил заметно больше.
Июньский тест показал похожий перекос. На прогоне с DeepSeek Codex израсходовал за весь набор задач больше миллиона токенов, но 77% из них были чтениями из кэша по цене примерно в десять раз ниже обычной. Если считать в деньгах, Codex обошёлся дешевле Claude Code в пересчёте на решённую задачу, хотя «сырых» токенов Claude Code потратил вдвое меньше. Автор объясняет почти нулевую долю кэша у Claude Code маршрутом запросов, промпты тут ни при чём. Claude Code был единственной обвязкой, которая обращалась к OpenRouter через эндпоинт messages в формате Anthropic. При переводе этого формата шлюз, по всей видимости, терял попадания в кэш, которые такой же трафик получил бы через эндпоинт в формате OpenAI. Шлюзы со временем меняют поведение, поэтому The New Stack советует считать это одним наблюдённым случаем. Artificial Analysis закладывает этот эффект прямо в модель стоимости: кэшированный вход и запись в кэш считаются отдельно, а в методологии сказано, что доля попаданий в кэш сильно зависит от маршрутизации к провайдеру.
Сколько стоит успешная задача?
Composio сравнила восемь обвязок на DeepSeek V4 Flash в 30 рабочих сценариях с Airtable, Gmail, Google Calendar, Google Sheets, GitHub, Slack и PostHog. Лимит на задачу составлял 900 секунд. Результат проверял программный верификатор, без LLM-судьи, на изолированных тестовых данных с ловушками и почти одинаковыми ключами. Из 240 прогонов успешными оказались 129. Стоимость успешной задачи составила от 0,028 доллара у Pi Agent до 0,195 доллара у Claude Code, разница почти в семь раз. DeepAgents решил ровно столько же задач, сколько Claude Code, а успешный прогон обходился ему вчетверо дешевле.
Доля успешных задач менялась от 46,7% у OpenCode до 66,7% у Pi Agent, это 20 процентных пунктов на одной модели. Composio сама указала на огрехи в контроле условий. Pi работал с другим уровнем рассуждений у двух разных провайдеров, а у Prime Agent из 30 прогонов оценить удалось только 24. Вывод The New Stack: от выбора обвязки стоимость меняется в разы, а доля успешных задач на проценты.
На сложных задачах тяжёлые обвязки преимущества не показали. Четыре обвязки из разных ценовых диапазонов прогнали на десяти задачах SWE-bench Lite с щедрыми лимитами. Каждая решила ровно одну задачу, причём одну и ту же. Aider потратил на это 0,8 миллиона токенов, Codex 15 миллионов, почти в двадцать раз больше. Десять задач на одной модели слишком мало для обобщений, и The New Stack называет результат лишь наводящим на размышления.
100 000 токенов шума
Июньский бенчмарк проверил и то, как обвязки справляются с большим промптом. Перед каждой задачей в промпт добавляли 100 000 токенов нерелевантных логов. Семь конфигураций из двенадцати передали промпт модели целиком. OpenClaw отказался запускаться, Kimi Code упал, Claude Code отправил всё и после этого справился плохо.
Kilo и Opencode выбросили 83-89% промпта и всё равно отчитались об успешном выполнении.
Дальше
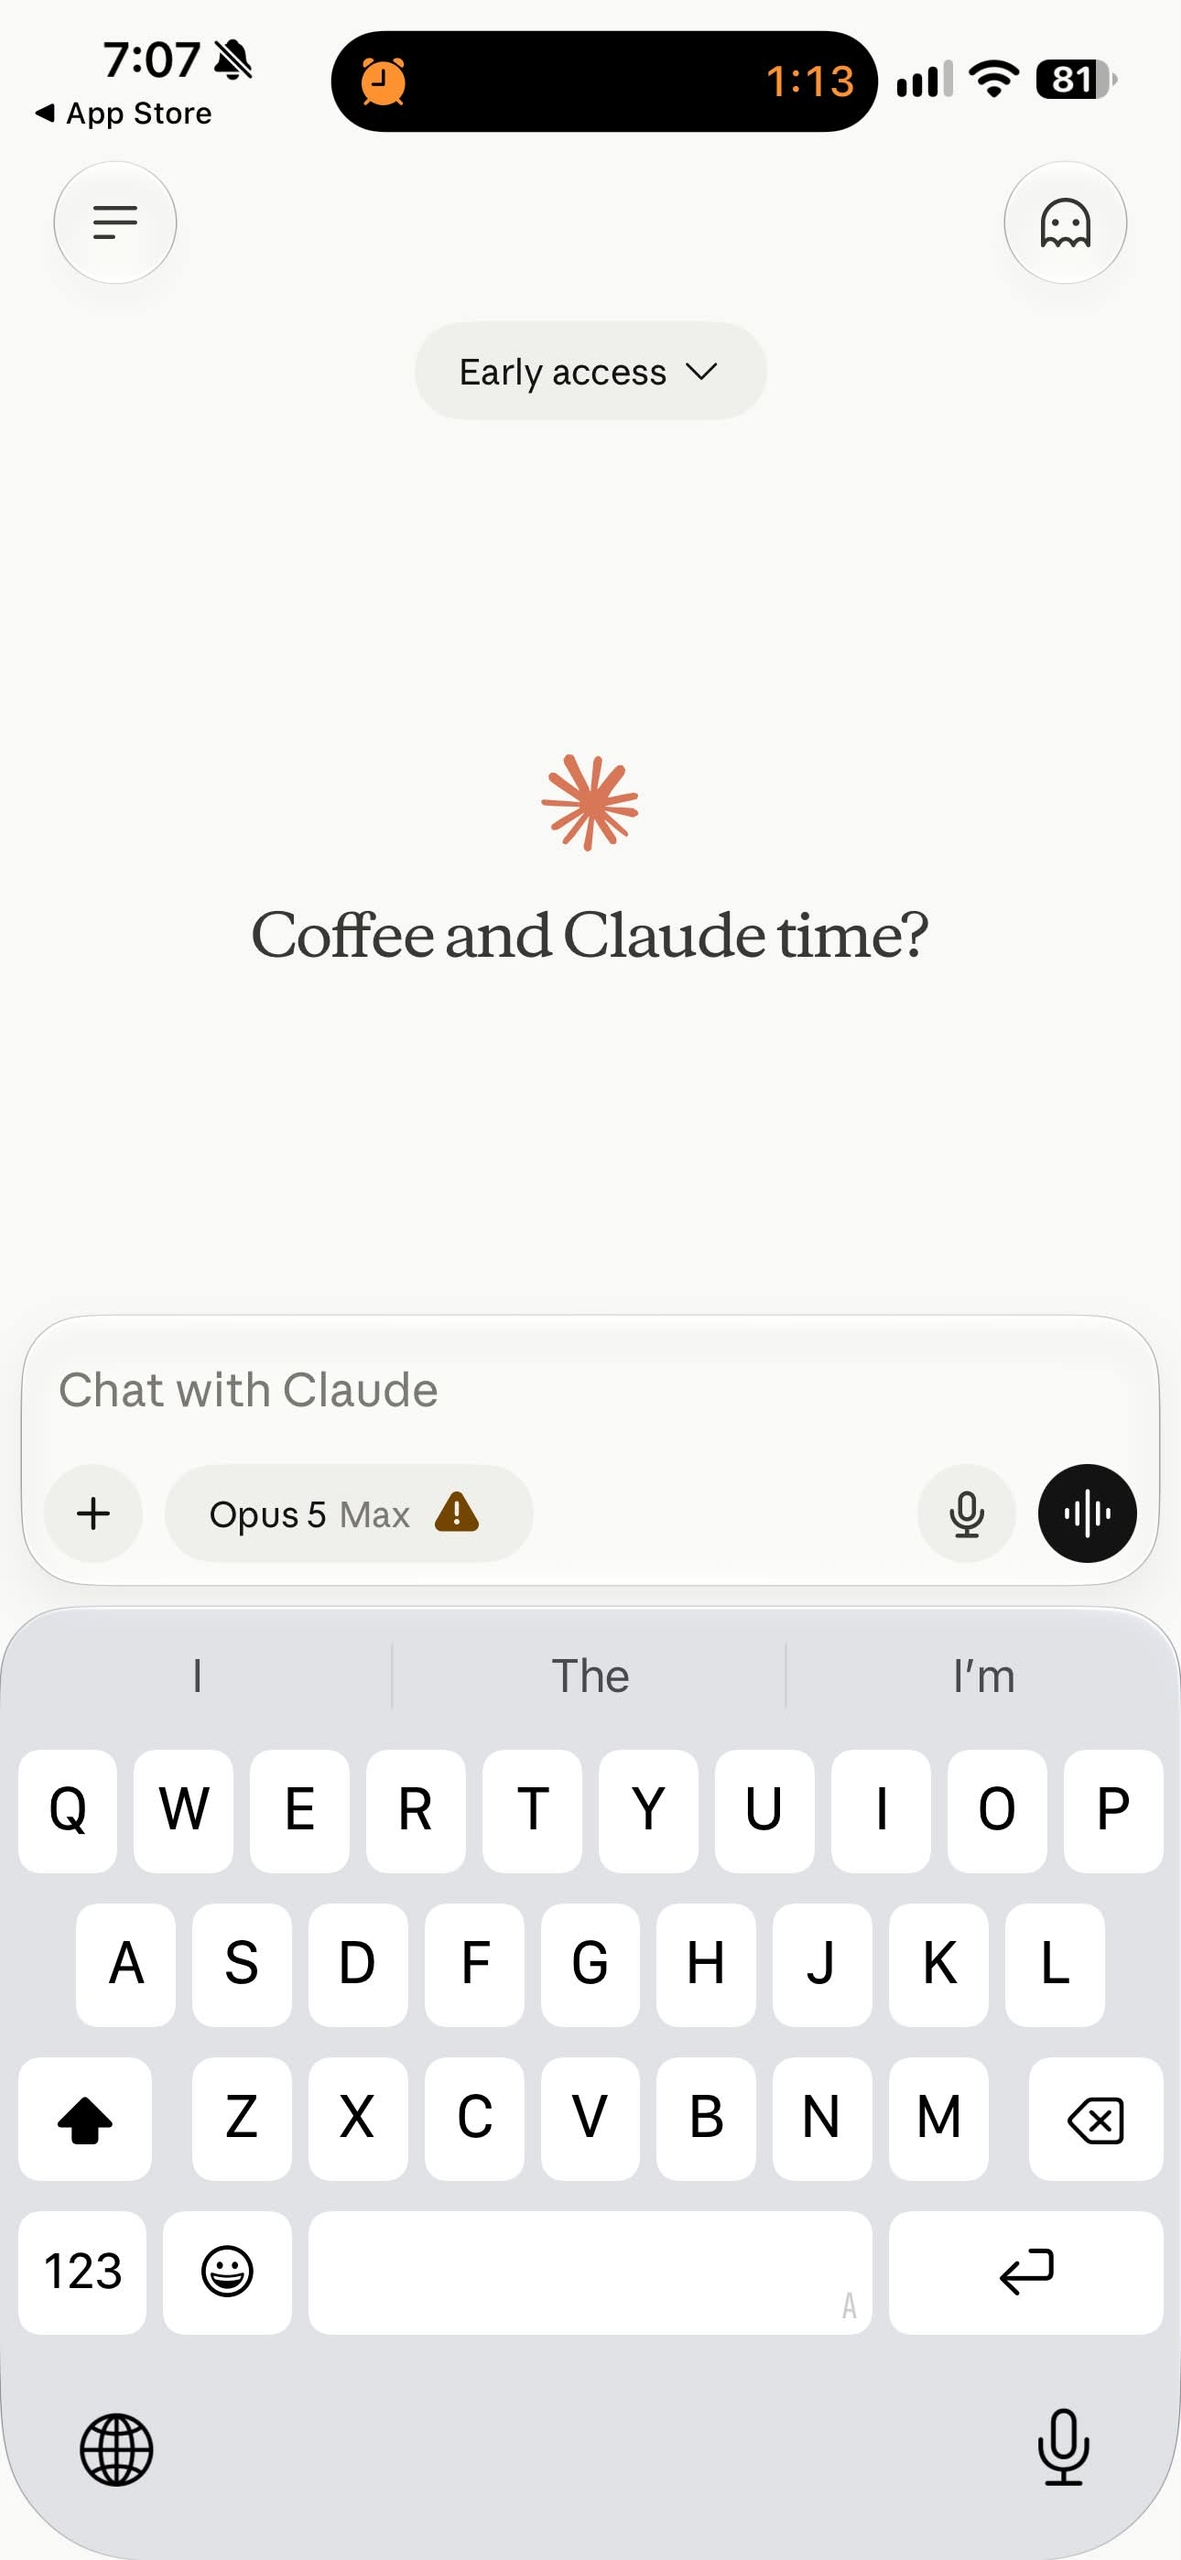
Claude для iOS предупреждает о расходе Max effort
«Max 1,5 ⚠️» рядом с настройкой Max effort в Claude для iOS: в исходном сообщении сказано, что режим расходует в 1,5 раза больше лимита. Anthropic пишет, что высокий effort быстрее приближает лимиты.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.