
TPU Sync от Google переносит KV-кэш за 230 мс вместо секунд
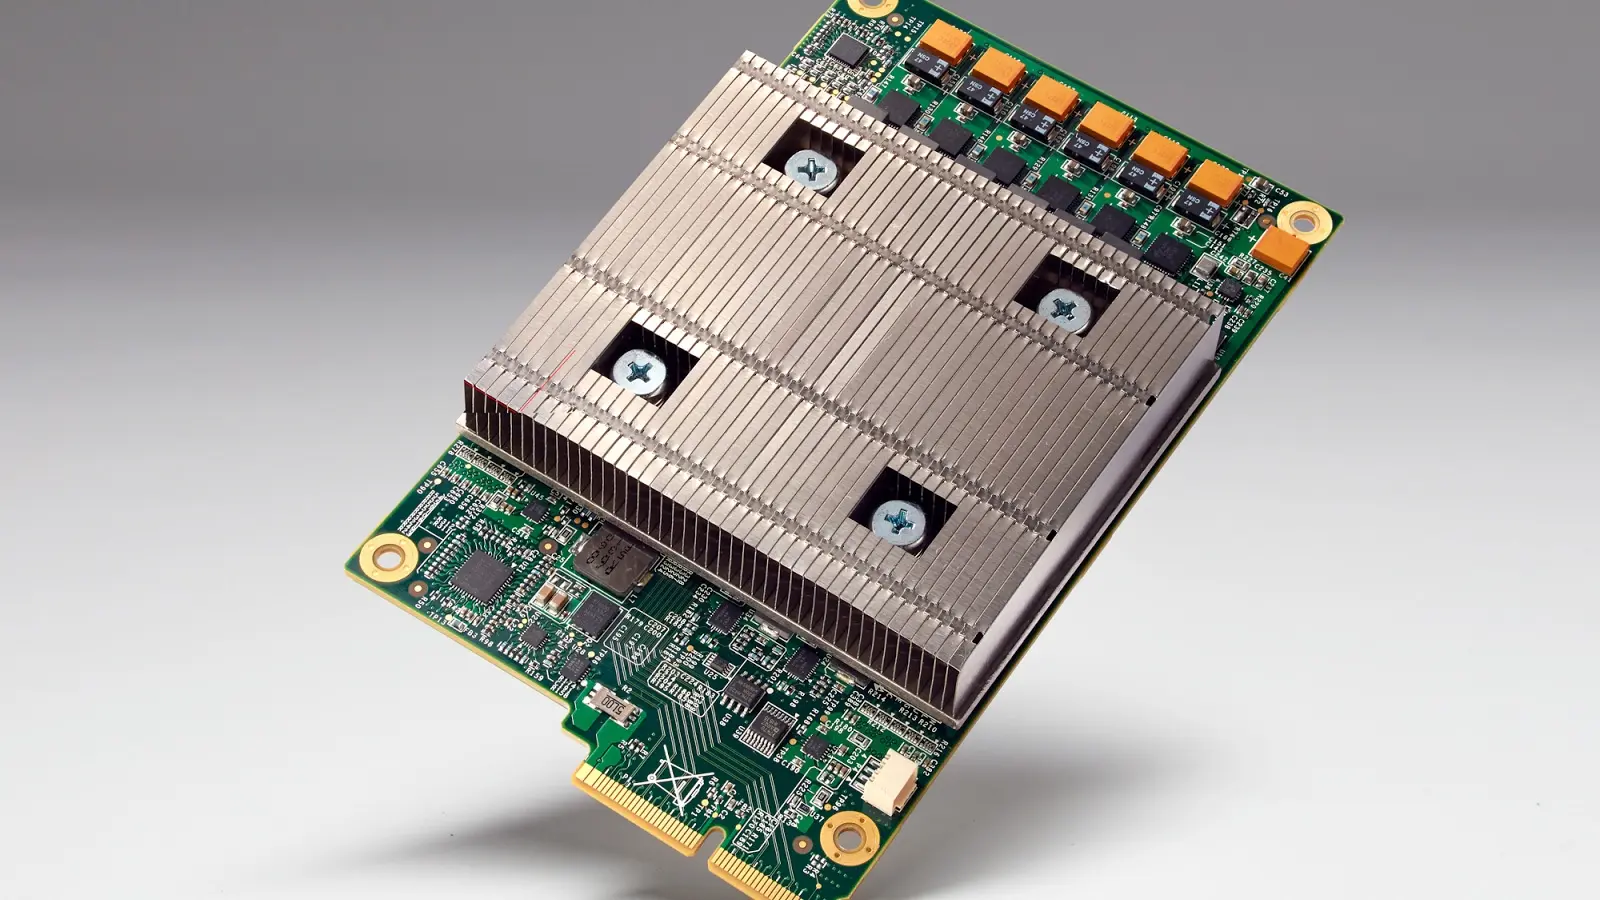
Перенос KV-кэша модели Qwen3 на 235 млрд параметров в тестах Google занял около 230 миллисекунд вместо нескольких секунд: такой результат компания 9 ноября привела для TPU Sync, открытой библиотеки на C++, которая управляет памятью при инференсе и RL-обучении на Cloud TPU. Тем, кто обслуживает большие модели на TPU v7x или v6e, библиотека уже доступна, но пока только ночными сборками и с быстро меняющимися API, поэтому в репозитории Google советуют закреплять релиз с тегом или проверенный коммит из файла lkg.version, а не следить за main.
В lkg.version лежит хеш последнего коммита, который прошёл все сквозные функциональные тесты и тесты производительности, а в main, предупреждает Google, временами попадают нестабильные изменения. Переключиться на проверенную ревизию можно одной командой: git checkout $(cat lkg.version).
Как ставить и что не трогать
Готовые колёса лежат на PyPI под именами tpu-sync-jax и tpu-sync-torch. Стабильного релиза ещё нет, там только .dev-сборки, так что pip нужен флаг --pre. Вариант для JAX самодостаточен и сам подтягивает закреплённые версии jax, jaxlib и libtpu. С PyTorch сложнее: torch и torch_tpu колесо не ставит, в публичном индексе их нет, и сначала придётся поставить подходящий torch_tpu с точной версией torch вроде torch==2.11.0, потому что расширение привязано к ABI той сборки, с которой его компилировали. К тому же релизы torch-колеса пока не проверяются сквозными тестами производительности.
Раньше код назывался TPU Raiden, и старые пакеты tpu-raiden-jax и tpu-raiden-torch на PyPI проект больше не контролирует: Google просит их не ставить. Ещё одна ловушка - установка с PyPI вместе с --extra-index-url, указывающим на приватный реестр. pip выбирает самую высокую версию из всех подключённых индексов, и такая схема открывает дорогу атакам с подменой зависимостей.
Откуда берутся 90%
KV-кэш - это память модели о уже прочитанном контексте. С ростом контекстных окон и многоходовыми агентами узкое место, по словам Google, сместилось с вычислений на управление этой памятью: из-за неё растут задержки, а дорогие ускорители простаивают. Острее всего это при раздельном обслуживании, когда промпт читают одни чипы, генерируют ответ другие и кэш приходится перегонять между ними.
TPU Sync забирает массивы JAX и тензоры PyTorch напрямую через аппаратные дескрипторы PjRtBuffer, без промежуточной копии в памяти CPU. Передачи идут в фоновых потоках C++ в обход Python GIL, поэтому перекладка памяти работает параллельно с prefill и decode на самом TPU. В README пропускную способность PCIe в обе стороны на реальных размерах блоков KV-кэша оценивают примерно в 200 ГБ/с; The News Stack приводит 223 ГБ/с на хост Ironwood TPU при теоретическом потолке PCIe Gen5 в 256 ГБ/с.
Когда HBM ускорителя заполняется, давно не использованные блоки уходят в оперативную память хоста, которая служит вторым уровнем кэша префиксов, и возвращаются по запросу. Этот кэш хранится в разделяемой памяти /dev/shm и переживает перезапуск, обновление или падение контейнера с сервером инференса: после старта система подключается к нему заново и не пересчитывает prefill с нуля.
По замерам Google, которые приводит The News Stack, ускоренный перенос кэша на Qwen3-235B снизил среднее время до первого токена на 60% при относительно небольшом числе одновременных запросов, и только на модели в 480 млрд параметров выигрыш дошёл до 90%. В тестах кэширования префиксов с контекстом 64 000 токенов время до первого токена сократилось максимум на 90%, пропускная способность выросла больше чем на 50%, а задержка между токенами на 99-м перцентиле снизилась на 30%. Результат, оговаривается издание, зависит от нагрузки, от того, какую долю кэша удаётся переиспользовать, и от доступной пропускной способности сети.
Где Nvidia впереди
Аналитики SemiAnalysis считают, что внешним клиентам TPU до сих пор не хватало инфраструктуры, чтобы толком разделять prefill и decode. Их же данные InferenceX показывают, что системы Nvidia GB200 и GB300 NVL72 опережают TPU на части кривой производительности при раздельном обслуживании, хотя прямого сравнения с полностью настроенной конфигурацией TPU v7 ещё не опубликовано.
TPU Sync вышла вместе с TorchTPU, где есть поддержка vLLM и SGLang. Тем, кто уже обслуживает модели на этих движках, раздельный инференс на TPU не потребует собирать стек заново.
Сборка из исходников
Для сборки нужны Python 3.12 и Bazel 8.6.0, а для варианта с PyTorch ещё и patchelf. Расширение собирается под одну версию JAX из семи проверенных, от 0.10.0 до 0.12.0, по умолчанию 0.11.2; другую выбирают переменной RAIDEN_JAX_VERSION, а версии не из списка сборка отклоняет. Если XLA или abseil расходятся с установленным jaxlib, компиляция проходит, а процесс падает уже во время работы и обычно далеко от причины. Поэтому при смене версии JAX build.sh запускают заново, в том окружении, где потом будут работать.
Дальше
Fable 5.2 в AI Gateway требует хранить запросы 30 дней
Нулевое хранение данных для Claude Fable 5.2 Anthropic не включила, поэтому промпты и ответы в Vercel AI Gateway лежат 30 дней. Команде с включённым ZDR шлюз вместо ответа модели вернёт ошибку. Вы бы отключили ZDR ради Fable 5.2 или остались на моделях с поддержкой ZDR?
Читайте также
- Google собрала TPU 8i Max из двух чипов под длинный контекст
- AI Studio от Google собирает приложения с картами по промпту
- Google пустила в Android Studio больше 40 чужих агентов
- 7,4 млрд коммитов в месяц у GitHub против 65 млн в 2024-м
- DeepSeek выложила движок своего API, Huawei наравне с Nvidia
- Google Play пускает самоделки из AI Studio на ваш телефон
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.