
Google собрала TPU 8i Max из двух чипов под длинный контекст
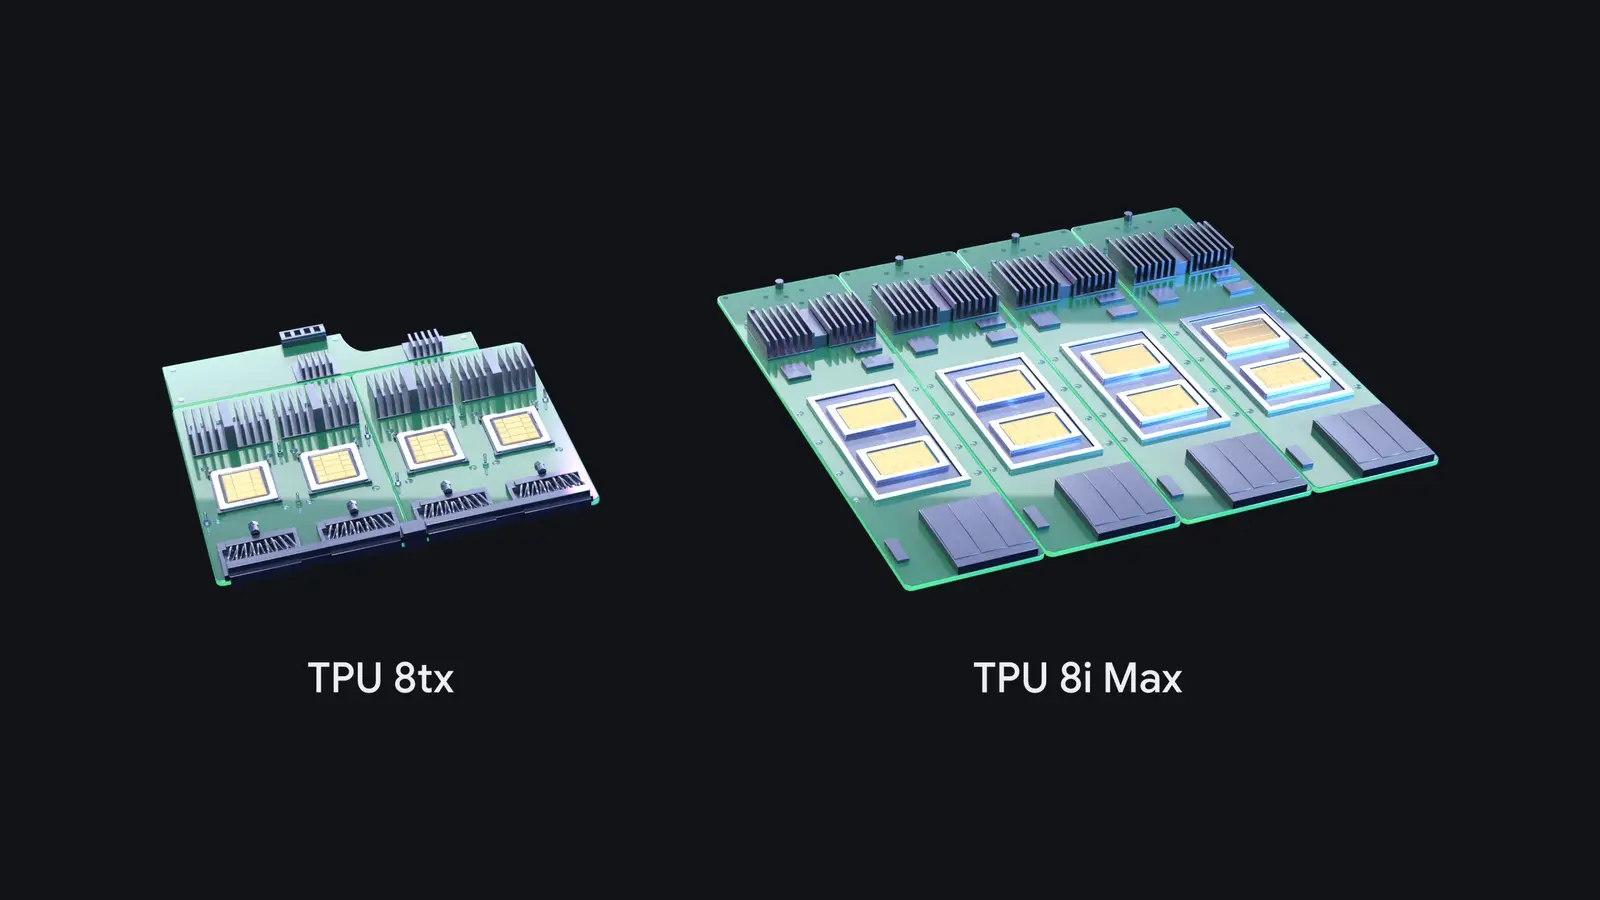
Google 9 ноября добавила в восьмое поколение TPU ещё две системы: TPU 8i Max для длинного контекста и максимальной плотности стойки и TPU 8tx для защищённого инференса на чувствительных данных, говорится в блоге Google. Новых чипов в них нет: обе собраны на кремнии TPU 8t и 8i, поэтому новое здесь в упаковке, сети и защите данных, а каждая цифра прироста идёт от самой Google и сравнивает системы с её же 8i и 8t.
Разницу между чипом и системой Google проводит так: новый чип означает многолетний цикл проектирования и производства, а система определяет, как вокруг чипа собраны вычисления, память, сеть и хранилище. TPU с самого начала строили как модульные блоки AI Hypercomputer, и компания обещает специализированные суперкомпьютеры «за месяцы, а не годы». TPU 8t и 8i показали на Google Cloud Next 22 апреля, и меньше чем через семь месяцев к ним добавились две системы на том же кремнии: свои месяцы Google уже уложила. Четыре системы TPU за год у компании впервые, клиентов у TPU, по её словам, почти сто, от frontier-лабораторий до трейдинговых фирм и университетов.
Два чипа 8i в одном корпусе
TPU 8i Max рассчитан на случай, когда десятки агентов одновременно разбирают целую кодовую базу или часы видео и упираются в пропускную способность памяти. Google поставила два чипа TPU 8i в один корпус. Против одиночного 8i система даёт вдвое больше вычислений, вдвое больше SRAM и вдвое большую пропускную способность HBM, а в прежний габарит стойки помещается вдвое больше кремния, так что на единицу площади и на ватт приходится существенно больше вычислений.
Сам TPU 8i Google описывает как чип, который сокращает задержки обмена между чипами до половины. Как объясняет StackFutures, 8i жертвует запасом вычислений ради пропускной способности памяти и задержки и отдаёт токены из SRAM, не тратя время на обращения к HBM. В 8i Max удваивается как раз этот быстрый слой памяти, вместе с вычислениями и HBM.
Что защищает TPU 8tx
Данные обычно шифруют при хранении и передаче по сети, но для обработки их приходится расшифровывать в памяти. TPU 8tx переносит защиту на уровень железа: данные и веса модели остаются защищёнными и изолированными и во время вычислений. Система построена на том же кремнии, что TPU 8t, а хостами служат процессоры AMD EPYC пятого поколения. В апрельском техническом разборе в блоге Google Cloud хостами восьмого поколения назывались собственные Arm-процессоры Google Axion.
От TPU 8i система взяла сеть Boardfly с низкой задержкой. По словам Google, задержка у 8tx до 2 раз ниже, чем у TPU 8t, а потери производительности почти нулевые. Обучающий кремний рядом с быстрой сетью инференса нужен, чтобы запускать и дообучать модели на одной системе: fine-tuning на закрытых данных, дистилляция больших моделей в малые и обучение агентов с подкреплением идут без переноса чувствительных данных между отдельными кластерами. Для небольшого обучения Google тоже называет 8tx подходящей.
Адресаты - регулируемые компании и госструктуры, которые держат frontier-модели или собственные модели и автономных агентов рядом с самыми чувствительными данными. Такие клиенты, объясняет Google, сами просили специализированное шифрование под отдельные задачи.
Что меняется для разработчика
Железо Google выпускает вместе со стеком, задача которого сделать TPU таким же простым в работе, как железо общего назначения. В прошлом месяце компания открыла исходники TorchTPU: код на PyTorch и модели с Hugging Face запускаются на TPU нативно, без переписывания, а для движков инференса vLLM и SGLang есть готовые бэкенды. Набор open-source агентов для TPU в превью подключается к Claude Code, Cursor и Google Antigravity, переносит проект на TPU за минуты, ищет узкие места и настраивает собственные ядра по запросам на обычном языке. Google также утверждает, что связка vLLM и TorchTPU показала лучшее соотношение цены и производительности на бенчмарках InferenceX и AgentX, где проверяют агентное программирование и работу с длинным контекстом.
Под длинный контекст компания открывает TPU Sync. Он собирает HBM чипа, DRAM хоста, общее хранилище и сеть дата-центра в одну иерархию памяти: за миллисекунды выносит KV-кэш с чипа, передаёт контекст между узлами prefill и decode и синхронизирует веса при обучении с подкреплением. Задержку передачи KV-кэша и время до первого токена он, по словам Google, сокращает больше чем на 90%. Agent Compute Engine за миллисекунды приостанавливает агентские сессии, которые ждут ответа базы, внешнего инструмента или человека, и уводит их рабочую память с чипа.
Два инструмента уже в общем доступе. Cloud Pathways на GKE даёт клиентам Google Cloud рантайм Google DeepMind, на котором работает Gemini: из одного контроллера можно управлять большими системами TPU из нескольких слайсов как одной машиной. Динамическая нарезка в GKE на оптической коммутации собирает кубы TPU в большие топологии или делит их на изолированные части на лету, и, по словам Google, запуск задач ускоряется до 5 раз, а восстановление после сбоев до 4,5 раза.
Когда TPU 8tx и 8i Max станут доступны и сколько будут стоить, Google не сообщила. Базовые 8t и 8i, по словам StackFutures, в апреле открыли для заявок на превью, а общий доступ к ним ожидается позже в 2026 году.
Дальше
Goldman Sachs оставила Claude Code только инженерам
Claude Code и GitHub в Goldman Sachs оставили только инженерам, а их больше 12 000 из примерно 47 000. Трейдеры и банкиры при этом строили с ними модели рынка и следили за потоками клиентских сделок. Агенты для кода у вас в компании есть у всех или только у разработчиков?
Читайте также
- TPU Sync от Google переносит KV-кэш за 230 мс вместо секунд
- Microsoft переводит свои ИИ-сервисы на собственные чипы Maia
- Чип Frozen v2 обещает эффективность в 6–10 раз
- 15 миллиардов на кампус в Техасе под гарантии Google
- Четыре облака собрали песочницы для агентов на разных стеках
- Google ограничила Meta доступ к Gemini
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.