
METR видит у Anthropic двукратное ускорение ИИ-разработки
Сотрудники METR одиннадцать недель разбирали внутренние данные Anthropic и, как сказано в отчёте METR от 5 ноября, пришли к выводу, что Anthropic сейчас улучшает модели на чётко поставленных задачах примерно вдвое быстрее, чем с марта 2024 по октябрь 2025 года. Подробно в публичной версии расписан лишь один замер, ускорение бенчмарк-индекса AECI в 1,9 раза, а доля ИИ в этом ускорении и вывод об отсутствии узких мест держатся на суждении METR и на данных, которые Anthropic вычеркнула.
Двукратную оценку разделяет большинство работавших над проектом сотрудников METR, но внутри команды есть разногласия, и авторы не удивятся, если реальное ускорение окажется ближе к 1,3 или к 3 разам. Около 80% нынешнего ускорения, по их догадке, дают ИИ-инструменты, которыми Anthropic широко пользуется в собственных исследованиях. Рост вычислений на обучение ускорение не объясняет: в этом METR уверена, хотя подробности доказательств тоже убраны. Сама METR признаёт, что отчёт не даёт прозрачности в доказательствах и публике приходится полагаться на её суждение «гораздо больше, чем было бы идеально».
Откуда 1,9
AECI - версия Epoch Capabilities Index, которую ведёт Anthropic: индекс сводит результаты многих бенчмарков в одну оценку силы модели. METR провела через оценки моделей Anthropic прямую с одним изломом, модель сама нашла его на 7 октября 2025 года, и сравнила наклон до и после. После излома индекс растёт в 1,9 раза быстрее, 95-процентный доверительный интервал 1,5-2,8. За последний год Anthropic, выходит, продвинулась на бенчмарках так же, как с октября 2023 по октябрь 2025 года, примерно от Claude 2.1 до Sonnet 4.5. Интервал учитывает только погрешность оценок самих моделей, но не то, какие модели попали в выборку.
В системной карточке Haiku 5.5 ускорение было 1,7 раза. Разницу METR объясняет в основном внутренними моделями, которых нет в публичном доступе: Model 2 закончила обучение в июле 2026 года, Model 3 в августе-сентябре, Model 4 в сентябре-октябре. Модели датированы днём, когда ими смогло пользоваться большинство сотрудников Anthropic, и при такой датировке ускорение выходит чуть выше, потому что новые модели компания держит у себя до публичного релиза немного дольше. Новые точки, по оценке METR, делают постоянный излом тренда правдоподобнее гипотезы из прежних системных карточек о разовом скачке на Mythos Preview, после которого рост вернулся к старому темпу. В посте TestingCatalog в Threads обратили внимание, что на графике отчёта Opus 5.5 отнесена к «нефронтирным» моделям, а выделены внутренние Model 3 и Model 4.
Из четырёх проверок устойчивости сильнее всего результат зависит от функции связи: предположения о том, как распределена сложность задач внутри бенчмарка. При стандартной логистической функции выходит 1,9 раза. Если считать, что в бенчмарках длинный хвост лёгких задач, например много угадываемых, точечная оценка падает до 1,1 раза с интервалом 0,8-1,5. Если хвост из немногих очень трудных задач, она растёт до 2,9 раза с интервалом 2,1-4,9. Данные все варианты, кроме одного, описывают почти одинаково хорошо, и логистическую функцию METR оставила как принятую по умолчанию у Epoch и Anthropic. Выбор снимков моделей, набора бенчмарков и регуляризации двигает оценку только в пределах 1,9-2,2.
Если добавить модели других компаний, ускорение снижается до 1,4 раза. Одно прочтение: в 2025 году модели Anthropic отставали от передового края, исторический темп компании был занижен, и точнее как раз 1,4. Другое: если модели Anthropic меньше подогнаны под бенчмарки, то завышен исторический тренд остальных, и ближе к истине 1,9.
Есть и проблема насыщения. Model 4 набирает больше 50% на всех 15 бенчмарках, на которых её проверяли, тогда как девять месяцев назад у Opus 4.6 было много бенчмарков с результатом ниже 50%. Нехватка трудных для Model 4 тестов авторов, по их словам, «несколько нервирует»: с ней сложнее мерить индекс сейчас и дальше.
Сколько здесь ИИ
Консенсуса о причинах ускорения нет даже среди сотрудников Anthropic. Ускорение конца 2025 года, по оценке METR, вероятно, связано и с факторами помимо ИИ, но их детали вычеркнуты, а к октябрю 2026 года роль ИИ, как считают авторы, выросла.
Самые яркие цифры здесь самые слабые. В опросах в Slack, где сотрудники голосуют реакциями, средний самооценённый прирост продуктивности от самой сильной внутренней модели в октябре 2026 года дошёл примерно до 12 раз. METR считает их очень грубым сигналом: отвечает нерепрезентативная часть сотрудников и без особых раздумий. К тому же индивидуальный прирост сам по себе не равен ускорению прогресса: для двукратного ускорения нужно, чтобы ускорился рост вложений вроде труда и его продуктивности, поэтому METR смотрит на изменение темпа этих самооценок, а не на их уровень.
Интервью дают более сдержанную картину. Цитаты одиннадцати исследователей по просьбе METR разметил Claude: двое поддерживают ускорение больше чем в 2 раза в своей области, трое склоняются к этому, у четверых ответ неясен, двое против. Исследователь A говорит, что «однозначно» готов подтвердить ускорение больше чем в 2 раза и не считает безумной цифру 4. Исследователь L приписывает ИИ 15-20% и добавляет: «Не верю в самооценки роста продуктивности». Один из двух несогласных главной причиной называет найм.
Ускоряют исследования в основном как помощник людей. Полностью самостоятельно ИИ пока не вносит весомого вклада в важнейшие части обучения моделей, но исследователи описывают «признаки жизни», которые, по их словам, говорят о скором появлении такого вклада. Отдельно METR отмечает, что Claude участвовал в сборе и анализе большей части полученных ею данных и в большей части её собственного анализа; систематических расхождений с живыми интервью авторы не нашли.
Узких мест не нашли
На ближайшие 12 месяцев METR не увидела серьёзных ограничений ни в алгоритмах, ни в вычислениях на обучение и эксперименты, ни в данных. Отсюда её вывод о значимом риске, что дальнейший рост возможностей ускорит прогресс ещё сильнее. Уверенности в этом нет: представление авторов об узких местах несколько раз менялось по мере того, как приходили подробности, а разбор ряда конкретных ограничений Anthropic вычеркнула.
Ошибку METR допускает в обе стороны. Ускорение может быть выше, если рост гиперболический: в трендах AECI этого не видно, но на это указывают другие данные, тоже вычеркнутые, а модели вообще видны с задержкой примерно на время обучения. Ниже оно может оказаться, если ускорение держится только на задачах, которые легко проверить автоматически, или если исторический темп Anthropic был необычно низким.
Что осталось за вычёркиванием
Право вычеркнуть любую непубличную информацию у Anthropic было без условий, и она убрала большую часть доказательств, которые METR сочла самыми информативными: оценки ускорения по этапам обучения, разбивку вклада вычислений, данных и алгоритмов, прогнозы метрик будущей модели. Свои правки Anthropic объяснила тем, что они «направлены на удаление конфиденциальной информации, которая могла бы ускорить других разработчиков ИИ». Указания по вычёркиванию она дала 25 октября, а 27-29 октября ужесточила их, после чего стороны договорились о продлении примерно на пять дней, и финальную версию METR сдала 3 ноября. По ходу работы над отдельным обзором отчёта Anthropic о рисках компания давала замечания, которые METR в ряде случаев сочла чрезмерно настойчивыми.
В проверке участвовали сотрудники METR суммарно на 2,5 полной ставки. Они работали на устройствах Anthropic, провели около 15 интервью и запросов к непубличным моделям не делали; денег METR не брала, токены получила бесплатно. Предоставленный доступ, по словам METR, превзошёл её ожидания. Одна участница команды в начале проекта обсуждала с Anthropic возможную работу, получила предложение и отказалась, к тому же владела долей в конкуренте как бывшая сотрудница, поэтому её работу перепроверял коллега без конфликта интересов.
METR отдельно оговаривает, что этот проект не связан со схемой, о которой Anthropic объявила 15 октября: там шестеро из METR получают доступ, близкий к доступу сотрудников, а вычеркивать Anthropic может лишь узкие категории данных. В нынешней проверке доступа «как у сотрудника» не было по замыслу обеих сторон, а оправданность вычёркиваний METR оценивать не стала.
По договору в задание входила и проверка того, какую долю вычислений Anthropic тратит на возможности моделей, а какую на безопасность. Посреди работы, до того как METR пришла к каким-либо выводам, Anthropic исключила этот пункт: компания объяснила, что пока хочет сосредоточить работу на оценке рисков, и пообещала вернуться к проверке распределения вычислений позже.
Дальше
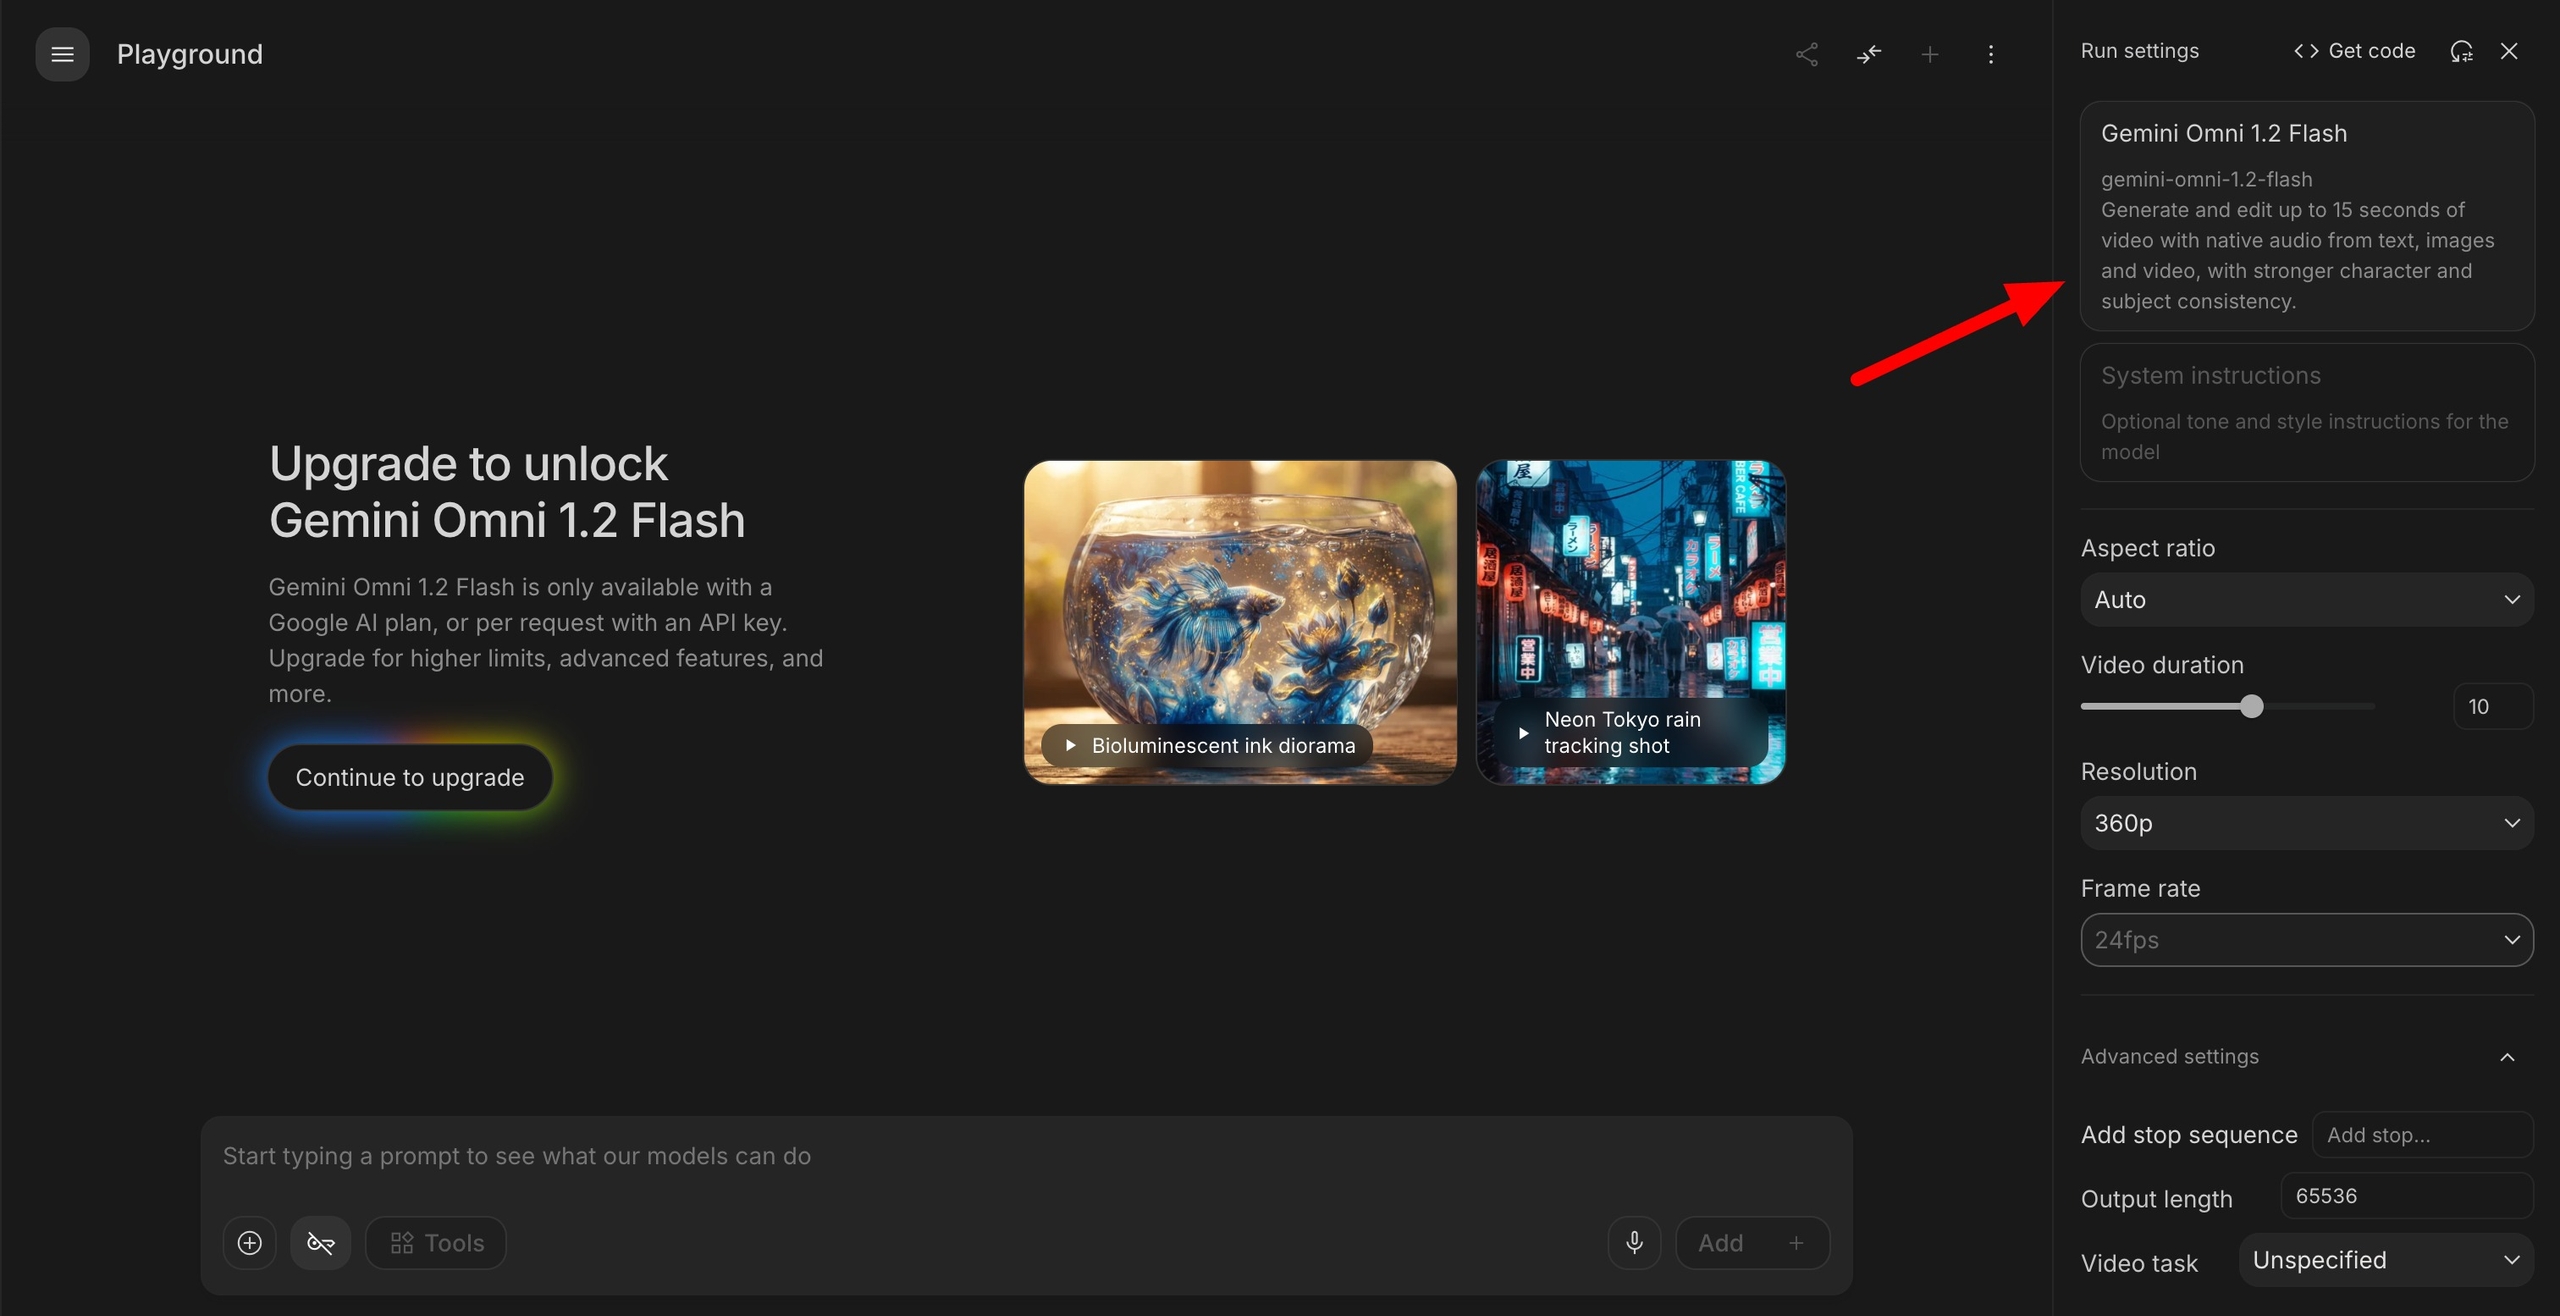
Gemini Omni 1.2 Flash подешевела на 30% и снимает 15 секунд
Gemini Omni получила ролики по 15 секунд вместо 10 и цену на 30% ниже: версия 1.2 Flash стоит 0,07 доллара за секунду 720p-видео. При этом Google сама пишет, что быстрый спорт и сложная физика у модели ещё в доработке. Какой длины ролики вам обычно нужны: до 10 секунд или длиннее?
Читайте также
- METR и Redwood три недели искали дыры в мониторинге OpenAI
- Шесть экспертов METR получили в Anthropic доступ сотрудников
- Прототип Anthropic доказывает, какая модель написала ответ
- В песочнице Claude нашли бинарник Anthropic и токен Google
- Модель Anthropic превратила баг ядра Linux в удалённый root
- Claude Fable 5 сам проверяет свои диалоги на злоупотребления
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.