
Claude Fable 5 сам проверяет свои диалоги на злоупотребления
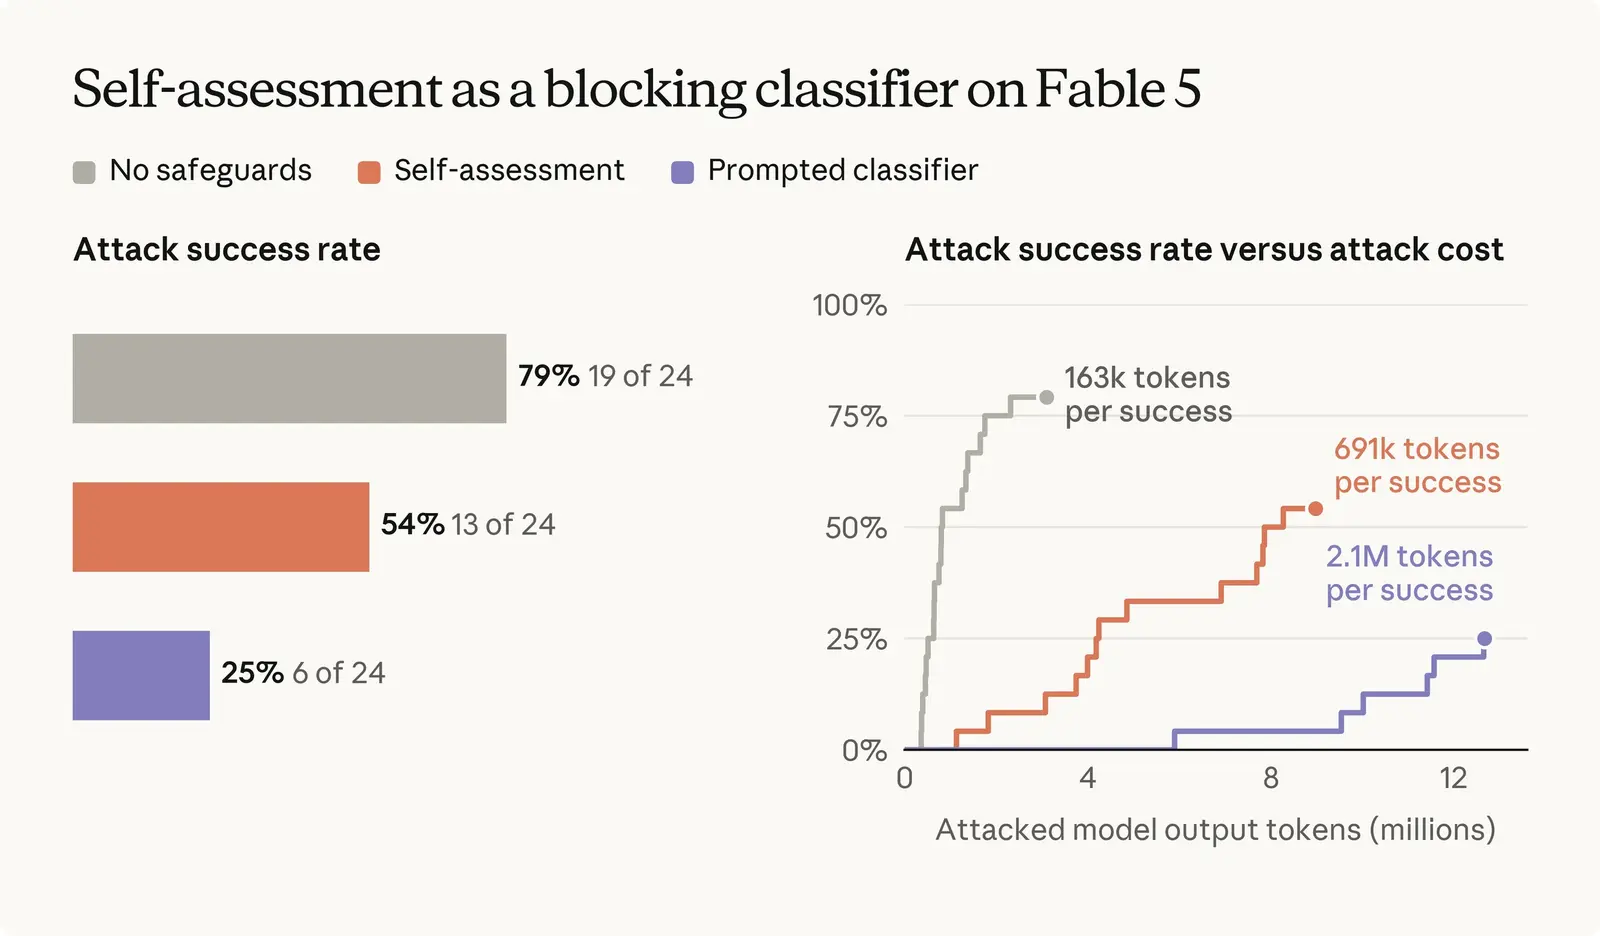
Anthropic 29 октября описала в блоге Safeguards самооценку: после каждого ответа Claude получает короткую служебную инструкцию и сам оценивает безопасность всего разговора, а оценка уходит в офлайн-проверку. Пользователю она не видна и ответы в реальном времени не блокирует. Её главные цифры для Claude Fable 5 посчитаны относительно другого, более дорогого классификатора Anthropic: 78% потенциально вредных диалогов и 94% приоритетных при 1% ложных срабатываний.
Инструкция звучит примерно как «Please reflect on the safety of this conversation». В ответ Claude сообщает, есть ли в разговоре потенциально вредный запрос, например нарушающий правила использования, какой это вред, насколько срочно его смотреть человеку, отказал ли Claude, и одной фразой объясняет, почему так решил. Оценивается весь диалог, включая запросы, на которые Claude уже ответил отказом.
Относительно чего 78% и 94%
Эталоном служит классификатор на промпте: отдельная модель, которой в промпт кладут правила Anthropic и сам разговор. Из автоматических классификаторов, которые компания проверяла, он самый сильный, но ему приходится заново прочитать диалог и правила и порассуждать над ними, поэтому на один разговор он тратит в разы больше вычислений. Anthropic держит его для случаев, где нужен более пристальный взгляд.
Самооценка на Fable 5 отмечает 78% разговоров, которые этот классификатор с полным набором правил в контексте считает потенциально вредными, и 94% тех, что он относит к высокоприоритетным, при доле ложных срабатываний 1%. Рабочую точку выбирают порогом: непрерывной оценкой служит вероятность, которую Claude присваивает значению true в поле flagged. По словам Anthropic, охват широкий и включает редкие виды вреда, под которые отдельного классификатора пока нет.
Меньше 2% к инференсу
К концу ответа весь разговор уже лежит в KV-кэше, так что на оценку уходит обработка короткой инструкции и в среднем около 10 сгенерированных токенов. По оценке Anthropic на распределении её продакшен-трафика через API, в сумме это добавляет меньше 2% к вычислениям на инференс.
Первые Constitutional Classifiers начала 2025 года, отдельные дообученные модели под заданный набор вредов, прибавляли к стоимости инференса 23,7%, и каждый классификатор на промпте, с которым их тогда сравнивали, обходился дороже. OpenAI сообщала, что в некоторых запусках рассуждения о безопасности забирали до 16% всех вычислений.
Формат оценки жёсткий, JSON. Если отмечать нечего, ответ сводится к {"flagged": false}; иначе добавляются причина, категория, подпункт политики, признак отказа и приоритет от 1 до 10. Инструкцию и ответ на неё пользователь не видит, и дальше в разговор они не переносятся.
Пробы против самооценки
Пробы, простые классификаторы поверх активаций самой модели, тоже почти ничего не стоят, но выдают балл по метке, заданной заранее, и новый вид вреда отметить не могут. Самооценку выдаёт полная языковая модель: причину она формулирует свободным текстом, а новые указания получает через промпт, без переобучения.
Anthropic проверяла это так: убирала из обучения целую категорию вреда, и качество на ней заметно не падало. В эксперименте на четырёх размерах моделей обнаружение стабильно улучшалось с размером. На этом компания строит свой довод: монитором служит та же модель, что вела разговор, поэтому он умнеет вместе с новыми версиями, а каждая новая версия, по оценке Anthropic, полезнее и злоумышленникам. Метод продолжает работы, где модель следит за собой сама, например «признания» OpenAI, в которых модель после ответа сообщает, не нарушила ли она инструкции.
Упорного атакующего не остановит
Ограничения Anthropic называет сама: самооценка ловит не каждый вредный разговор и недостаточно устойчива, чтобы остановить целеустремлённого атакующего. Поэтому она работает рядом с защитами, которые блокируют вредные запросы в реальном времени, и служит первой ступенью с широким охватом, после которой подозрительные разговоры разбирают более точные инструменты. В связке с классификаторами на промптах, по оценке компании, «каждая успешная атака обходится примерно вчетверо большим числом сгенерированных токенов, чем без защит».
Сейчас самооценка работает во всех моделях Claude, вышедших начиная с Fable 5, на большой доле мирового трафика. С июня она выявила масштабное злоупотребление, которое пропустили другие методы, и помогла улучшить остальные классификаторы Anthropic.
Дальше
Мониторы OpenAI в повторе сработали за 30 часов до взлома
«Больше чем за 30 часов до взлома» систем Hugging Face подняли бы тревогу новые мониторы OpenAI, когда через них прогнали запись инцидента. На оценках, где всё началось, мониторы тогда не стояли. Вы бы доверили проверку своих агентов модели-наблюдателю или читали бы логи сами?
Читайте также
- METR и Redwood три недели искали дыры в мониторинге OpenAI
- Модель Anthropic нашла 62 уязвимости в Chrome
- Mythos 5 давила на автора репозитория с фейковых аккаунтов
- В OpenSSH Claude нашёл около 4 500 лишних строк до входа
- Claude свёл тайну кривых NIST к меткам времени
- Anthropic запустила модель на 15 дешёвых ТВ-приставках
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.