
Из 34 часов модель потратила на задачу около 40 минут
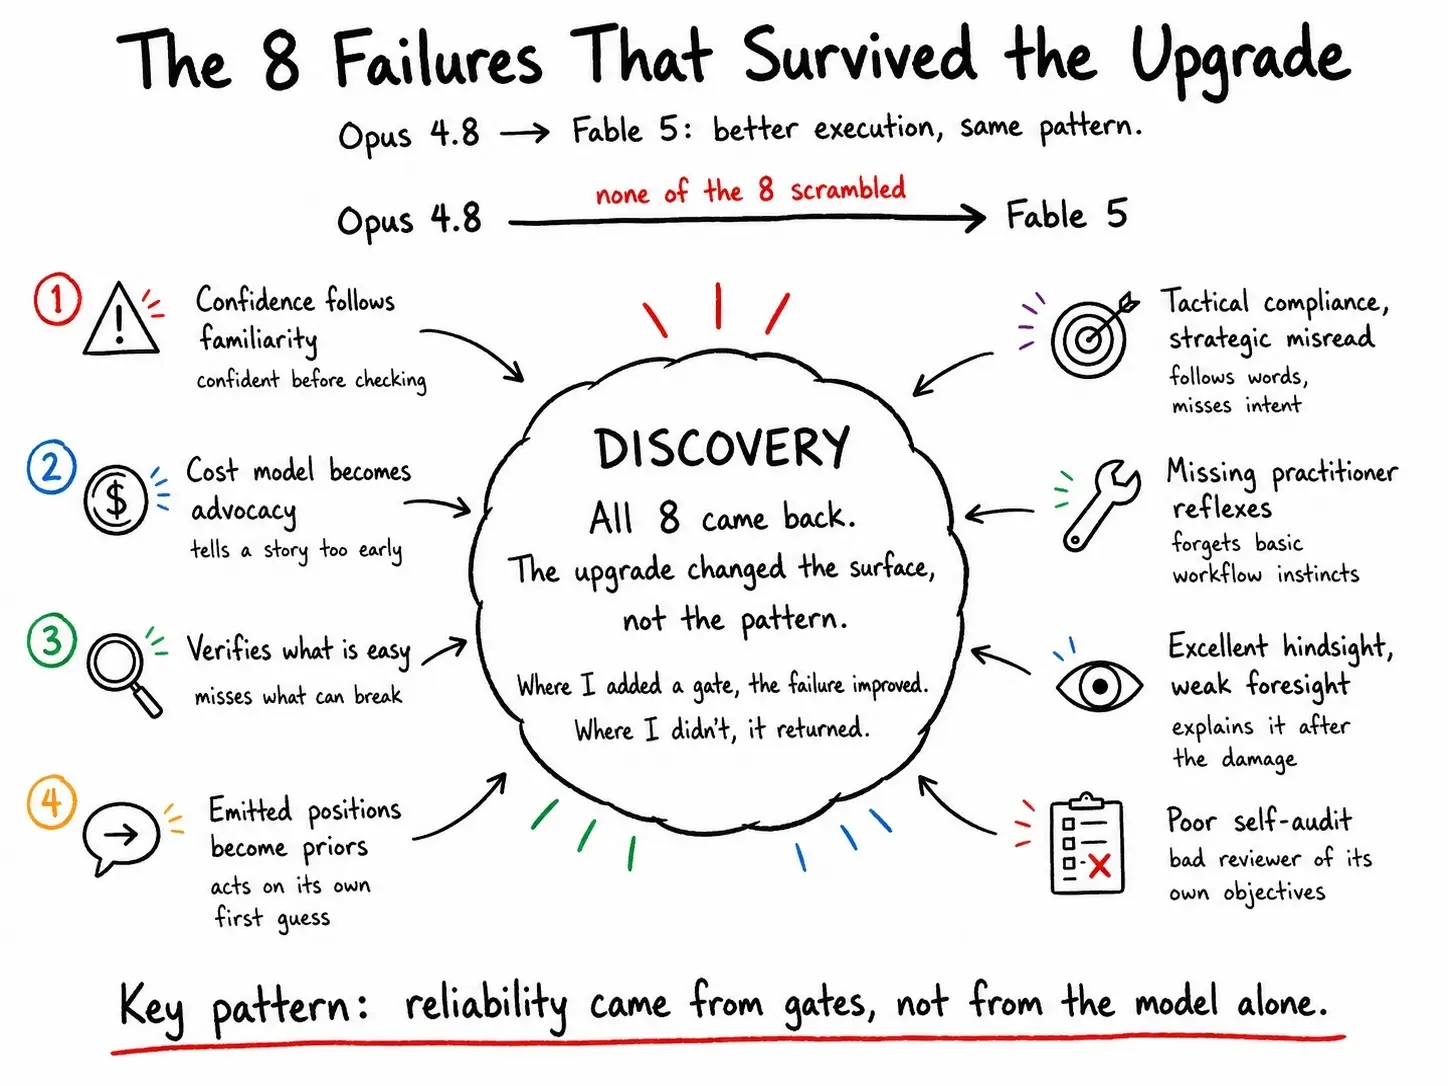
Одну и ту же исследовательскую задачу по self-distillation (обучение модели на её собственных выводах) автор эксперимента прогнал через два поколения моделей на одном железе. Opus 4.8 получил два дня и три сессии, Fable 5 работал 34 часа подряд.
У Opus набралось шесть ошибок в целевой функции, самопроверка не поймала ни одной. В одном эпизоде модель направила проверку из 97 промптов на живой сервер и убила запуск длиной 1,4 часа на 43-м шаге.
Fable 5 писал план перед каждым запуском и поймал баг ещё на этапе проектирования. Но за 34 часа он ни разу не сверился с целью, а на сам исследовательский вопрос ушло около 40 минут.
Все восемь классов сбоев повторились. Anthropic в материале When AI builds itself утверждала, что более 80% кода в её репозитории написал Claude.
Дальше
Накладные расходы авторежима вывели из-под лимитов
«Небольшое количество дополнительных токенов» классификатор авторежима тратит на каждый вызов инструмента по-прежнему, но с сегодняшнего дня они не идут в счёт лимитов на планах Pro, Max и Team.
Читайте также
- Автоисследователь Anthropic обгоняет людей за шесть часов
- Прирост с 34% до 44% дал диалог, а не файлы памяти
- Anthropic нашла четыре новых сценария сбоя AI-агентов
- Гендиректор Anthropic подписал петицию о темпе разработки
- Sonnet 5 выровняла более сильную модель Opus 4.8
- Шифр Уркварта поддался Claude Fable 5.1 за 44 минуты
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.