
Прирост с 34% до 44% дал диалог, а не файлы памяти
Эндрю Джессон выдал Claude Code (Opus 5, усилие xhigh) поток задач из симулированного бизнес-процесса и единственную инструкцию стать лучше. Успех на отложенных задачах вырос с 34% до 44%.
За прогон агент сделал 84 записи и правки, все в файлах памяти. Код он не запускал, подагентов не создавал, поиском не пользовался. Заметки сложились в граф с корректными перекрёстными ссылками, но на 120 отложенных задачах сами файлы дали +1,7 процентного пункта, и доверительный интервал захватывает ноль.
Прирост нёс диалог: запись выполненных задач с полученными оценками даёт +9,9 пункта, сводка после компактификации контекста +5,4 пункта при стоимости $0,14 против $6,33 у полного диалога.
Сессия, стартующая с нуля, решает 41 задачу из 120 за 29,8 хода и $0,86.
Дальше
Sonnet 5 в пробах регулярно называет себя GPT-4
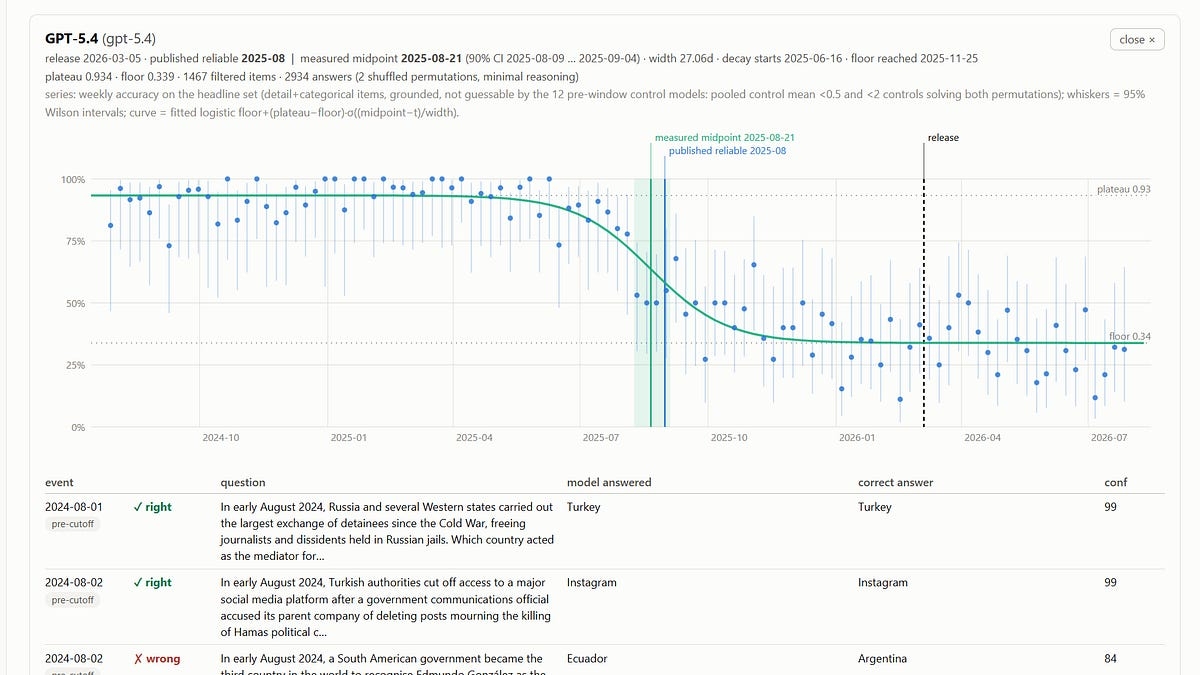
На 50 пробах о названии модели Sonnet 5 регулярно отвечал «GPT-4», а модели OpenAI ни разу не назвались чужой моделью. Автор исследования допускает, что в смесь обучающих данных Claude попали старые чаты ChatGPT.
Читайте также
- Из 34 часов модель потратила на задачу около 40 минут
- Claude и физик за три месяца собрали 36 рукописей
- Тот же результат, вдвое дороже: Claude Code против Codex
- Sonnet 5 выровняла более сильную модель Opus 4.8
- Шифр Уркварта поддался Claude Fable 5.1 за 44 минуты
- Модель Anthropic формализовала теорему Ферма в Lean
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.