
Opus 5.5 обошёл GPT-6 Astra в индексе v5: 58 против 57
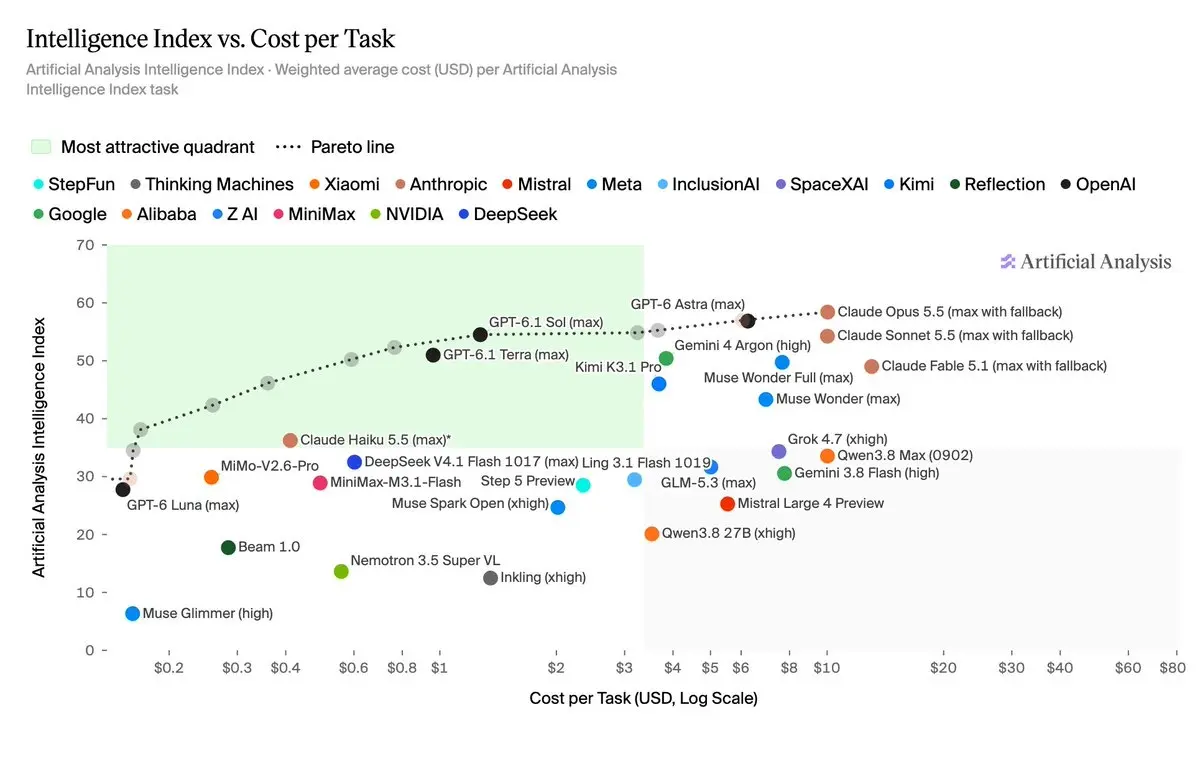
Claude Opus 5.5 в режиме максимальных усилий (max) возглавил пятую версию Intelligence Index, которую Artificial Analysis открыла 28 октября: у него 58 баллов, у GPT-6 Astra (max) 57, у GPT-6.1 Sol (max) 55. Баллы из v5 с прежними версиями индекса напрямую не сравниваются: состав тестов поменялся, а те же 58 баллов Opus 5.5 набирал в сентябре на версии 4.3.2, на другом наборе задач.
Kimi K3.1 Pro при переходе на v5 опустилась с 55 до 46 баллов, а GLM-5.3 с 45 до 32, подсчитали в Capital & Compute. Первую пятёрку делят модели Anthropic и OpenAI, следующей идёт Gemini 4 Argon в режиме high с 50 баллами. Замер сторонний: модели гоняет сама Artificial Analysis, лаборатории свои цифры сюда не присылают.
Новых тестов два. FrontierCode 2.0 - закрытый бенчмарк Cognition из реальных задач по коду, где решение засчитывают, если мейнтейнер репозитория принял бы такое изменение. Terminal-Bench-Science - 70 агентных задач научного исследования в терминале. Ещё три теста обновили: HLE-Diamond заменил Humanity's Last Exam и содержит 1 000 вопросов, поровну на рассуждение и на знания; из AA-Omniscience v1.1 убрали вопросы, на которых модели уже упираются в потолок, и все вопросы публичного набора; CritPt v2 сузили до закрытого набора из 40 сложных задач, которые модель решает с инструментом для выполнения кода. Из индекса ушли GDPval-AA v2, SciCode и AA-LCR, полный перечень есть в журнале изменений.
В v4.3.2 агентные задачи и общие знания давали по 30% итогового балла, код и научные рассуждения по 20%. В v5, по разбору Capital & Compute, четыре категории весят по 25%: Knowledge Work, код, наука и общий блок, а больше всего, по 15%, весят AA-Briefcase, FrontierCode 2.0, Terminal-Bench-Science и AA-Omniscience v1.1. Около 60% веса теперь держится на закрытых наборах или скрытых ответах, в v4.3 было 45%; издание называет это защитой от того, что лаборатории обучают модели на тестах.
Индекс с 6 августа перестраивали пять раз ещё до v5, поэтому балл без версии мало что говорит. Без режима усилий тоже: Artificial Analysis публикует для одной модели варианты max, xhigh, high, medium и low, и результаты у них заметно расходятся. На одной из прошлых версий индекса Claude Opus 5 набирал 52 балла в режиме Thinking Low и 63 в Max (With Tools).
Дальше
Anthropic купила Mithril, биотех из одного сотрудника
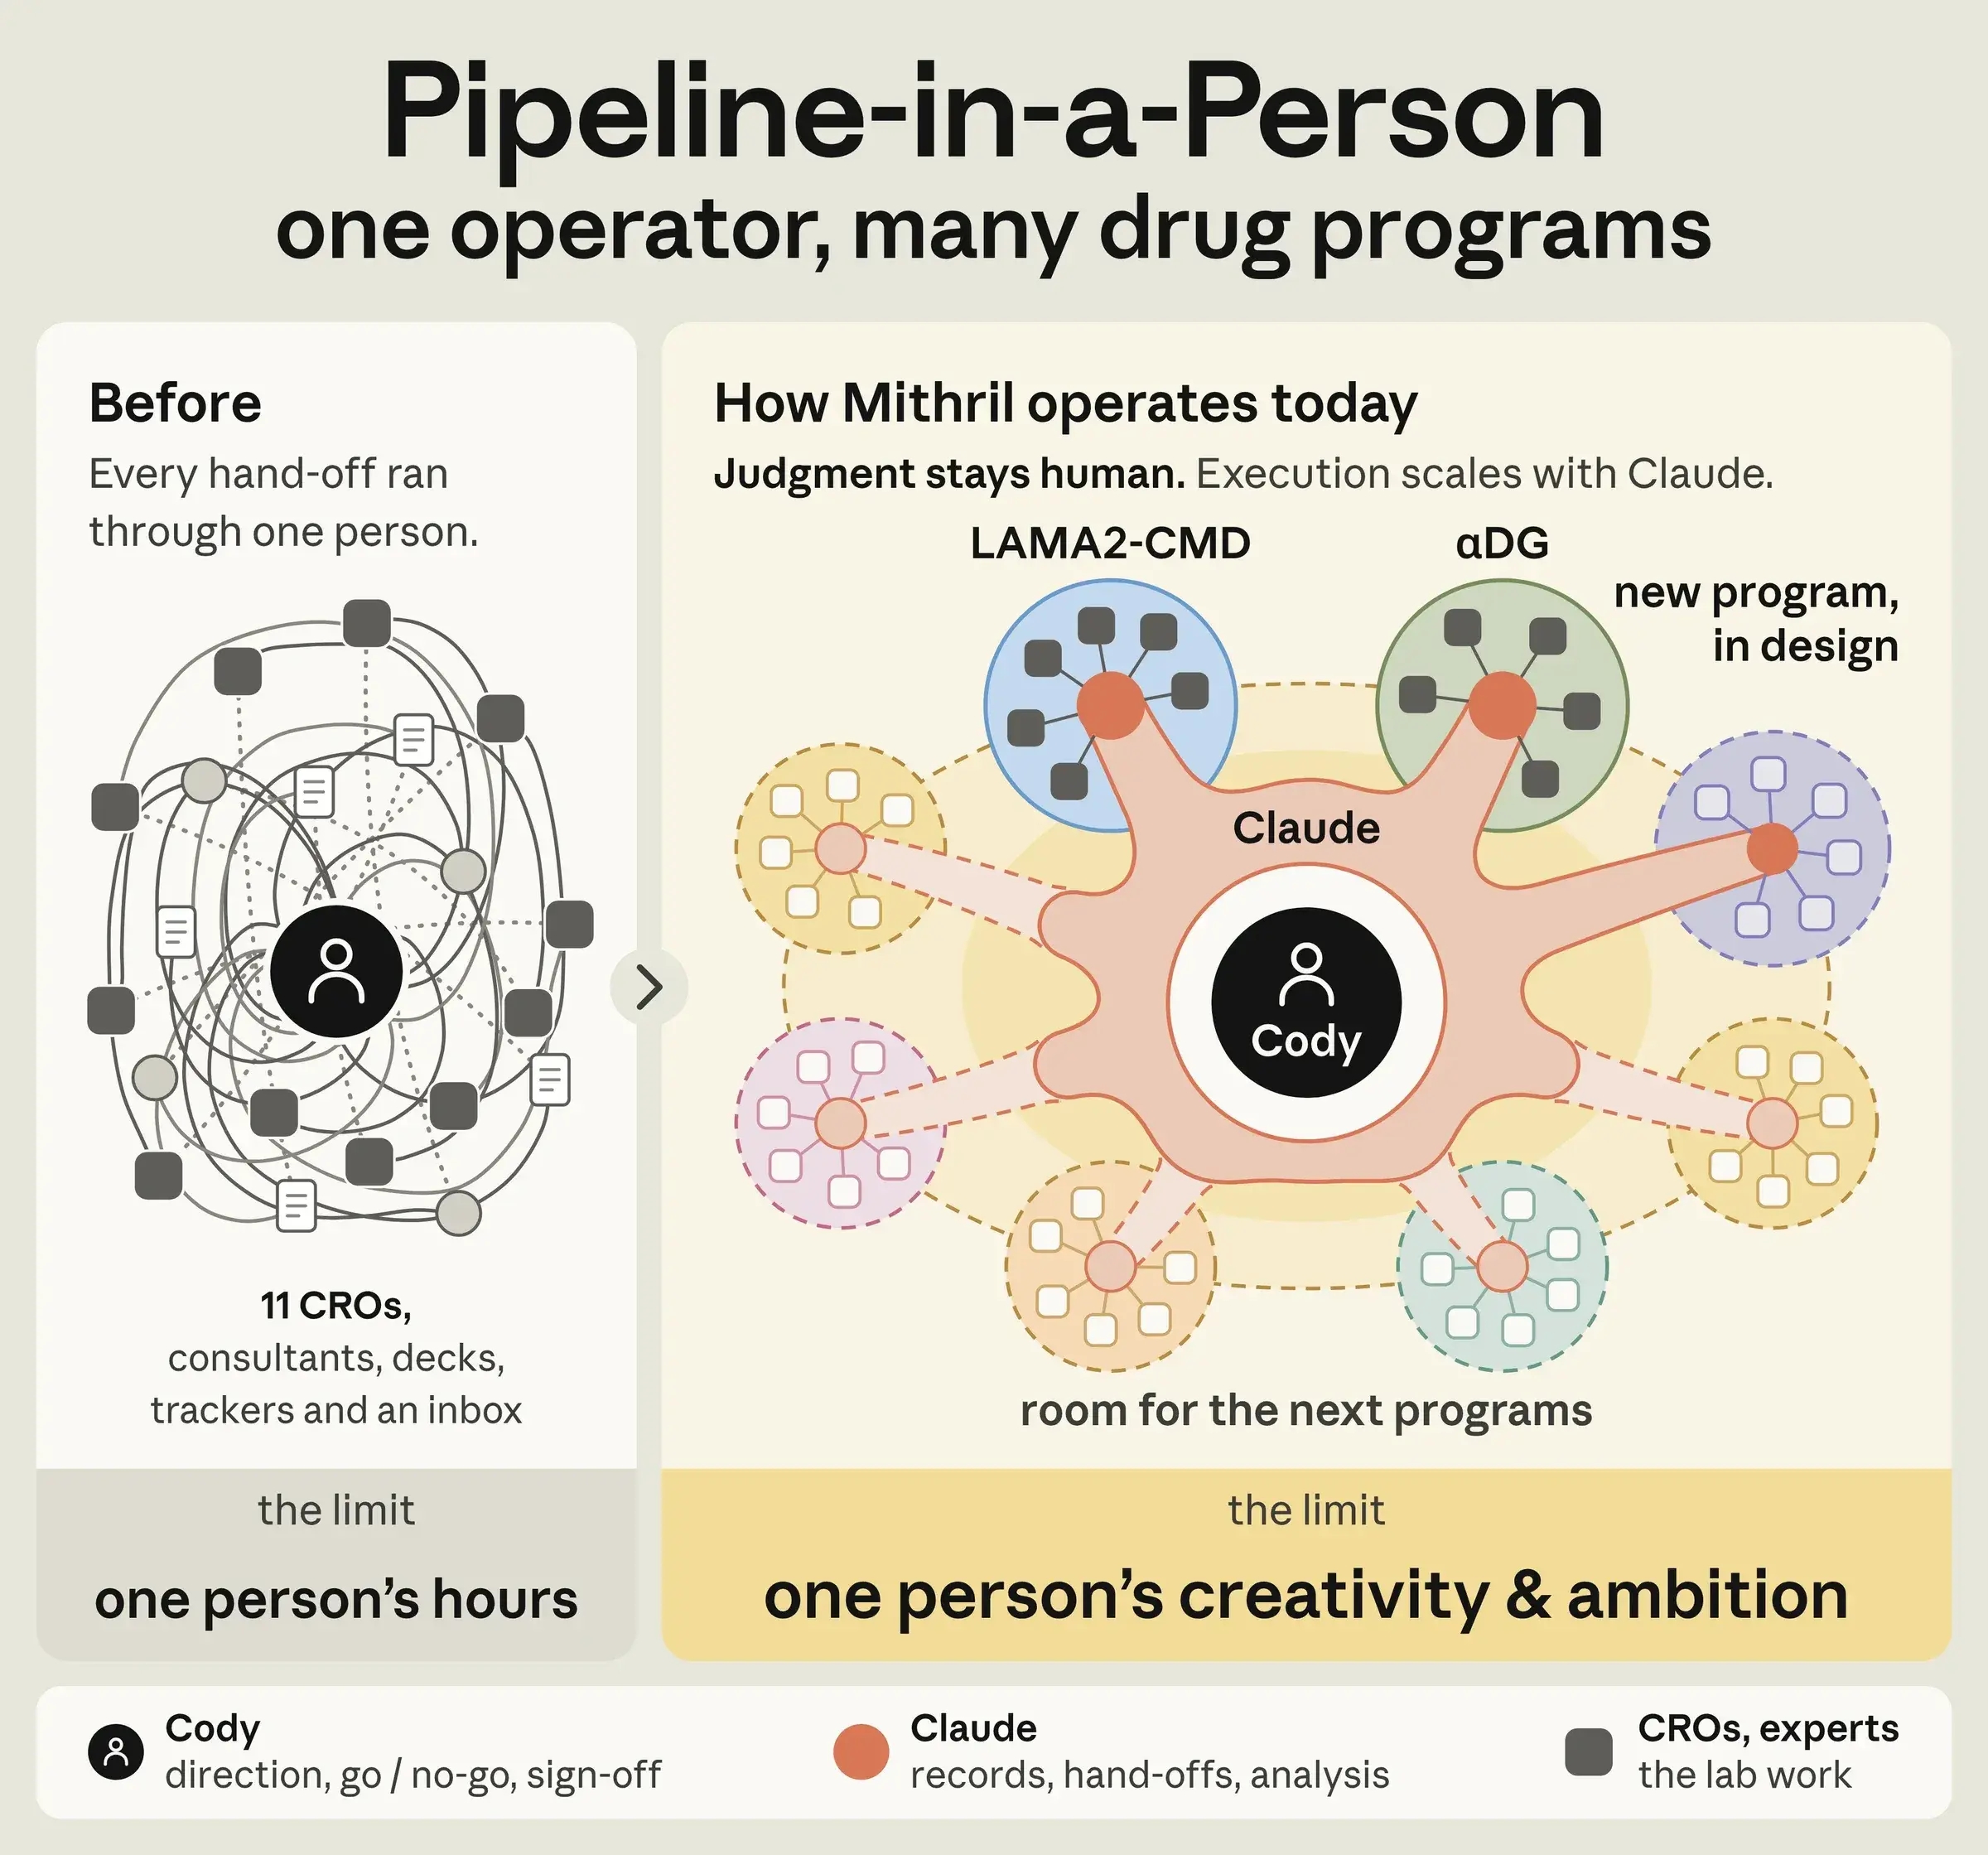
Один сотрудник на всю компанию: основатель Mithril Medicine через Claude вёл контракты, логистику и опыты с 11 внешними лабораториями. Anthropic купила Mithril, и её программы по редким мышечным дистрофиям стали первыми собственными у Anthropic. Скольких внешних подрядчиков вы бы доверили координировать Claude?
Читайте также
- Opus 5.5 возглавил индекс, наговорив 260 млн токенов
- В Vending-Bench GPT-6 Astra впервые обошёл Claude Fable 5.1
- GPT-6 Astra опередил Claude Fable 5.1 на 35 баллов
- Тест на клипе: Claude Fable 5 против GPT-5.6 Sol за $100
- Цены Anthropic и OpenAI упали до 80% за несколько месяцев
- Канцелярия правительства Швеции отключает Claude и ChatGPT
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.