
Предшественник архитектуры Qwen4 вышел как 125B MoE
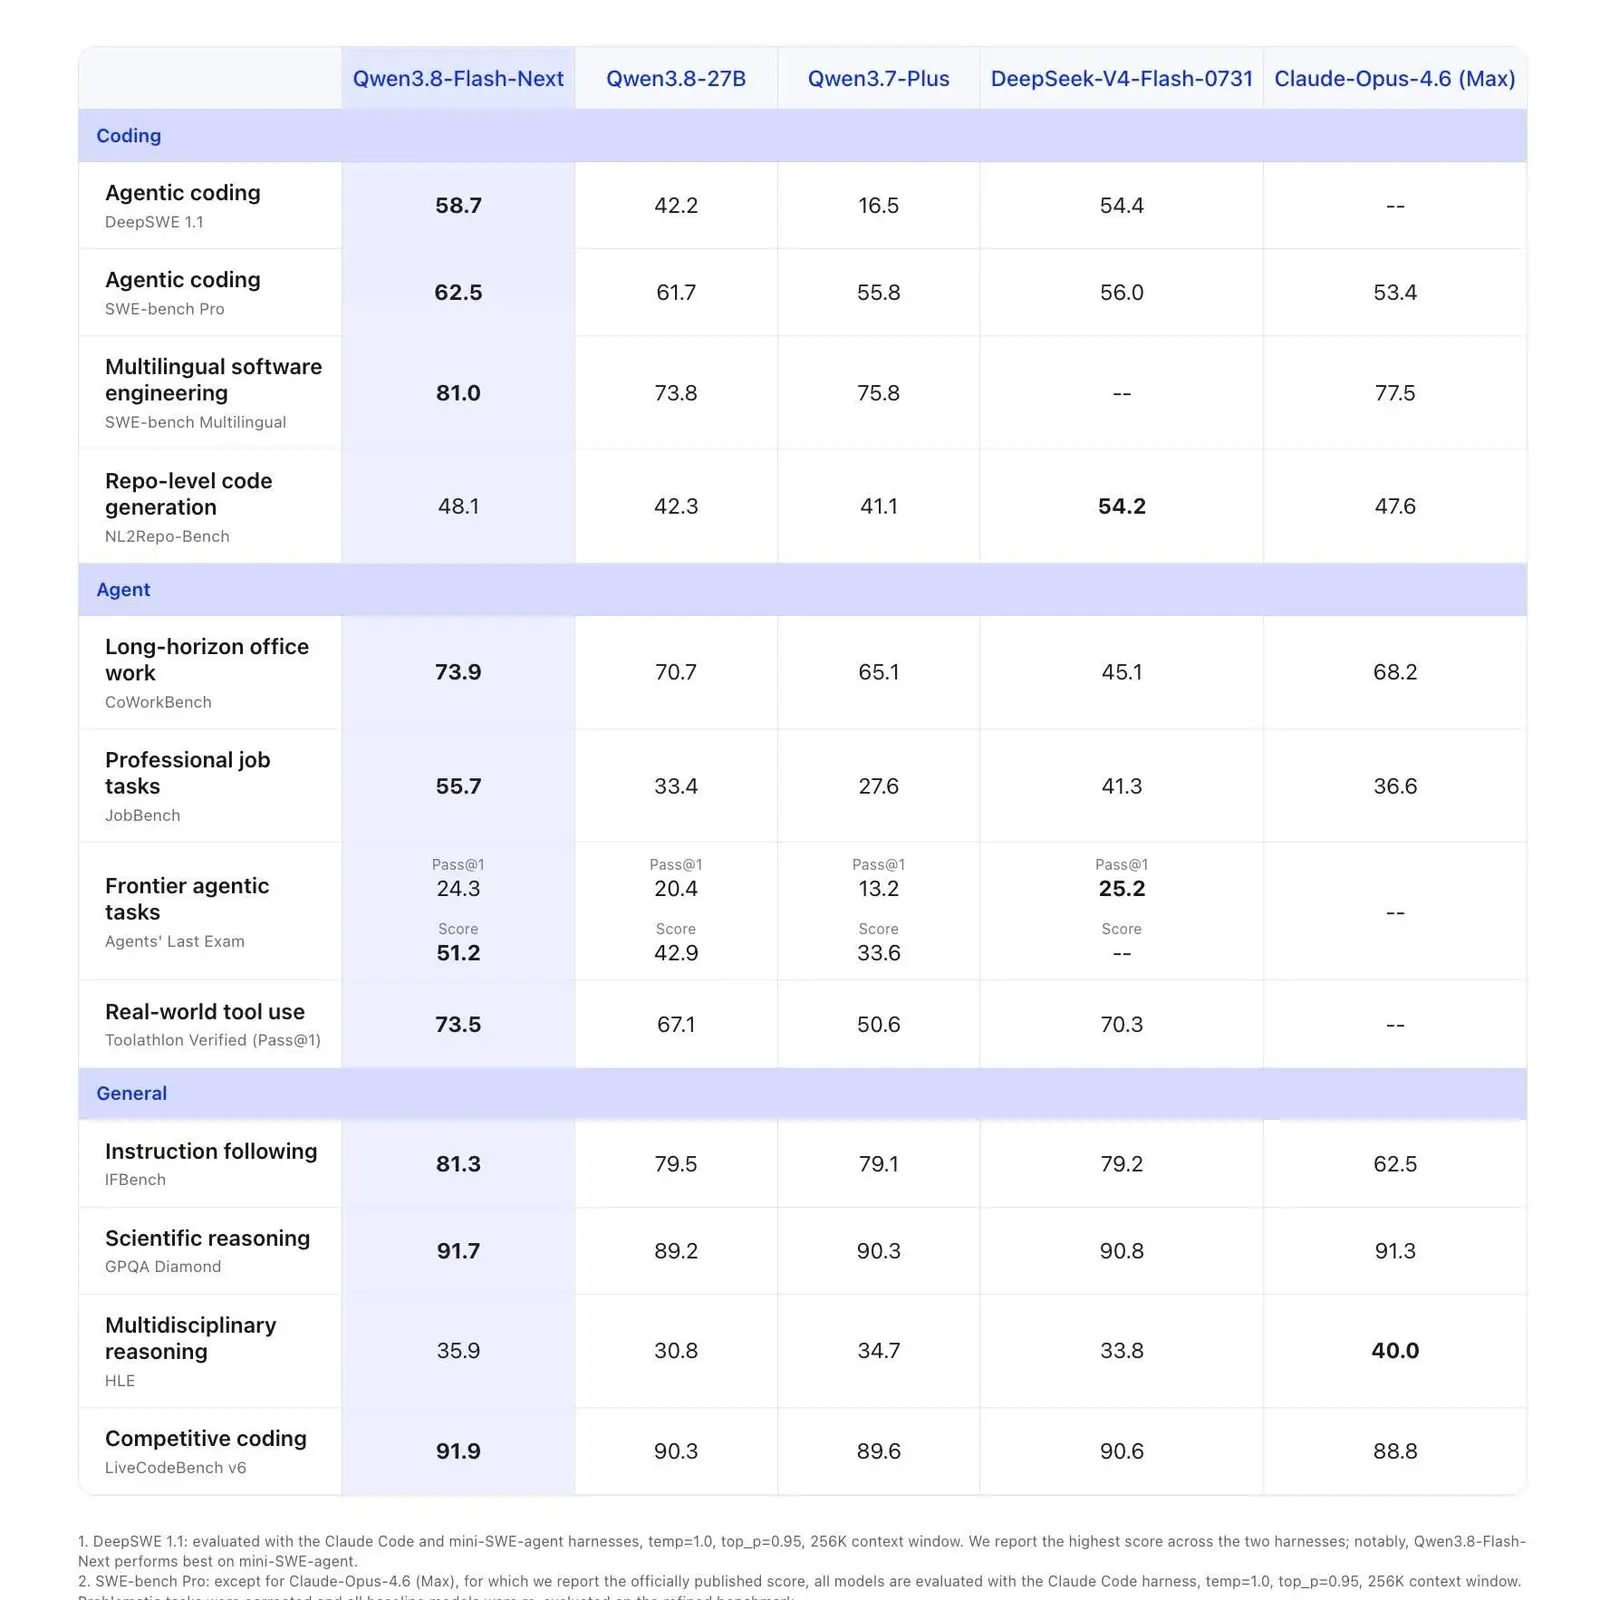
58,7 балла на DeepSWE 1.1 и 62,5 на SWE-bench Pro: такие результаты на агентных бенчмарках программирования Alibaba 26 августа привела для Qwen3.8-Flash-Next. Это мультимодальная MoE-модель на 125 миллиардов параметров. В MoE на каждый токен работает только часть экспертов, а не вся сеть.
Alibaba опубликовала характеристики в Threads, карточка модели лежит на Hugging Face. Нативное окно контекста составляет 262K токенов, через YaRN его растягивают до 1 миллиона. YaRN - метод масштабирования позиционных кодировок, с ним модель работает с текстом длиннее, чем видела на обучении.
В QwenCloud API миллион входных токенов стоит 0,16 доллара, миллион выходных 0,47 доллара.
У плотной Qwen3.8-27B в августе на DeepSWE было 42,2 балла, у Qwen 3.7-Plus 14,2.
Qwen3.8-27B вышла 14 августа под Apache 2.0, она плотная и тоже нативно мультимодальная. Старшая Qwen3.8-2.4T-A95B появилась на Hugging Face и ModelScope 12 августа: 2,4 триллиона параметров, из которых активны 95 миллиардов, и 512 экспертов, из которых на токен включаются 11. Она работает только с текстом и всегда рассуждает.
В репозитории Qwen3.8 на GitHub поколение описано как построенное на фундаменте Qwen3.5: Gated Delta Networks, вариант линейного внимания, у которого затраты растут с длиной контекста линейно, плюс разреженный MoE. В 2.4T-A95B линейное внимание чередуется с обычным полным вниманием. Flash-Next в Alibaba описывают как модель на новой архитектуре, которая станет предшественницей архитектуры Qwen4.
Дальше
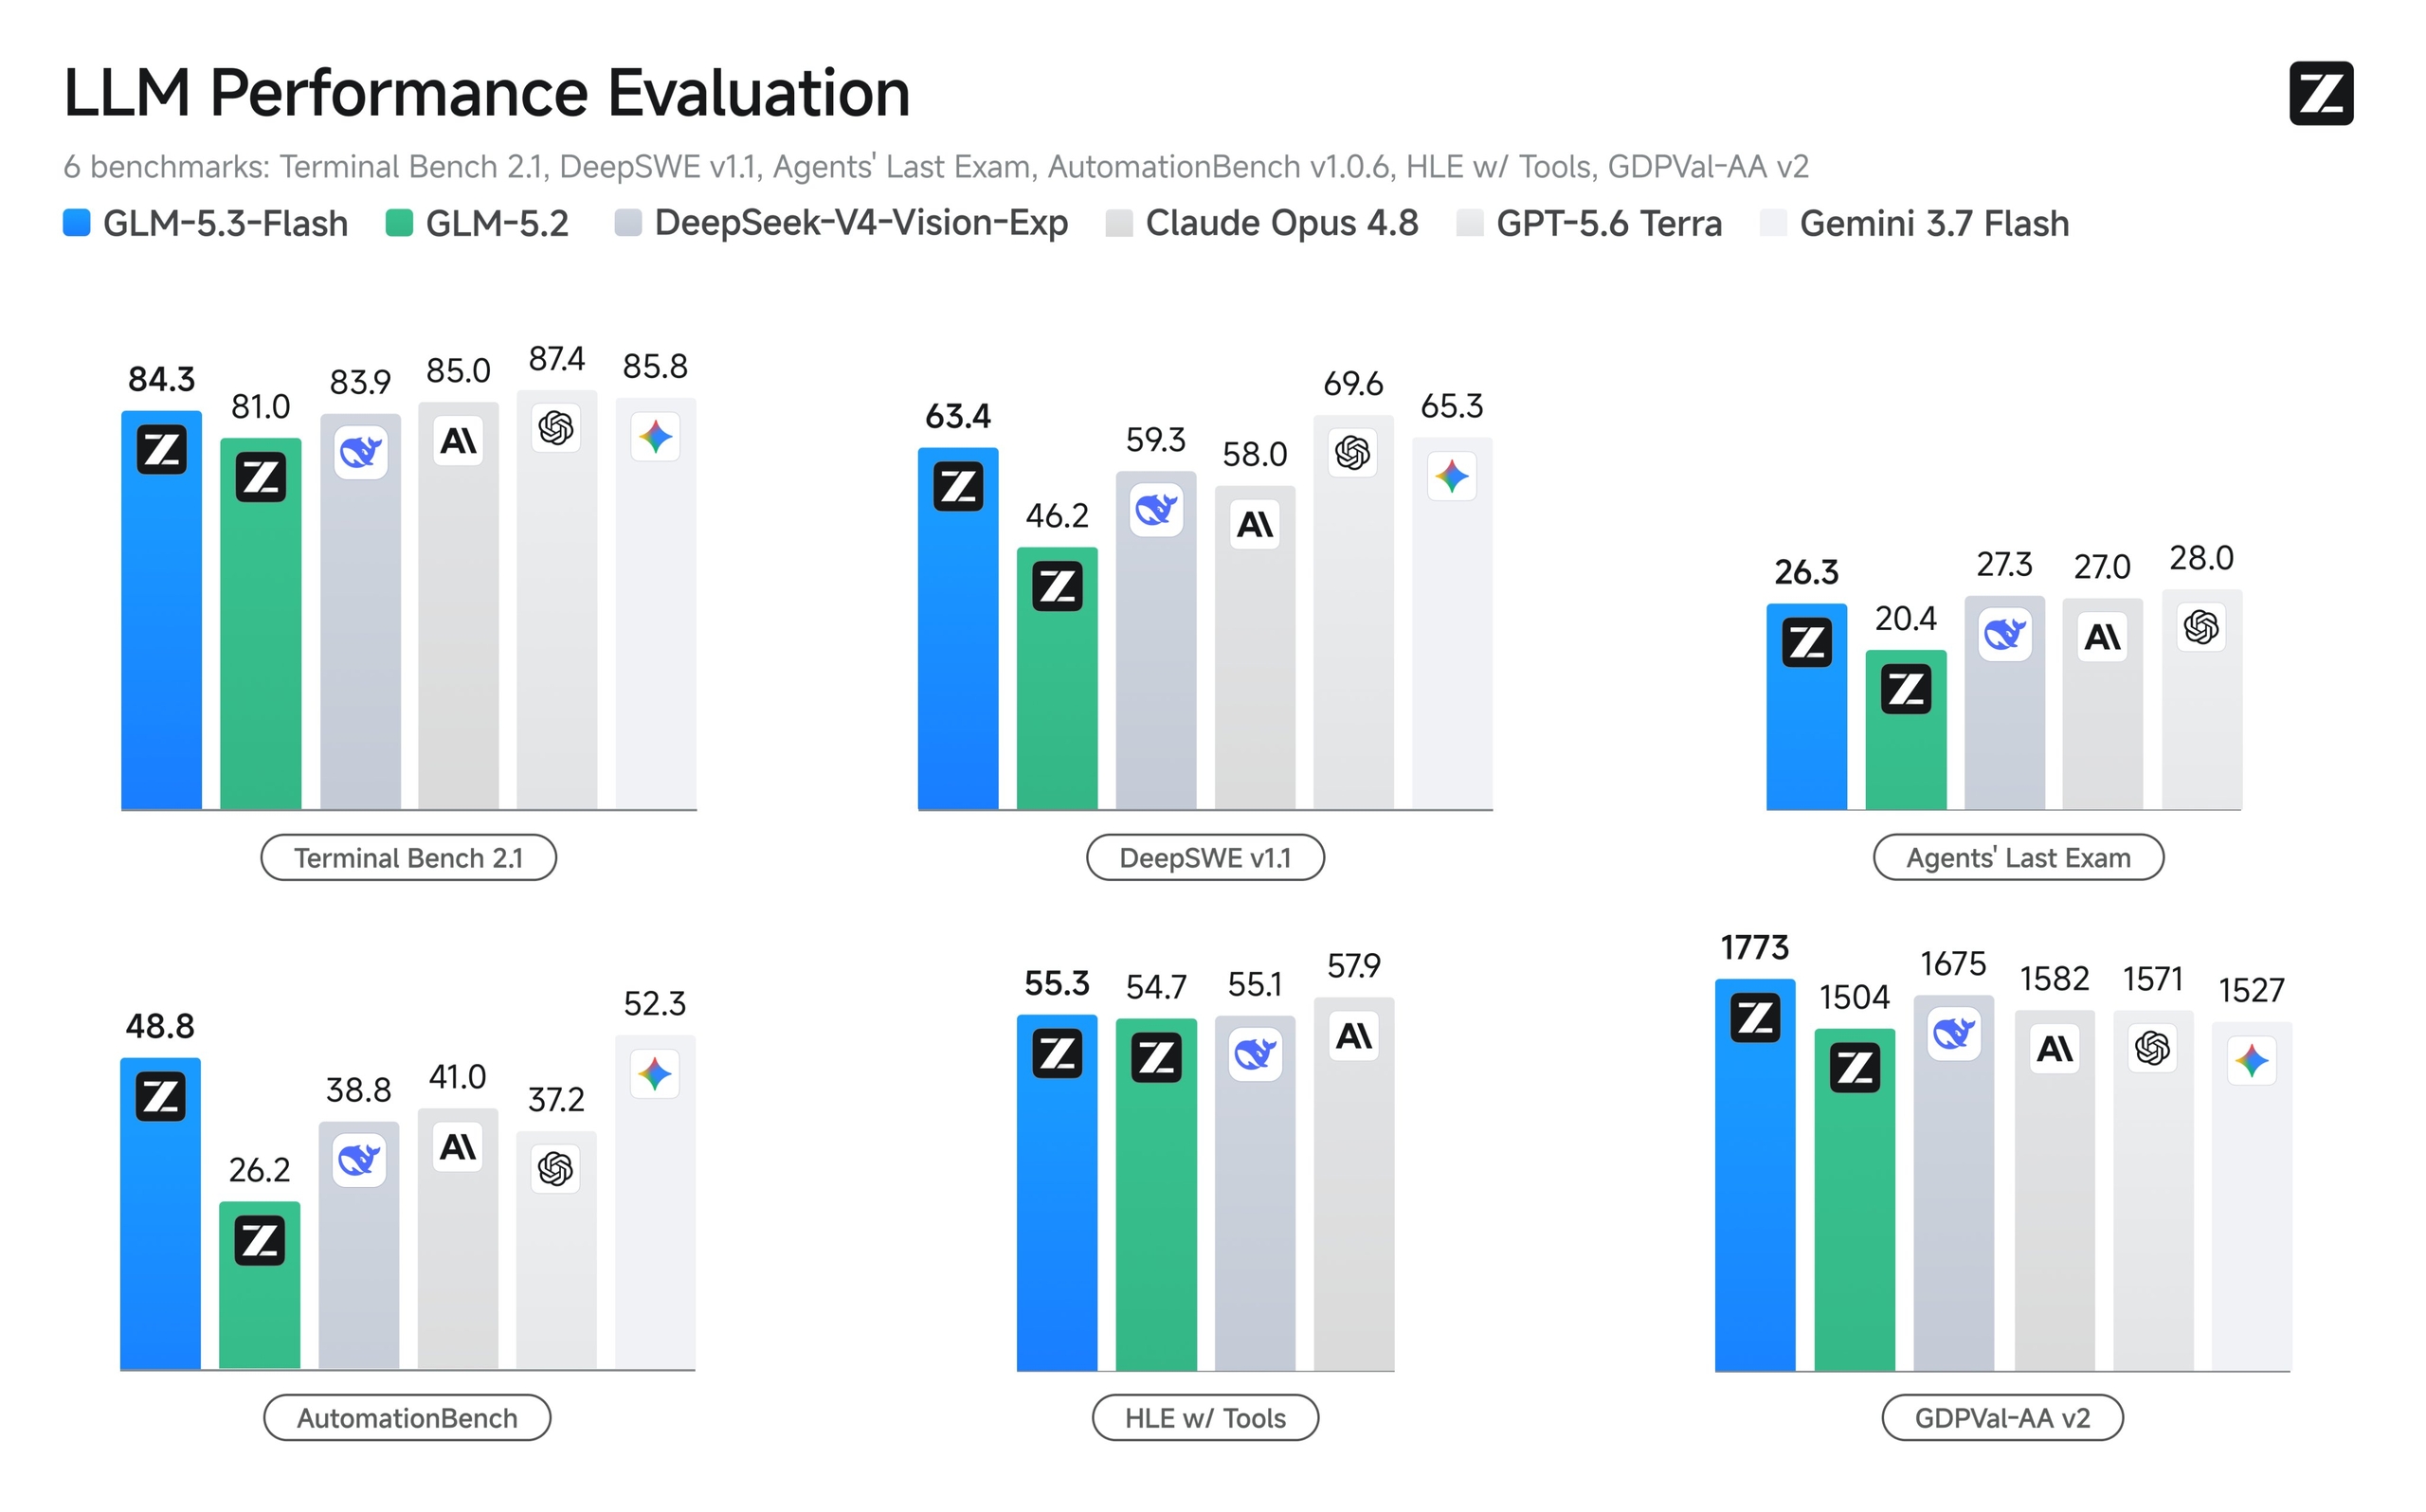
Стелс-модель Ox Alpha связывают с семейством GLM-5.3
Kingy AI отмечает, что название Flash официально никто не подтверждал, но техника сходится: стелс-модель Ox Alpha с OpenRouter выложена на Hugging Face как GLM-5.3-Flash, мультимодальная 320B-A18B под лицензией MIT.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.