
Локальная Qwen3.8-27B вышла с контекстом 262K
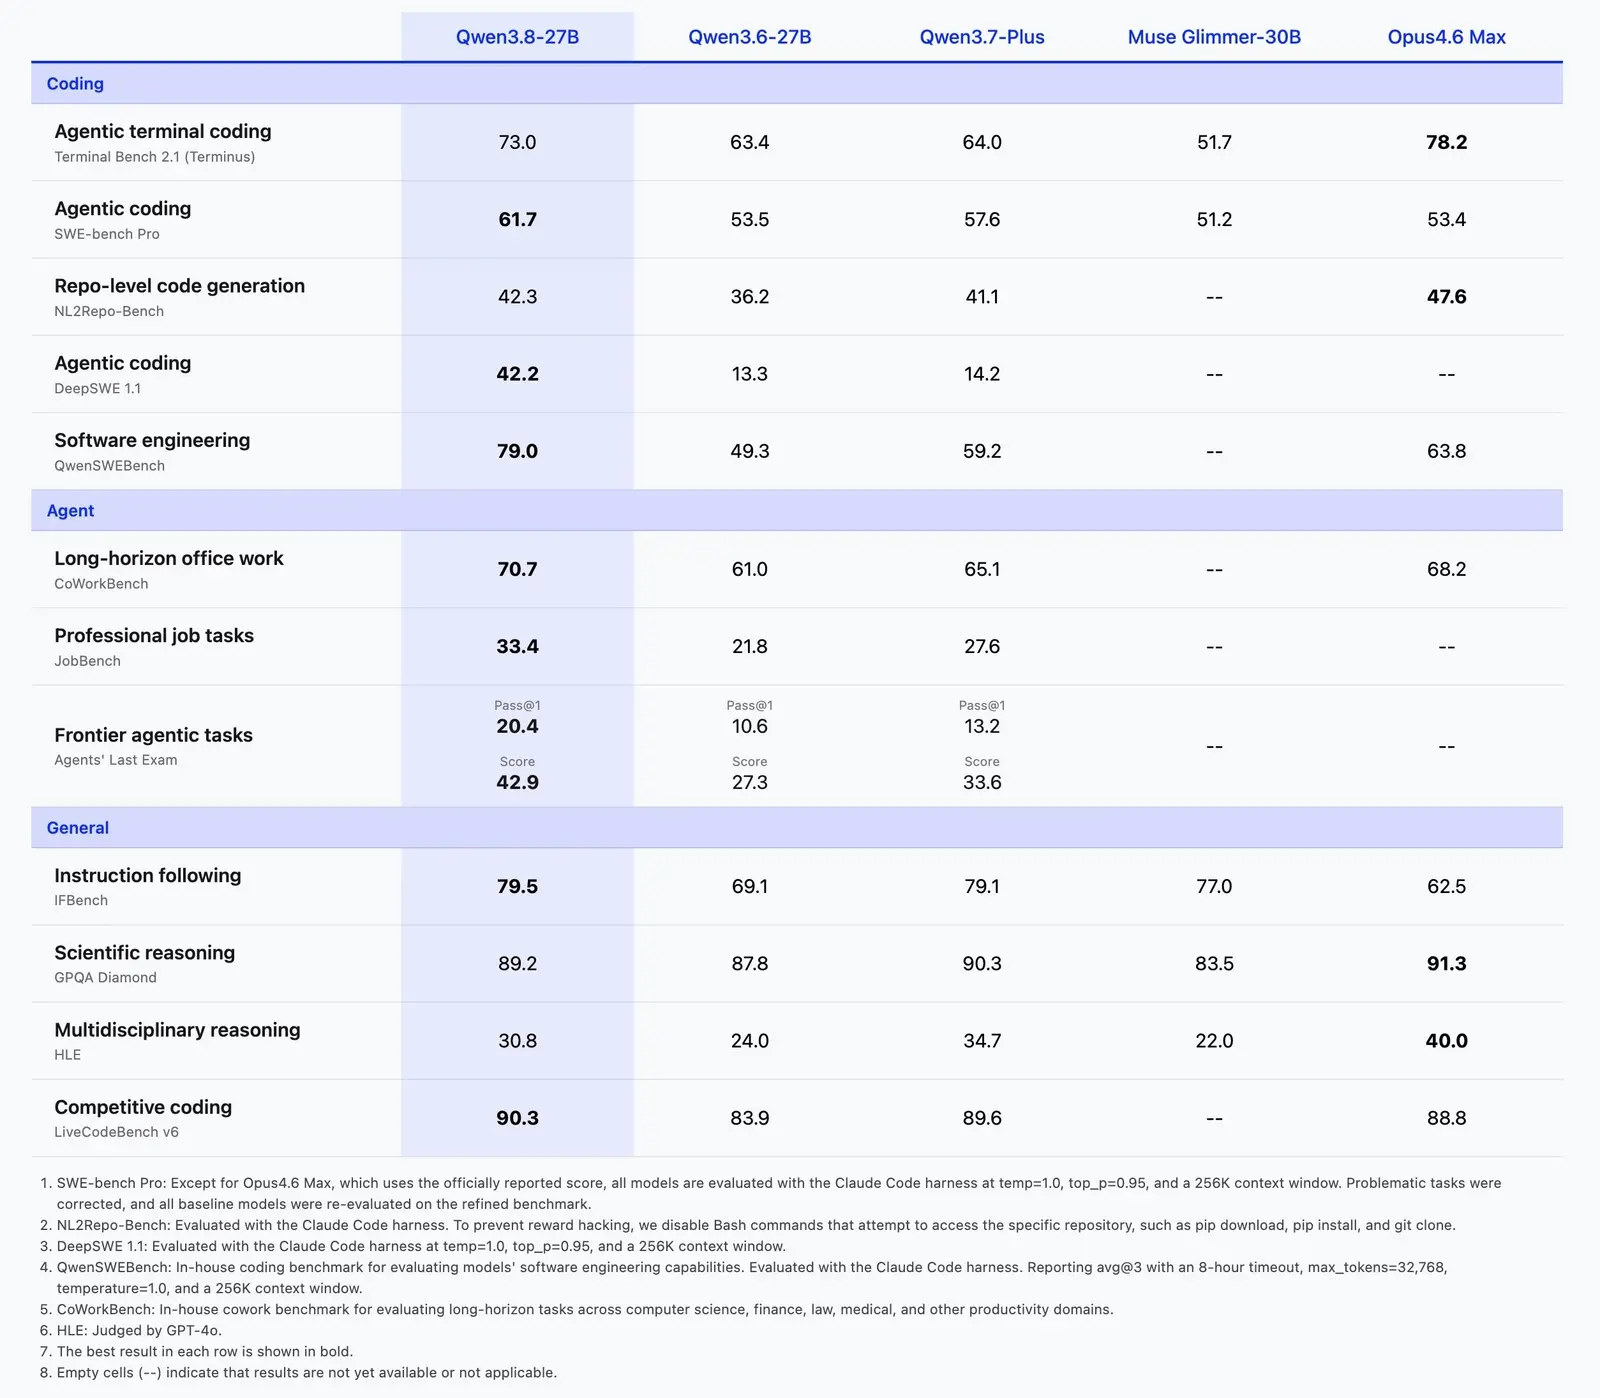
Alibaba 14 августа выложила на Hugging Face веса Qwen3.8-27B под лицензией Apache 2.0. Таблица в карточке модели показывает, насколько плотная 27B ушла вперёд от предыдущей открытой версии того же размера и где она стоит рядом с Opus 4.6.
Открыть веса компания обещала в начале августа, когда называла характеристики Qwen3.8-Max. Предыдущий открытый релиз этого размера, Qwen3.6-27B, вышел 22 апреля, тоже как плотная модель под Apache 2.0. Поколение 3.7 открытых весов не получило совсем: Qwen3.7-Max (20 мая) осталась проприетарной, а Qwen3.7-Plus (1 июня) работает только как хостинговая модель. Так что между двумя открытыми 27B прошло почти четыре месяца и одно пропущенное поколение.
Qwen3.8-27B нативно мультимодальна и рассчитана на локальный запуск. Окно контекста 262K токенов, через YaRN (способ растянуть позиционные кодировки на более длинные последовательности) его расширяют до 1 миллиона.
Сравнение с Opus 4.6 звучит в посте о релизе в Threads: там сказано, что при 27 млрд параметров модель идёт вровень с ним на бенчмарках. Цифры из карточки картину уточняют, против Opus4.6 Max результат расходится по тестам:
- Terminal Bench 2.1 (Terminus): 73,0 у Qwen3.8-27B, 63,4 у Qwen3.6-27B, 64,0 у Qwen3.7-Plus и 78,2 у Opus4.6 Max;
- SWE-bench Pro: 61,7 у Qwen3.8-27B, 53,5 у Qwen3.6-27B, 57,6 у Qwen3.7-Plus и 53,4 у Opus4.6 Max.
В терминальных задачах прирост к прошлой 27B составил 9,6 пункта, но до Opus4.6 Max остаётся 5,2. В SWE-bench Pro картина обратная: Qwen3.8-27B обходит Opus4.6 Max на 8,3 пункта. И в обоих тестах новая открытая модель выше хостинговой Qwen3.7-Plus. Все цифры приведены самой Alibaba.
Под капотом Qwen3.8-27B опирается на архитектуру Qwen3.5. 64 слоя собраны в 16 одинаковых блоков: три слоя Gated DeltaNet и один слой Gated Attention, за каждым идёт FFN. Gated DeltaNet - вариант линейного внимания, его стоимость растёт с длиной контекста линейно. Полное внимание стоит только в каждом четвёртом слое, на таком соотношении и держится длинное окно в модели такого размера. Кроме того, модель обучена на MTP (multi-token prediction), где сеть учится предсказывать сразу несколько следующих токенов, причём в несколько шагов.
Режим рассуждений включён по умолчанию и отключается в отдельном запросе. Глубину регулирует параметр reasoning_effort, а preserve_thinking сохраняет рассуждения из прошлых сообщений в контексте. Веса совместимы с Hugging Face Transformers, vLLM, SGLang и TokenSpeed.
Вместе с 27B Alibaba открыла и Qwen3.8-2.4T-A95B, версию класса Max: 2,4 трлн параметров, из них 95 млрд активных, 512 экспертов, из которых на токен включаются 11. Публикацию её весов датируют по-разному, 8 или 12 августа. У старшей модели другие условия: она только текстовая, всегда работает в режиме рассуждений и выходит под собственной лицензией Qwen3.8-Max License с условиями о разделе выручки. Чистый Apache 2.0 в линейке 3.8 достался 27B.
Хостинговая Qwen3.8-27B в Qwen Cloud, с контекстом 1M по умолчанию и встроенными официальными инструментами, в карточке пока помечена как «coming soon».
Дальше
Разработчики Cursor переходят к работе над Grok Build
Инженеры Cursor займутся Grok Build, Grok Bot и API Grok. Команда официально вошла в состав SpaceXAI, при этом разработку самого редактора Cursor в ней продолжат, условия сделки в анонсе не раскрыты.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.