
У LFM2.5 от Liquid AI из 24B параметров работают 2B
В LFM2.5-24B-A2B, которую Liquid AI выложила 13 октября, 24 миллиарда параметров, но на каждый токен считаются только 2,45 миллиарда. В карточке модели Liquid AI на Hugging Face сказано, что модель сделана под быстрых и приватных агентов, которые работают прямо на устройстве. Она последняя и самая крупная в семействе LFM2.5: младшая модель, LFM2.5-230M, меньше её на два порядка.
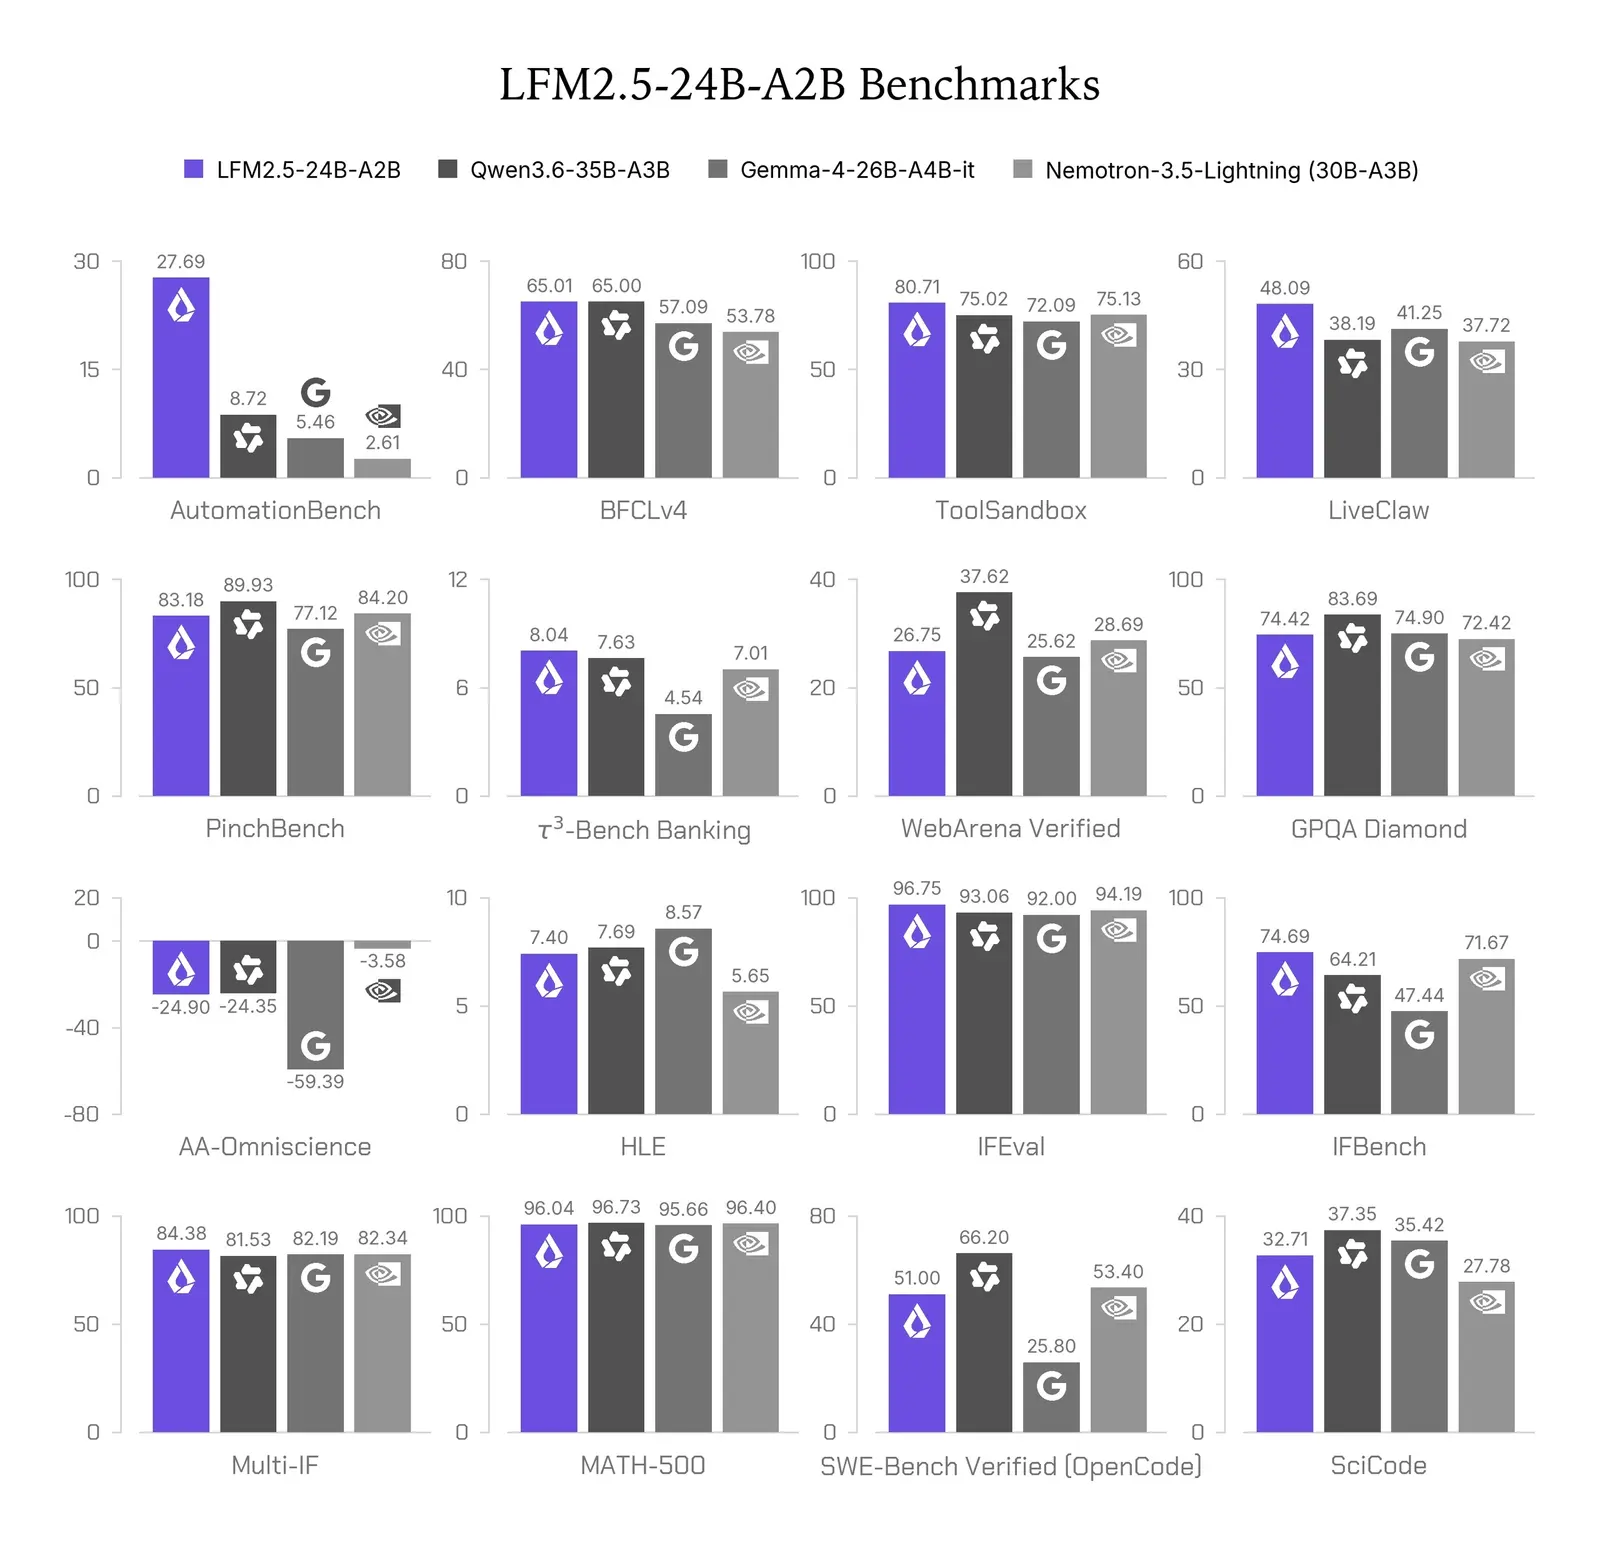
Главное заявление касается агентских задач. Liquid AI сравнивает модель с Qwen3.6-35B-A3B, у которой, по подсчёту компании, примерно на 50% больше и общих, и активных параметров. На LiveClaw счёт 48,09 против 38,19 в пользу LFM2.5. В полной таблице из 16 тестов видна и обратная сторона: в программировании и научных задачах впереди Qwen.
Три четверти слоёв без внимания
Из 40 слоёв модели только 10 используют внимание, причём в варианте GQA: несколько голов запросов делят общие ключи и значения, и KV-кэш от этого меньше. Остальные 30 слоёв построены на коротких свёртках с двойным гейтингом. Короткая свёртка смешивает токен только с ближайшими соседями, поэтому её стоимость не растёт с длиной контекста так, как у внимания. Дальние связи по тексту остаются на десяти слоях внимания. Ещё при запуске LFM2.5 в Liquid AI объясняли, что гибридная архитектура нужна ради быстрого инференса на CPU и небольшого расхода памяти.
Поверх этого стоит смесь экспертов (MoE): в каждом MoE-блоке 64 эксперта, и роутер отдаёт каждый токен четырём из них. Отсюда и разница между 24 и 2,45 миллиарда. Все эксперты загружены в память, но токен проходит лишь через выбранные.
Вторая особенность в том, что модель всегда рассуждает перед ответом. Шаблон чата сам вставляет тег <think> в начало каждого ответа ассистента. Предшественница LFM2-24B-A2B так не работала. В Liquid AI объясняют, что при двух с небольшим миллиардах активных параметров каждый токен рассуждения обходится дёшево.
Что изменилось с LFM2
Архитектура осталась от LFM2-24B-A2B, изменились две вещи. Контекстное окно выросло с 32K до 131K токенов, точнее до 131 072. Словарь увеличился с 65K до 128K токенов: токенизатор расширили на месте, без замены, чтобы лучше токенизировать нелатинские письменности. Модель только текстовая и поддерживает 16 языков, среди них русский.
Основная разница в объёме обучения. Предобучение заняло около 33 триллионов токенов против примерно 17 триллионов у LFM2. Затем шёл этап промежуточного обучения: 2 триллиона токенов отобранных данных при контексте 32K с упором на рассуждения, математику, код, следование инструкциям и многоязычные тексты, после них 300 миллиардов токенов длинных документов уже при 131K. Вызовы инструментов и многоходовые диалоги были в обеих фазах. Общий бюджет обучения в карточке указан как 36 триллионов токенов.
Постобучение состояло из нескольких ступеней. Сначала обычное дообучение с учителем и специализация моделей-учителей. Потом две стадии дистилляции on-policy, где ученик учится на собственных генерациях, а учитель их поправляет: одна стадия для общих задач, другая для агентских. В конце обучение с подкреплением прямо внутри популярных агентских обвязок: OpenClaw, Hermes Agent, Pi и OpenCode. В Liquid AI говорят, что так модель выучила их инструменты, системные промпты и манеру взаимодействия.
Шестнадцать тестов
Таблица охватывает знания, следование инструкциям, математику, код, вызов инструментов и агентские сценарии. Кроме Qwen3.6-35B-A3B, в сравнении участвуют Gemma-4-26B-A4B-it и Nemotron-3.5-Lightning (30B-A3B). Все модели прогоняли через vLLM.
Самый большой отрыв на AutomationBench: 27,69 у LFM2.5 против 8,72 у Qwen, 5,46 у Gemma и 2,61 у Nemotron, больше чем втрое выше ближайшего соперника. Тест шёл с температурой 0,6 и лимитом в 50 ходов. На ToolSandbox счёт 80,71 против 75,02 у Qwen, здесь пользователя изображал GPT-4o. На LiveClaw LFM2.5 обходит и Gemma с её 41,25, причём замер делали при температуре 1,0: агент свою не задаёт, и vLLM подставляет значение по умолчанию. На BFCLv4 модели сыграли вничью, 65,01 против 65,00. В τ³-Bench Banking, где роль клиента играл GPT-5.2, у всех низкие баллы: 8,04 у LFM2.5 и 7,63 у Qwen.
С инструкциями картина похожая. На IFBench у LFM2.5 74,69, у Qwen 64,21, у Gemma всего 47,44. На IFEval 96,75 против 93,06.
На коде отрыв уже в обратную сторону. SWE-Bench Verified в обвязке OpenCode даёт LFM2.5 51,00 против 66,20 у Qwen, и даже Nemotron с 53,40 оказывается выше. В WebArena Verified, где модель работает в браузере и может сделать до 40 действий, у LFM2.5 26,75 против 37,62 у Qwen. На PinchBench 83,18 против 89,93. На GPQA Diamond разница около девяти пунктов: 74,42 против 83,69. Уступает модель и на SciCode: 32,71 против 37,35.
HLE: 7,40 у LFM2.5, 7,69 у Qwen, 8,57 у Gemma. В AA-Omniscience у LFM2.5 -24,90, у Qwen -24,35, у Gemma -59,39, а лучший результат у Nemotron, -3,58. На MATH-500 все четыре модели набрали от 95,66 до 96,73.
Скорость и её условия
На устройствах LFM2.5-24B-A2B генерирует 184 токена в секунду на Apple M5 Max и 114 на AMD Ryzen AI Max+ 395. По словам Liquid AI, это до 1,7 раза быстрее следующей по скорости модели из сравнения, и памяти она занимает меньше всех. Замеры сделаны на Pipette, внутренней платформе компании для тестов на устройствах: llama.cpp, квантизация Q4_K_M, входной контекст 4K токенов. Быстрее остальных модель и при чтении промпта.
На сервере заявлено больше 21 тысячи выходных токенов в секунду на одной NVIDIA B300 при высокой конкурентности. Условия такие: SGLang 0.5.22, веса в BF16, 1024 входных токена, ответ до 256 токенов, и как только запрос завершается, на его место сразу ставят новый. Меряли общую пропускную способность: суммарный вывод, делённый на время, а не скорость одного ответа.
Как подключить к агенту
Вместе с основным чекпоинтом выложены базовая модель для дообучения, FP8-версия для серверов на vLLM и SGLang, GGUF для llama.cpp и запуска на CPU, ONNX и 4-битная сборка MLX для Mac. Черновая модель DSpark для спекулятивного декодирования в SGLang помечена как «скоро». У младшей LFM2.5-8B-A1B такой драфтер на 328M вышел сразу, и Liquid AI обещала с ним примерно в 2,5 раза более быстрое декодирование при тех же ответах.
Для Transformers нужна версия 5.0.0 или новее. Рекомендуемые параметры генерации: temperature 0,1, top_k 50, repetition_penalty 1,05. Вызовы функций модель по умолчанию пишет в стиле Python, списком между токенами <|tool_call_start|> и <|tool_call_end|>. Если нужен JSON, об этом просят в системном промпте. Результат инструмента возвращают сообщением с ролью tool, и модель отвечает на исходный вопрос обычным текстом.
Модель поднимают локально на любом бэкенде с OpenAI-совместимым API и указывают его адрес в обвязке; для Hermes, OpenClaw и Pi в карточке есть готовые конфиги. Дообучать компания советует под конкретную задачу и выкладывает рецепты на Unsloth и TRL, вплоть до DPO и GRPO.
Для задач, которые держатся на знаниях, Liquid AI модель в одиночку не рекомендует: её советуют связывать «с поиском по документам или в вебе, что играет на её сильную сторону в вызове инструментов».
Дальше
Жучок в переговорке OpenAI нашли с помощью моделей OpenAI
30 сентября в переговорной руководства OpenAI нашли записывающее устройство, завёрнутое в туалетную бумагу. Вычислить инженера, который его поставил, по словам компании, помогли модели самой OpenAI. У вас в офисе переговорные когда-нибудь проверяли на прослушку?
Читайте также
- Flint от Recursive обещает 125+ токенов/с на MacBook
- Nemotron 3.5 Super VL сильна в терминале, слабее в коде
- Немецкая Kolibri с окном в 1M токенов вышла под Apache 2.0
- Mistral выложила веса Large 4 на 1 трлн параметров
- Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
- Минорный апдейт DeepSeek обогнал Opus 5 на DeepSWE
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.