
Nemotron 3.5 Super VL сильна в терминале, слабее в коде
Nemotron 3.5 Super VL, которую NVIDIA выложила 15 октября, по размеру не изменилась: 120 миллиардов параметров, из них 12 миллиардов активных, и контекст до 1 млн токенов, как у мартовской Nemotron 3 Super. Зато теперь модель принимает на вход изображения, страницы документов и видео, а перед этим её языковую часть дообучили на триллионе токенов дистилляцией из Nemotron 3 Ultra.
Подробности обучения NVIDIA приводит в карточке базового чекпойнта на Hugging Face. Этот чекпойнт служит заготовкой для собственного дообучения и доменной адаптации. Рядом лежат две готовые версии после пост-тренинга: BF16 для кастомизации и NVFP4 для развёртывания.
Что изменилось по сравнению с Nemotron 3 Super
Nemotron 3 Super вышла на Hugging Face 11 марта и принимала только текст. В новой версии к той же гибридной архитектуре добавили визуальный энкодер C-RADIO и коннектор, который переводит картинку в представления, понятные языковой части. Отвечает модель по-прежнему только текстом.
- Входные данные: был только текст, стали текст, изображения RGB (jpeg, png) и видео в mp4 длиной до двух минут; документы подаются как изображения страниц с сопутствующим текстом.
- Лицензия: была NVIDIA Nemotron Open Model License, стала OpenMDW 1.1, которая разрешает коммерческое использование и модификацию.
Обучение шло в три этапа. Сначала на 100 миллиардах токенов обучили общую голову MTP (multi-token prediction, предсказание нескольких следующих токенов за проход), заморозив основную сеть, затем провели тот самый триллион токенов дистилляции из базовой Nemotron 3 Ultra. Второй этап: 100 миллиардов токенов на индийских языках, 35 миллиардов на расширение окна до 1 млн, 67 миллиардов токенов программной инженерии при контексте 256K и финальные 9 миллиардов на восстановление работы с длинным контекстом. В инженерные данные вошли репозитории, пары issue и pull request, диффы коммитов, логи сборок и CI, а также траектории агентов. Только третий этап добавил зрение.
Основной корпус, на котором держится модель, NVIDIA оценивает в более чем 20 триллионов токенов: английский, ещё 19 языков и 43 языка программирования.
Как устроена модель
Внутри чередуются слои Mamba-2, attention и смесь экспертов (MoE), и такое сочетание NVIDIA описывает как рассчитанное на длинный контекст. В каждом MoE-слое 512 маршрутизируемых экспертов. Окно общее для всего: промпта, изображений, истории диалога, результатов вызова инструментов и ответа. NVIDIA предупреждает, что конкретные рецепты развёртывания могут урезать контекст под доступную память GPU и число параллельных запросов.
Ускорение генерации описано в двух вариантах. В карточке модели общая голова MTP рекурсивно предсказывает будущие токены для нативного спекулятивного декодирования. The News Stack называет технику LiLiCorr: модель-помощник набрасывает несколько токенов вперёд, а Super VL проверяет их пачкой. На DGX Spark это даёт прирост скорости генерации до 2,3 раза по сравнению с декодированием без спекуляции, утверждают в NVIDIA. Из железа в карточке названы Blackwell и Hopper, из софта PyTorch, Megatron-LM и NeMo.
Что показывают бенчмарки
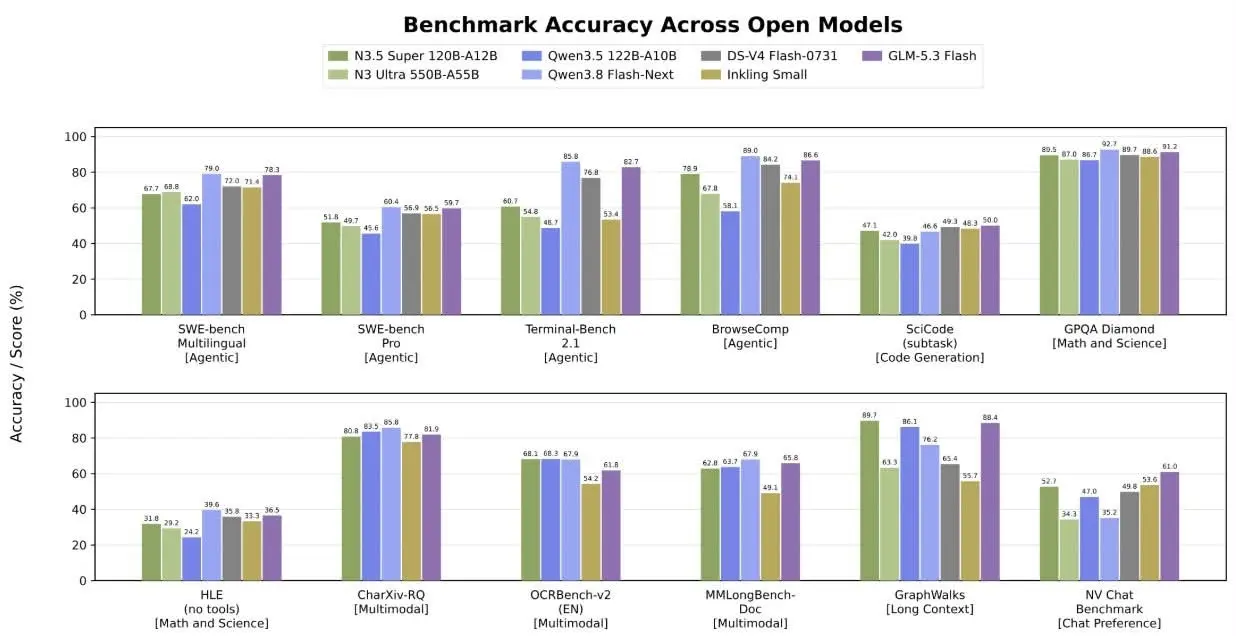
Кари Брискі, вице-президент NVIDIA по открытым моделям и софту, обещает «лидирующую точность в мультимодальных агентских задачах» и результат, «сопоставимый с самой большой reasoning-моделью NVIDIA при примерно одной пятой числа параметров».
Против Alibaba Qwen3.5-122B-A10B (122 миллиарда параметров, 10 миллиардов активных) картина неровная. Как сообщает The News Stack, в собственных тестах NVIDIA на пяти бенчмарках, GPQA-Diamond, Terminal-Bench 2.1, SWE-bench Verified, IFBench и MMLongBench-Doc, Super VL выигрывает на научных рассуждениях и терминальных задачах и чуть уступает на SWE-bench Verified и понимании документов. На Terminal-Bench 2.1 счёт 66,7 против 48,7, на SWE-bench Verified 71,1 против 71,9. Более новая Qwen3.8-Flash-Next обходит Super VL во всех пяти тестах, хотя с дополнительными эмбеддингами и блоками предсказания в ней около 180 миллиардов параметров. Inkling-Small от Thinking Machines (276 миллиардов параметров, 12 миллиардов активных) проигрывает на терминальных задачах и выигрывает в следовании инструкциям.
У собственной Ultra новая модель, по заявлению NVIDIA, выигрывает на Hermes Bench (63,44% против 56,33%) и в поведенческих оценках LangChain (87,05% против 84,3%). На CharXiv, бенчмарке рассуждений по графикам, Super VL набирает 80,8% против 63% у Nano Omni, а с интерпретацией кода на Python доходит до 84%. Упор в документах компания делает на распознавание текста, таблицы, графики и структурированную информацию.
Главный козырь при этом скорость: 10 000 задач SWE-bench Pro на четырёх B200 модель закрывает вчетверо быстрее. Только на том же графике NVIDIA её точность ниже, чем у Qwen3.8-Flash-Next и DeepSeek V4 Flash.
В карточке базового чекпойнта свои цифры, и они относятся к текстовой основе до обучения зрению: MMLU 84,14, MMLU-Pro 76,25, GPQA Diamond в режиме 5-shot 66,16, LiveCodeBench 47,61, Global MMLU в среднем по восьми языкам 86,56.
Bolt: 74B в 24 ГБ
Вместе с Super VL NVIDIA показала две небольшие модели для локального запуска. Младшая, Nemotron 3.5 Bolt E4B 4GB, выйдет позже в октябре: её нацеливают на разговорных и физических агентов на GeForce RTX, Jetson и Spark, вроде ассистентов в устройствах и интерактивных персонажей, которым нужны многошаговые вызовы инструментов и понимание состояния приложения.
Старшая, Nemotron 3.5 Bolt 74B-A9B 24GB, выведена из Super VL: из 74 миллиардов параметров на токен работают 9 миллиардов, а двухбитная квантизация экспертов в смешанной точности ужимает её до 24 ГБ. На Terminal-Bench 2.1 Bolt набирает 51,0 против 44,4 у Qwen3.6-35B-A3B и 37,2 у Gemma4 26B-A4B, причём конкурентов NVIDIA тестировала в BF16. Модель оптимизируют под RTX Spark и DGX Spark, поддерживаются llama.cpp, Ollama, LM Studio и vLLM. Bolt 74B, как и Super VL, уже лежит на Hugging Face.
Дальше
AI-индустрияРелизы моделейразбор
Krea 3 правит картинку за 8 секунд и 6 центов, Видео
В сравнении от Krea у Nano Banana Pro стоит медианное время правки с учётом очереди, 26,8 секунды, а у Krea 3 «иллюстративные» 8 секунд. Сама Krea оговаривает, что ролики сгенерированы заранее и живым бенчмарком не являются. Скорость генерации картинок вы проверяете сами или верите цифрам из анонса?
Читайте также
- NVIDIA научила модель расшифровки речи слушаться промптов
- У LFM2.5 от Liquid AI из 24B параметров работают 2B
- Немецкая Kolibri с окном в 1M токенов вышла под Apache 2.0
- Веса Kimi K3.1 Pro открыты: 104 млрд активных параметров из 2,8 трлн
- Hy4 от Tencent получил зрение по цене превью, веса позже
- Открытой FLUX 3 Image Klein в пике нужно 31 ГБ видеопамяти
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.