
Mistral выпустила Voxtral 3 и SDK для голосовых агентов
20 октября Mistral представила Voxtral 3, новое поколение своих речевых моделей и SDK для голосовых агентов. Модели распознавания теперь работают с 50 языками, у предыдущего поколения их было 13.
В анонсе Mistral перечислены модели пакетной расшифровки Voxtral Small Transcribe 3 и Voxtral Mini Transcribe 3, потоковая Voxtral Realtime Transcribe 3 и модель синтеза Voxtral Mini TTS 3. К ним прилагается SDK, который собирает распознавание, рассуждение, вызов инструментов и ответ голосом в один потоковый конвейер. Всё доступно через API Mistral с хостингом в ЕС, а также для развёртывания на собственной инфраструктуре.
Что изменилось в распознавании
В посте о Voxtral Transcribe 2 Mistral описывала Voxtral Mini Transcribe V2 так: разметка говорящих, подсказки терминов и пословные таймкоды на 13 языках. Список в третьем поколении вырос до 50 языков. В него вошли все 24 официальных языка ЕС, а также много азиатских и индийских языков, для которых мало обучающих данных. Младшую модель можно сравнить с предшественницей напрямую:
- языки: 13 → 50;
- цена: 0,003 → 0,0035 доллара за минуту;
- ошибка разметки говорящих (cpWER) на наборе тестов Mistral: 30,9% у Voxtral Mini Transcribe 2 → 18,6% у Voxtral Mini Transcribe 3.
Час аудио на Mini теперь обходится в 0,21 доллара против 0,18 у прошлого поколения. Mini Transcribe 3 весит 4 млрд параметров. Размер Small Mistral не назвала.
Обе модели поддерживают context biasing: вместе с аудио модели передают ключевые термины или свободный текст, и в расшифровке такие слова распознаются чаще. В Transcribe 2 подсказка принимала до 100 слов или фраз. По словам Mistral, такой механизм даёт работать со словарём конкретной области в продакшене без дообучения.
Бенчмарки и их условия
Главный график по точности Mistral построила на FLEURS: средний WER (долю ошибочных слов) по 45 языкам, которые поддерживают все семь сравниваемых моделей. Для японского, корейского, тайского и китайского вместо слов считались ошибочные символы. У Voxtral Small Transcribe 3 4,1%, когда язык задан заранее, и 4,0%, когда модель определяет его сама. У Microsoft AI Transcribe 2 на этом графике ровно те же 4,1% и 4,0%. Mini Transcribe 3 набрала 4,6% и 4,5%, Whisper large-v3 16,0% и 14,9%. С Whisper у Voxtral давняя связь: первые Voxtral Mini и Small вышли 15 июля 2025 года, и, по техническому отчёту Mistral, их аудиоэнкодер был построен на Whisper large-v3.
Разметку говорящих Mistral проверяла по метрике cpWER. Это тот же WER, только слово, приписанное не тому человеку, тоже засчитывается как ошибка. Тестовые наборы: AMI-IHM, AMI-SDM, Switchboard, Switchboard CallHome и AISHELL-4, причём AMI и AISHELL взяты в 30-минутных версиях, чтобы их смогли обработать API конкурентов. Результаты такие:
- Voxtral Small Transcribe 3: 18,4%;
- Voxtral Mini Transcribe 3: 18,6%;
- Pyannote Orchestrator (Precision 3): 19,0%;
- Microsoft AI Transcribe 2: 20,3%;
- Scribe v2: 23,0%;
- Gemini 3.5 Transcribe: 38,4%.
Подсказки терминов Mistral оценивала по полноте ключевых фраз на Earnings-22, где записаны звонки по квартальной отчётности. К настоящим терминам в подсказку добавлялись случайные «отвлекающие» слова, от 0 до 100. Без подсказки Voxtral Small Transcribe 3 находит 81,4% фраз, с подсказкой 94,6%. У Scribe v2 84,0% и 94,3%, у Gemini 3.5 Transcribe 80,9% и 87,3%. Получается, что без подсказки Scribe v2 на этом тесте впереди, а с подсказкой модели идут почти вровень.
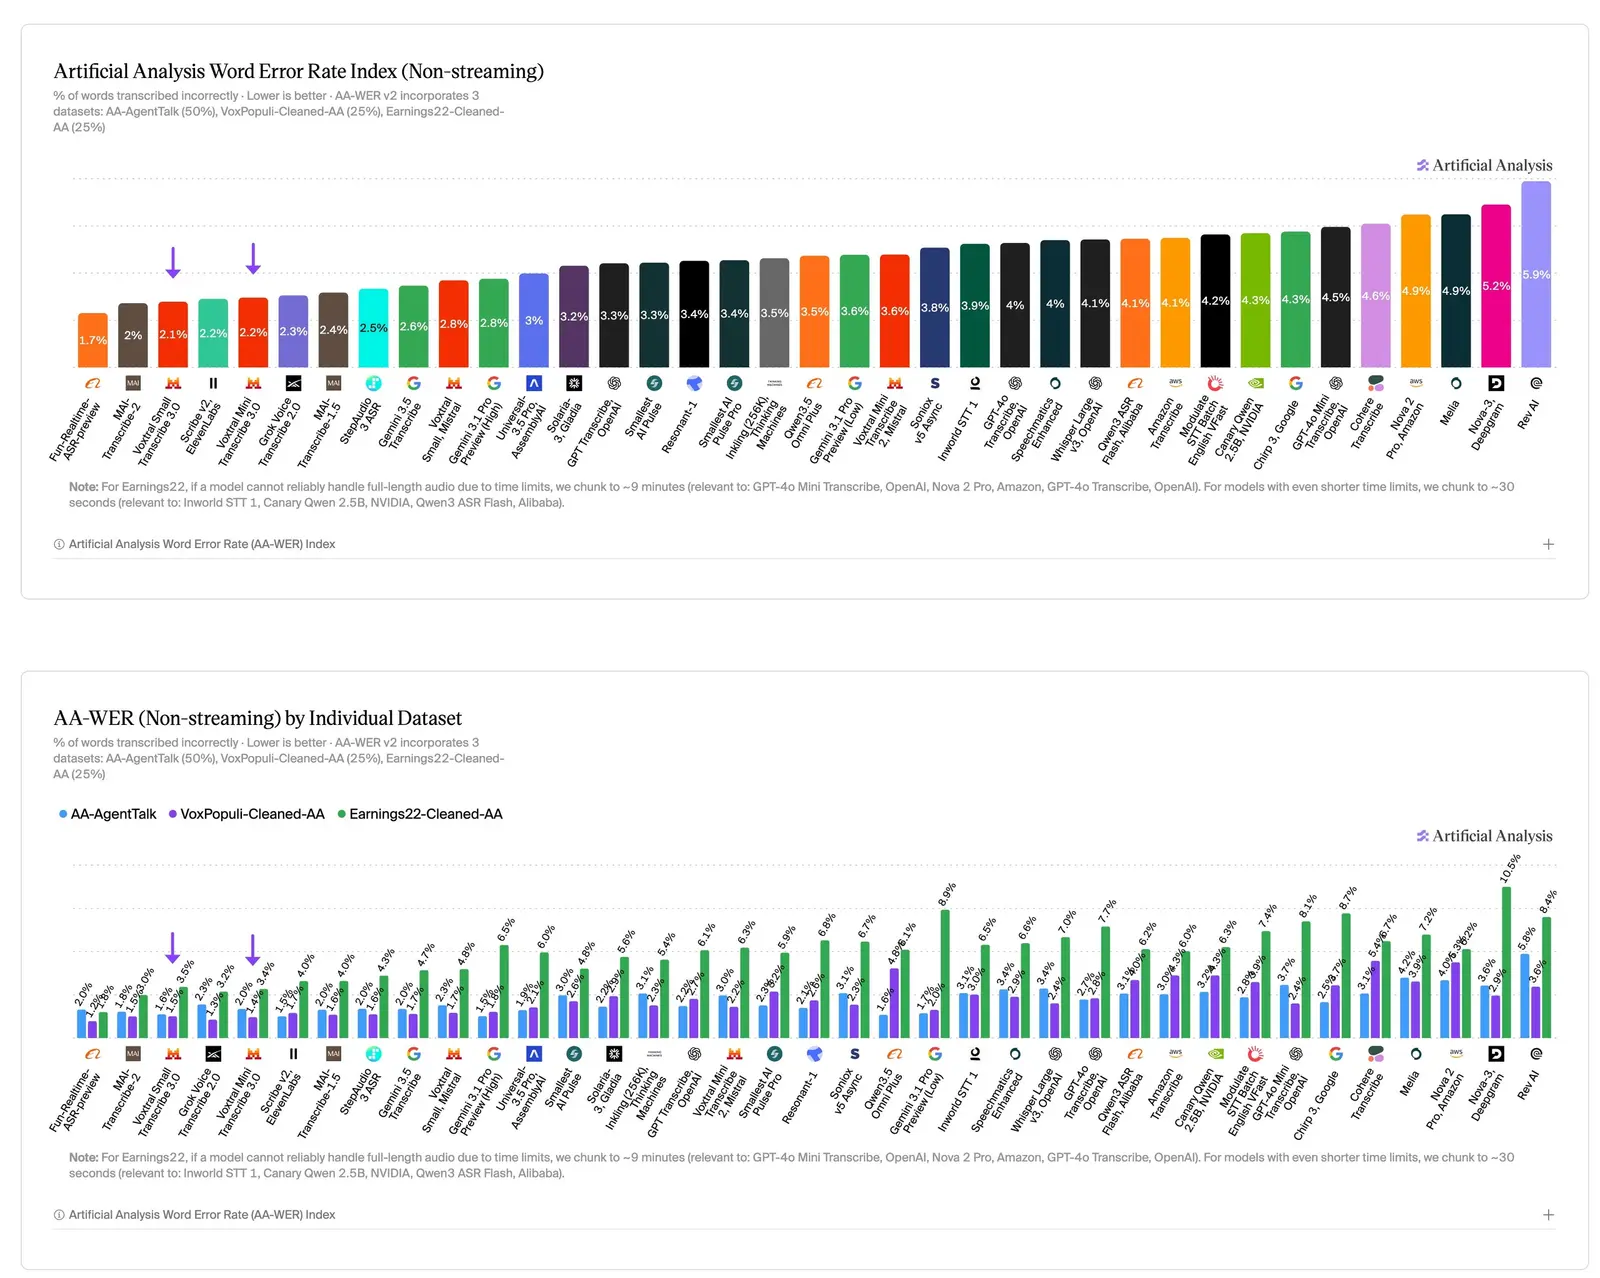
Есть и внешний замер. В сводном рейтинге Artificial Analysis, который взвешенно усредняет WER на VoxPopuli, Earnings-22 и AgentTalk, Voxtral Small Transcribe 3 стоит третьей, после Fun-Realtime-ASR-preview и Microsoft AI Transcribe 2. Mini Transcribe 3 на пятом месте, сразу за Scribe v2.
Потоковая расшифровка и конец реплики
Voxtral Realtime Transcribe 3 Mistral называет моделью для агентных сценариев: задержка меньше 500 мс, больше 35 языков, разметка говорящих и подсказки терминов. На графиках она подписана как Voxtral Mini Realtime 3. Задержку можно настраивать, и на FLEURS по 35 языкам точность меняется вместе с ней:
- 240 мс: 7,4%;
- 480 мс: 6,4%;
- 960 мс: 6,0%;
- 2400 мс: 5,7%.
Для сравнения на том же графике даны офлайн-модель Voxtral Mini Transcribe 3 с 4,0% как ориентир и чужие потоковые модели: Gemini 3.5 Realtime Transcribe с 4,2%, потоковая версия Microsoft AI Transcribe 2 с 5,8%, GPT Live Transcribe с 8,4% и Scribe v2 Realtime с 8,7%. Предыдущую Voxtral Realtime Mistral выпускала с открытыми весами под Apache 2.0 и задержкой, которую можно было снизить до значений меньше 200 мс. Тогда компания обещала, что при 480 мс ошибка будет отличаться от пакетной модели на 1-2%.
Конец реплики модель определяет сама, учитывая и звук, и смысл сказанного. Mistral объясняет, что так агент отвечает без паузы и реже перебивает человека, который ещё не договорил.
Синтез: эмоция из текста и подсказка фонем
Voxtral Mini TTS 3.0 работает в пакетном и потоковом режимах, поддерживает больше 35 языков и больше 50 диалектов. Миллион символов стоит 13 долларов, и, по расчёту Mistral, это дешевле OpenAI TTS-1, Deepgram, ElevenLabs Flash и Gemini Flash. В первую дюжину рейтинга модель синтеза попала, как отмечает Testing Catalog.
Эмоцию, темп и ударения модель выбирает по смыслу самого текста, без отдельных инструкций и голосовых образцов. Если нужно управлять этим явно, есть инструкции с тремя параметрами: эмоция, темп и акцент. Добавились контекстный синтез и библиотека словаря, через которую задаётся произношение. В демо Mistral фраза «Let's end the debate here: it's GIF.» озвучена дважды: по умолчанию и с подсказкой нестандартных фонем «dʒ ɪ f».
Для профессиональных задач, где обычного клонирования голоса мало, есть Pro Voice. По 30 минутам записи он воспроизводит характер голоса конкретного человека, его эмоциональный диапазон и манеру речи, причём на разных языках.
Синтез Mistral сравнивает с конкурентами на графиках «качество за доллар». Цены взяты со страниц вендоров, судьёй везде выступает gemini-3.8-flash:
- Voice Code Bench от BeSimple AI: 300 английских промптов про типичные сбои в клиентской поддержке на числах и редких именах, по два голоса (женский и мужской) на систему;
- произношение, внутренний тест: 300 английских предложений с одним редким или выдуманным словом (150 простых, 150 сложных), судья слушает запись вместе с транскрипцией слова в IPA;
- мультиязычность, внутренний тест: 377 промптов на 11 языках, один носитель-голос на язык, оценка по шкале от 1 до 5.
Системы без документированного управления произношением и те, что покрывают меньше 11 языков, на соответствующие графики не нанесены и остались только в данных.
SDK и где это работает
По описанию Mistral, надёжный голосовой агент должен одновременно слышать речь на разных языках и с акцентами, понимать, что человек имеет в виду, говорить естественно и выполнять многошаговые действия во внешних системах. SDK сводит эти этапы в один поток реального времени. Агент на нём может прямо во время звонка по телефону или в вебе найти нужную информацию, обратиться к бизнес-системам и довести задачу до конца. В целевых сценариях Mistral называет контакт-центры, службы поддержки, виртуальных ассистентов и голосовых помощников, которыми пользуются без рук.
Работать с Voxtral 3 можно через API на серверах Mistral в ЕС или на собственной инфраструктуре. Во втором случае компания сама решает, где обрабатывается звук и как обращаться с данными, а также хранятся ли записи разговоров вообще.
Дальше
AI-индустрияОбновления продуктов
Perplexity Computer на Mac научился работать без облака, Видео
36 ГБ единой памяти Perplexity рекомендует для локального режима Computer на Mac, где и модель, и агент работают на самом устройстве. Зато локальные задачи не тратят кредиты Computer. Сколько единой памяти у вашего Mac?
Читайте также
- ElevenLabs выпустила голосовые модели под API OpenAI
- Large 4 от Mistral: API сегодня, веса в конце октября
- Модель Canva Craft стала четвёртой на DesignArena
- MAI-Transcribe-2 получил потоковую версию для голосовых агентов
- Gemini Decisions API берёт до 1 000 вопросов за вызов
- Fable 5.2 в AI Gateway требует хранить запросы 30 дней
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.