
Qwen4-Max набрала 43 балла и обошла Qwen3.8 Max на 9
Qwen4-Max от Alibaba в режиме рассуждений xhigh набрала 43 балла в Intelligence Index от Artificial Analysis. Полная версия модели появилась на QwenCloud 16 ноября. По сравнению с Qwen3.8 Max в той же настройке это плюс 9 баллов, а прогон индекса, по нашему подсчёту по данным AA, обошёлся на 62% дешевле. Kimi K3.1 Pro (46 баллов) и Muse Wonder при этом стоят выше, но обе замерены в режиме max, а у Qwen4-Max в таблице AA есть только xhigh.
Без округления у Qwen4-Max 42,89 балла, у Muse Wonder (Max) 43,57, у Kimi K3.1 Pro (max) 46,45, у Qwen3.8 Max (снимок 0902, xhigh) 33,65. Отдельная Muse Wonder Full (Max) набрала 50,08. До первых строчек далеко: среди 29 моделей, которые AA выводит на странице Qwen4-Max, выше всех Claude Fable 5.2 (max) с 64,56, за ней Gemini 4 Carbon (high) с 60,03 и Claude Opus 5.5 (max) с 59,11.
Превью Qwen4-Max вышло 11 ноября без опубликованных бенчмарков. Теперь цифры есть и у Alibaba, и у AA.
Что поменялось против Qwen3.8 Max
Размер прежний: 2,4 триллиона параметров, из которых на каждый токен работает только часть. У Qwen4-Max это 71 миллиард, на 25% меньше, чем у предшественницы, говорится в пресс-релизе Alibaba. Переделаны три узла архитектуры: внимание, связи между слоями и эмбеддинги. На собственном тесте Work360 модель набрала 52,69 балла против 47,74 у Qwen3.8-Max, токенов тратит примерно на 24% меньше на уровне Xhigh и на 35% меньше на High, а средняя стоимость задачи, по расчёту Alibaba, упала на 62% (в том же пресс-релизе сказано «около 60%»).
Цена в API - 1,50 доллара за миллион входных токенов и 4,50 за миллион выходных, кэшированный ввод стоит 0,075 доллара. У Qwen3.8 Max было 2 и 6 долларов. Alibaba говорит об окне контекста в 1M токенов, в карточке AA указано 983 616. Модель сразу понимает изображения.
Qwen4-Max работает только в облаке Alibaba: через API QwenCloud, Token Plan, Qwen Studio, QwenWork и Qoder. Скачать веса и запустить её на своих серверах нельзя, меньшие модели Qwen4 с открытыми весами Alibaba обещает выпустить скоро. Kimi K3.1 Pro, которая обходит Qwen4-Max на 3,6 балла, выложена с открытыми весами: 2,8 триллиона параметров, 104 миллиарда активных.
Где Qwen4-Max уступает
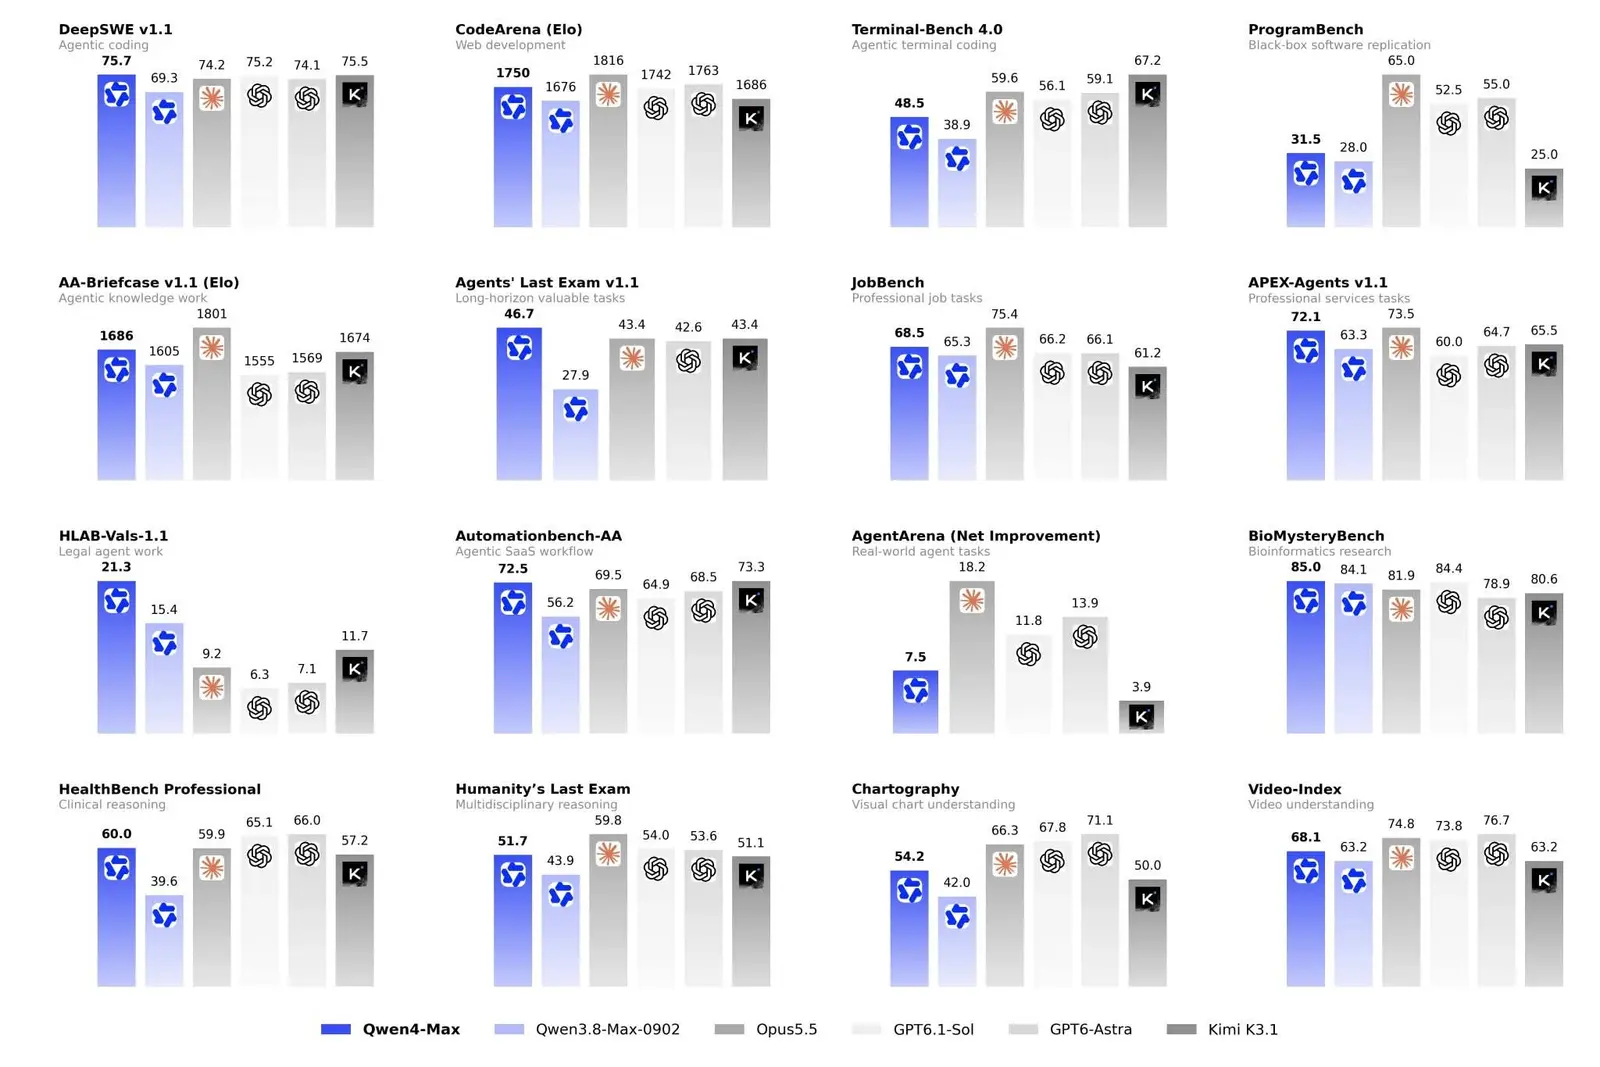
Во всех девяти тестах индекса новая модель обошла Qwen3.8 Max (0902), сильнее всего на HLE-Diamond (0,449 против 0,240) и AA-Omniscience (27,7 против 10,5). Kimi K3.1 Pro она проигрывает на Terminal-Bench 4.0 (0,485 против 0,672), Terminal-Bench-Science (0,233 против 0,343), CritPt и GDP.pdf. На HLE-Diamond впереди Qwen: 0,449 против 0,373. На AA-Briefcase погрешности двух моделей перекрываются, и кто там выше, сказать нельзя.
Как подсчитал MarkTechPost, в сравнительной таблице самой Alibaba из 16 тестов Qwen4-Max первая в четырёх, а Claude Opus 5.5 в семи. Слабые места - код и зрение: 31,5 на ProgramBench против 65,0 у Opus 5.5 и 54,2 на Chartography против 71,1 у GPT-6 Astra. Столбец Terminal-Bench 4.0 в той таблице (48,5 у Qwen4-Max, 67,2 у Kimi K3.1) до десятых совпадает с замерами AA для всех пяти моделей, так что, по нашему выводу из этого совпадения, Alibaba взяла эти цифры у AA, а не мерила сама.
На рейтингах по живым задачам Alibaba называет шестое место в Code Arena. TestingCatalog в Threads сообщает о 14-м месте в общем зачёте Agent Arena и чистом приросте на 7,5% по 14,7 тысячи реальных агентных сессий. В сноске блога Qwen сказано, что оценки Arena взяты с самой арены.
Авторский разбор
Что мы проверили
16 ноября мы сняли с AA данные прогона индекса для Qwen4 Max и Qwen3.8 Max (0902), обе в режиме xhigh, и пересчитали стоимость и расход токенов.
Счёт AA за прогон упал на те же 62%, что Alibaba насчитала на своём Work360, хотя набор задач совсем другой. Большую часть экономии дали новые цены, прежде всего на кэшированный ввод. Меньший расход токенов дал меньшую часть.
| Прогон индекса AA, xhigh | Qwen3.8 Max (0902) | Qwen4 Max | Изменение |
|---|---|---|---|
| Счёт, долларов | 6 353,83 | 2 394,31 | -62,3% |
| Средняя стоимость задачи, долларов | 10,02 | 3,27 | -67,4% |
| Выходные токены, млн | 150,5 | 127,1 | -15,5% |
- По старым ценам Qwen3.8 Max тот же объём токенов Qwen4 Max стоил бы 4 563,96 доллара, на 28,2% меньше, чем у предшественницы. Остальное дали новые цены: кэшированный ввод подешевел с 0,25 до 0,075 доллара за миллион токенов, а около 92% входных токенов в прогоне AA читались из кэша. Разбивку мы вывели сами из составляющих счёта AA, сама AA её не публикует.
- AA всё равно называет Qwen4 Max «очень многословной»: 127 миллионов выходных токенов при медиане 78,6 миллиона.
- Прирост на AA-Omniscience дала точность ответов, она выросла с 0,295 до 0,437. Доля выдуманных ответов при этом не снизилась: 0,284 против 0,271 у Qwen3.8 Max.
Дальше
Astra помогла физику с вопросом, открытым полвека
GPT-6 Astra взяла на себя детальное доказательство в вопросе, открытом больше 25 лет, о том, как задать фазу для Стандартной модели на решётке. Автор препринта называет итог кандидатом, который ещё должны проверить эксперты. У вас бывало, что модель вела вывод или расчёт целиком, а вы только проверяли?
Читайте также
- Qwen4-Max вышел в превью без опубликованных бенчмарков
- Модель Microsoft догнала GPT-6 Astra за 2% цены
- Microsoft обещает в MAI Code 2 почти Opus за 5% цены
- Meituan сравнивает LongCat-2.5 с Opus 5 и GPT-5.6-Sol
- Mistral выложила веса Large 4 на 1 трлн параметров
- Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.