
Meituan сравнивает LongCat-2.5 с Opus 5 и GPT-5.6-Sol
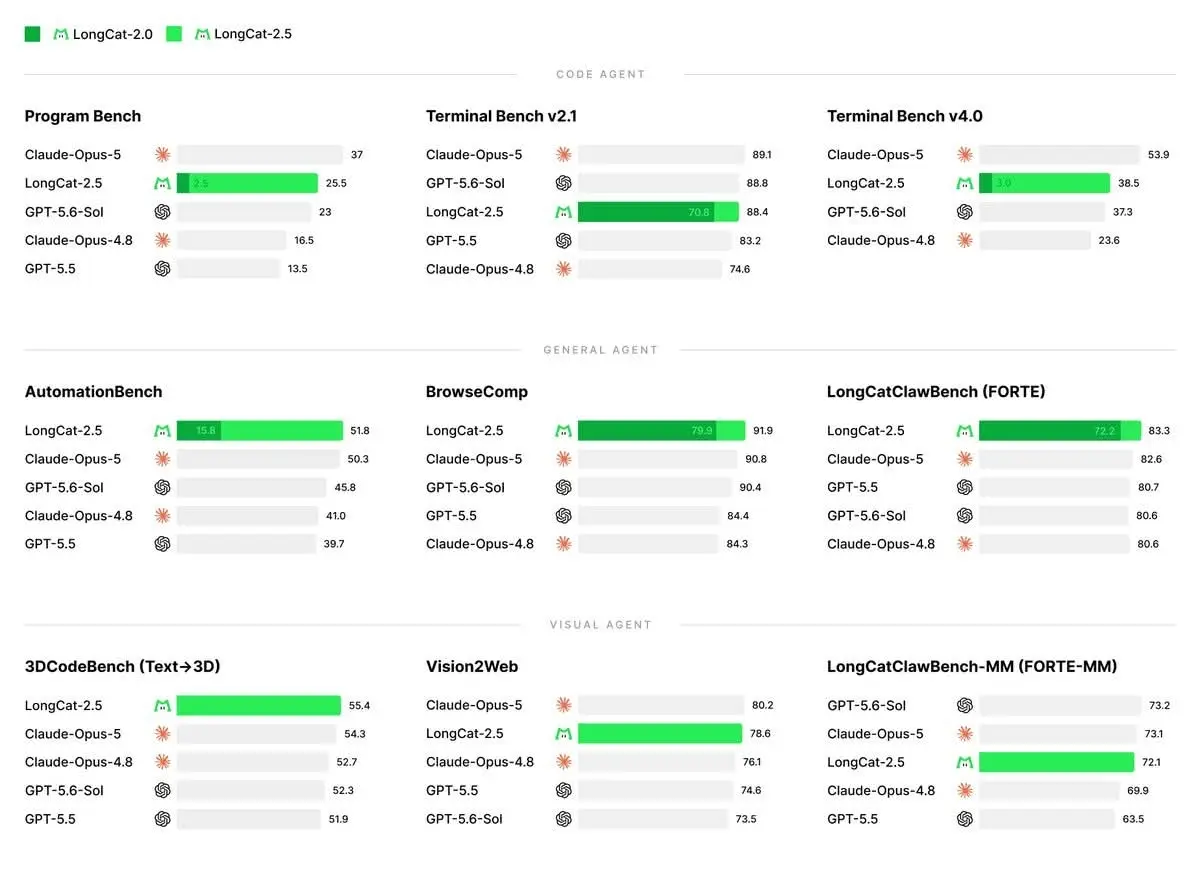
LongCat-2.5, новая мультимодальная модель Meituan на 1,6 триллиона параметров, с 2 ноября доступна через API, и в анонсе Meituan она стоит в одном ряду с GPT-5.5, GPT-5.6-Sol, Claude-Opus-4.8 и Claude-Opus-5. Если вы подбираете модель под длинные агентные задачи и код, учтите: это сравнение провела сама Meituan.
Как такие сравнения выглядели у прошлой версии, видно в репозитории LongCat-2.0 на GitHub. На SWE-bench Pro LongCat-2.0 набрала 59,5 против 58,6 у GPT-5.5 и 69,2 у Claude Opus 4.8. Выходит, GPT-5.5 она обходила всего на 0,9 пункта, а Opus 4.8 была впереди на 9,7. Свои результаты Meituan там мерила сама, в одинаковых условиях для всех моделей, а цифры конкурентов помечены звёздочкой как взятые не из её замеров.
По размеру LongCat-2.5 повторяет LongCat-2.0. Та тоже была смесью экспертов (на каждый токен работает лишь часть весов) на 1,6 триллиона параметров, и окно контекста у обеих 1 миллион токенов. Прибавку Meituan обещает в понимании изображений и в коде, а саму модель строили под длинные агентные сценарии.
Активных параметров на токен у LongCat-2.5, по словам Meituan, 49 миллиардов. TechNode и Pandaily называют около 48 миллиардов, ровно столько же было у LongCat-2.0.
Дальше
Codedict срезал токены Claude Code на 63%, а счёт на 26%
В бенчмарке автора codedict, локального индекса кода без ИИ, токенов в Claude Code ушло на 63% меньше, а счёт в долларах упал только на 26%. Самая дорогая часть сессии, кэш контекста, никуда не делась. У вас сессии Claude Code упирались в лимит раньше, чем задача была решена?
Читайте также
- Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
- Meituan выпустила LongCat-2.0 на 1.6 триллиона параметров
- Qwen3.8-Omni-Flash слушает звук и смотрит видео
- Заявка MAI-Image-2.6 на второе место в Arena
- Microsoft обещает в MAI Code 2 почти Opus за 5% цены
- Qwen4-Max набрала 43 балла и обошла Qwen3.8 Max на 9
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.