
В тесте Abnormal дообученная kev-4b обошла фронтирные LLM
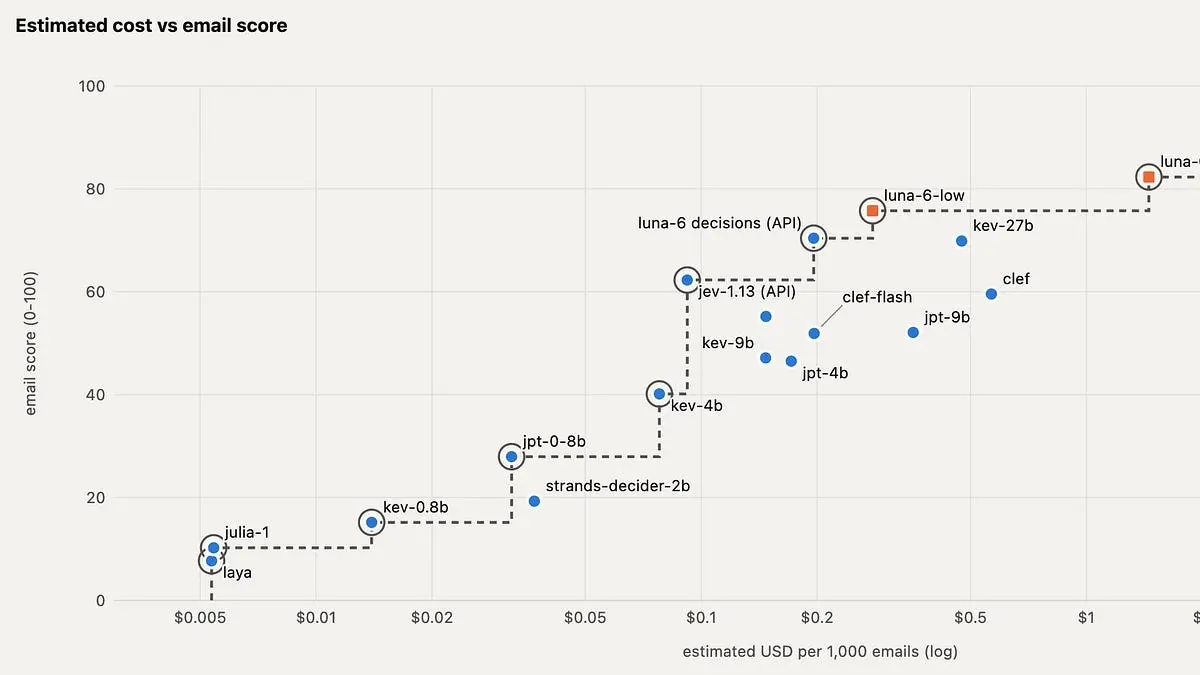
Abnormal сравнила 40 моделей на одном наборе трудных писем: Jev от TypeSafe, OpenAI Decisions API, 34 открытые модели решений на собственных серверах и четыре конфигурации фронтирных LLM. Затем компания сама дообучила одну из маленьких открытых моделей. Методику и результаты она описала 8 октября в инженерном блоге Abnormal. Главная метрика теста - доля атак, пойманных при точности 99%. Заканчивается пост подсчётом того, во что обойдётся запуск такой модели на всём потоке почты.
Сейчас в продакшене у Abnormal работают поведенческие модели. Они учатся тому, что нормально для каждого отправителя, получателя и организации, и опираются на историю отправителя, аутентификацию и справочник сотрудников. Но такая модель видит только заложенные в неё признаки. LLM, по словам авторов, может прочитать сам запрос так, как прочитал бы аналитик, и понять, станет ли поставщик менять банковские реквизиты посреди переписки о счёте. Модели решений делают это дешевле. Письмо и все вопросы они читают за один прямой проход и возвращают вероятность для каждого варианта ответа, не генерируя ни одного токена, поэтому ответ стоит примерно столько же, сколько чтение входа. Новый детектор при этом начинается с вопроса, сформулированного обычными словами, и не требует ни нового признака, ни переобучения. Среди проверенных систем был и Decisions API, который OpenAI открыла всем в публичной бете 6 октября.
Набор состоит из 1985 полностью синтетических писем без клиентских данных. Каждое сгенерировано так, чтобы совпадать с реальным трудным случаем по классу, типу атаки и сигналам детекции, но без его идентификаторов. В выборку вошли и атаки, и похожие на них ложные срабатывания. Атак в наборе 40%, гораздо больше, чем в любом реальном ящике, и авторы предупреждают, что высокую точность здесь получить проще, чем в продакшене. Все модели получали одну и ту же запись с поведенческими сигналами: историей отправителя, совпадениями по справочнику, возрастом домена. За один запрос нужно было ответить на три вопроса: атака ли это, к какому классу относится письмо (атака, спам, graymail или безопасное) и, если это атака, какого она типа (фишинг, BEC, мошенничество, вредонос или разведка). Модели решений читали запись в родном формате. LLM получали её в JSON и обязаны были вернуть вероятность для каждого варианта по строгой схеме.
Для общего рейтинга Abnormal ввела email score: среднее из macro-F1 по вердикту, macro-F1 по типу атаки и доли пойманных атак при точности 95%. Более крупные модели в нём обычно стоят выше, а впереди фронтирные LLM, но каждый следующий шаг вверх обходится намного дороже предыдущего. Jev и Decisions API попали на границу Парето: дешевле и лучше их одновременно нет никого. Sonnet-5.5-max набрала 88,3 балла при цене 52 доллара за тысячу писем и на графики не попала. Haiku-5.5 вышла уже после того, как пост был написан, и её обещают проверить тем же способом.
Решающей в этом тесте всё же была точность 99%. Письмо, признанное атакой, убирают из ящика, поэтому каждая ложная тревога означает, что клиент не увидит настоящее и часто важное письмо. У большинства моделей кривая «точность-полнота» опускается ниже этой планки задолго до высокой полноты. Если смотреть на эту метрику с учётом цены, на границе остаётся всего несколько моделей. Все открытые модели, которые Abnormal запускала у себя, ловят лишь малую долю атак. Jev удерживается на границе только за счёт цены. Decisions API ловит большую часть того, что находит luna-6-max, а стоит и отвечает в разы меньше.
Показателен случай luna-6-low. Это та же luna-6, только вызванная как обычная LLM с промптом. По средней точности она не уступает Decisions API, но при 99% точности сильно от него отстаёт. Авторы объясняют это тем, что метрики без порога скрывают ровно тот участок кривой, на котором система реально работает.
Вторым критерием была калибровка, совпадение заявленной вероятности с реальной частотой. Система безопасности опирается на вероятность. Выше одного порога письмо убирается автоматически, средняя полоса уходит на ручную проверку, всё остальное доставляется. Пороги должны значить одно и то же у разных клиентов и после обновления модели, а заявленные 0,9 должны означать, что атаками действительно оказываются около 90% таких писем. Лучше всех откалиброван Jev, и оба API решений входят в число лидеров. Фронтирные LLM оказались в середине, даже когда промпт прямо просил честные калиброванные вероятности. Хуже всех маленькие открытые модели, в том числе базовая kev-4b. Из этого авторы делают вывод, что калибровка зависит от модели, а не от интерфейса.
Именно kev-4b компания дообучила на смеси задач классификации писем и не только писем. Это был LoRA ранга 256, одна эпоха из 7500 шагов на 60 тысячах примеров. Прогон на L40S обошёлся примерно в 200 долларов, а чекпойнт выбирали по Brier score. С бенчмарком обучение не пересекается ни по письмам, ни по формату задач. Доля пойманных атак при точности 99% выросла с 7% до 66%, и, по словам авторов, это выше, чем у любой проверенной модели за любые деньги. Калибровка тоже поднялась, из худших в число лучших.
Отрыв этот авторы оговаривают сами: 95-процентные доверительные интервалы пересекаются. У дообученной модели 65,5% [49,8; 80,2], у sonnet-5.5-max 49,9% [45,5; 83,2], оценка получена бутстрепом по 637 тестовым атакам. Если брать порог, подобранный на отложенной части данных, дообученная модель держит точность 98,6% при полноте 67,7%. Точность к тому же считали так, будто атаки составляют половину всей почты, поэтому цифры стоит читать как относительные.
Был и откат. Macro-F1 по типу атаки упала с 68 до 37, и теперь модель записывает большую часть BEC и разведывательных писем в мошенничество. В обучающей смеси был четырёхклассовый вердикт, а типов атак не было, и в Abnormal подозревают, что дообучение отточило навык, которому модель учили, и испортило тот, которому не учили.
Последняя часть поста посвящена запуску в продакшене. Почта из ЕС должна обрабатываться в ЕС, поэтому API подходит, только если умеет работать там, а собственный парк серверов нужен в каждом регионе присутствия. Если считать по измеренной пропускной способности kev-4b и ценам GPU по требованию, обслуживание выходит дороже, чем на графиках, даже без простоя. Почта к тому же следует рабочему дню, пикам нужен запас, и реальная загрузка ниже. А чтобы запускать 4B-модель на каждом письме при таком объёме, нужен парк GPU, который трудно собрать даже при наличии бюджета. Аналогичная детекция в текущем онлайн-стеке Abnormal стоит около цента за тысячу писем на смеси CPU и GPU-ускорителей. В эту сумму входят только ML-модели в пути оценки в реальном времени, без приёма, парсинга и хранения. По оценке авторов, модели решений снизили цену LLM-суждения с долларов до центов за тысячу писем, а задержку с секунд до миллисекунд. Этого хватает для той доли трафика, которую к ним пропускает префильтр, но не для всей почты.
Свою будущую архитектуру Abnormal описывает как смесь: «дешёвые модели на всём, модели решений за префильтрами, фронтирные LLM на тех немногих письмах, которым нужно настоящее рассуждение», плюс петли обратной связи, через которые система будет улучшаться сама.
Дальше
OpenAI впервые нашла операцию влияния пятой категории
Сотрудники латиноамериканского «исследовательского центра» брали интервью и писали статьи, не подозревая, что ими управляют из России. OpenAI оценила эту операцию на 5 баллов из 6, впервые за всё время своих отчётов.
Читайте также
- Decisions API от OpenAI вышел в публичную бету для всех
- OpenAI научила Luna выбирать ответ за 150 миллисекунд
- Jev дешевле Claude Fable в 274 раза, но точность 98%
- Haiku 5.5 заметила утечку, которую пропустил GPT-6.1 Sol
- Fable 5.2 обошлась в 13,39 доллара против 3,99 у Astra
- Opus 5.5 обошёл GPT-6 Astra в тесте на стабильность
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.