
OpenAI отозвала рекомендацию по бенчмарку SWE-Bench Pro
OpenAI провела аудит SWE-Bench Pro и оценила, что около 30% задач в наборе сломаны. Ранее компания советовала переходить на этот бенчмарк вместо SWE-bench Verified, теперь рекомендацию отзывает.
Автоматический конвейер пометил 200 задач как проблемные (27,4%), а разбор с участием инженеров нашёл битыми 249 из 731 задачи публичной части (34,1%). Каждую задачу проверяли пять опытных разработчиков.
Ошибки разделили на четыре типа: слишком строгие тесты, недоописанные условия, тесты со слабым покрытием и вводящие в заблуждение формулировки. Больше всего расхождений пришлось на слабое покрытие: люди отметили его в 9,4% бенчмарка против 4,1% у агентного конвейера. На публичной части из 731 задачи топовые модели за восемь месяцев подняли долю решений с 23,3% до 80,3%.
Дальше
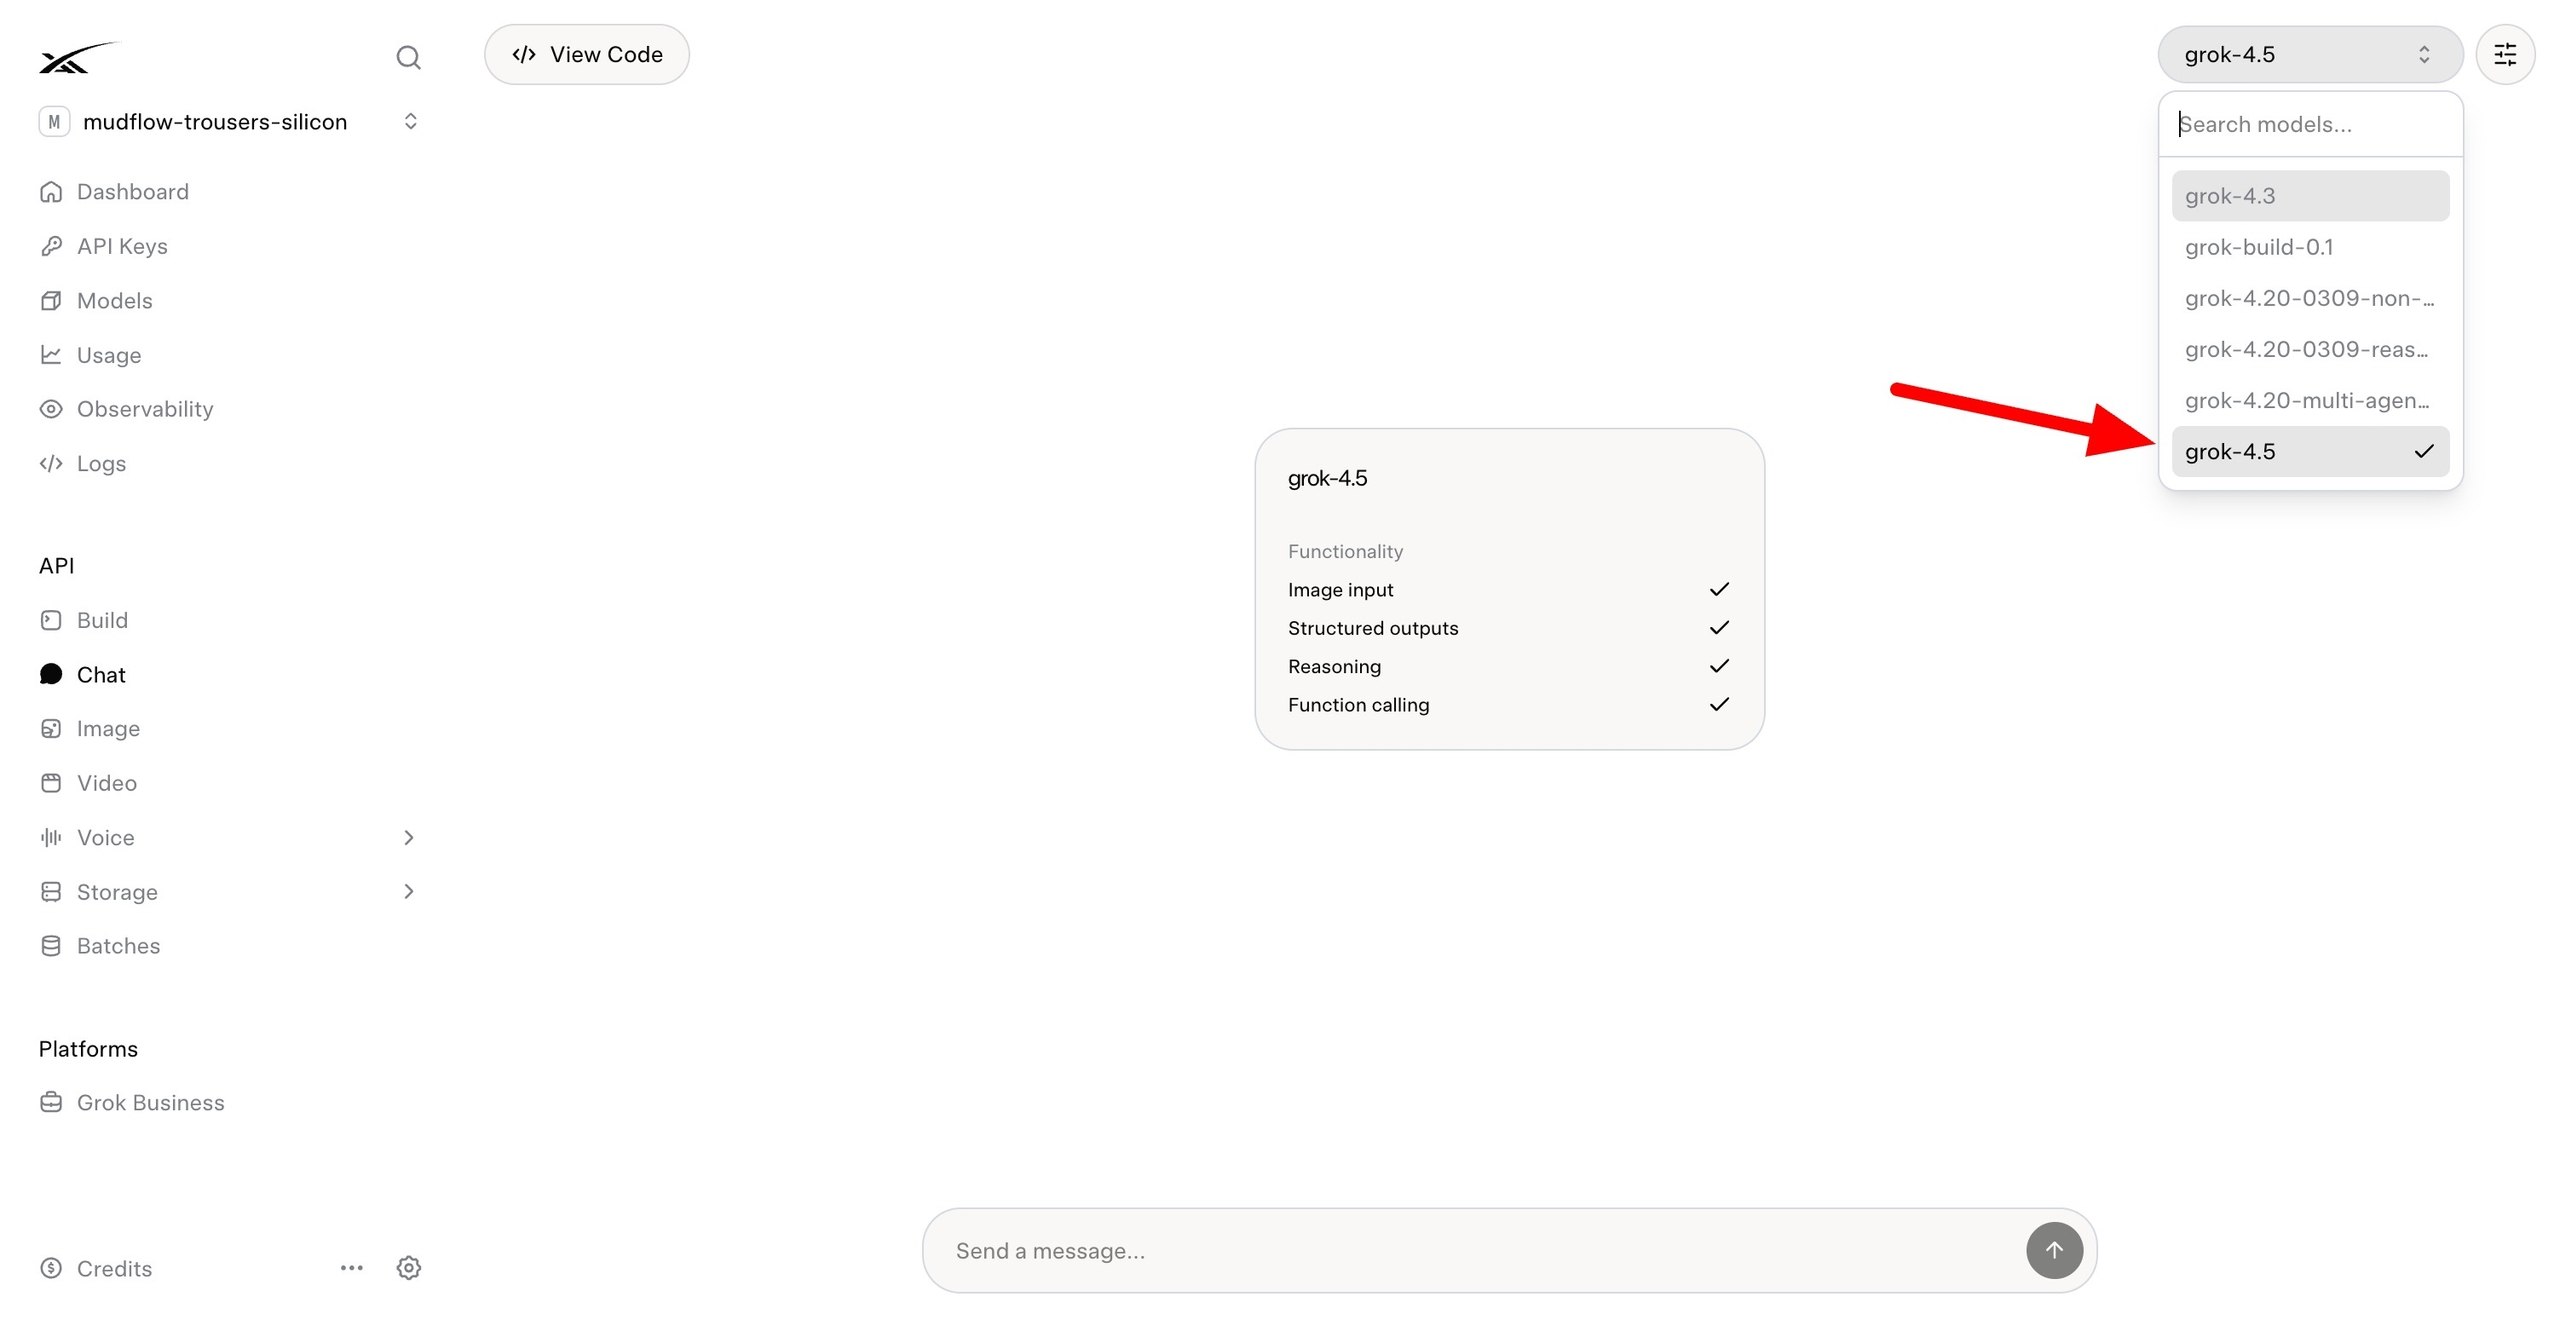
Grok 4.5 выходит в API с окном на 500 тысяч токенов
Контекст на 500 тысяч токенов, вход $2 и выход $6 за миллион токенов: Grok 4.5 раскатывается на Grok Build, в API и консоли xAI. На бенчмарках по кодингу модель идёт вровень с GPT 5.5 и близко к Opus 4.8.
Читайте также
- Задачи OpenAI для Comparator решаются подменой определения
- В тесте Abnormal дообученная kev-4b обошла фронтирные LLM
- Vending-Bench: Astra обошёл Fable 5.1 почти втрое
- Независимый трекер меряет Codex на SWE-Bench-Pro ежедневно
- Отключённые рассуждения дали Astra 96,7% на ARC-AGI-3
- Astra заявлена лучшей в тестах работы за компьютером
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.