
Независимый трекер меряет Codex на SWE-Bench-Pro ежедневно
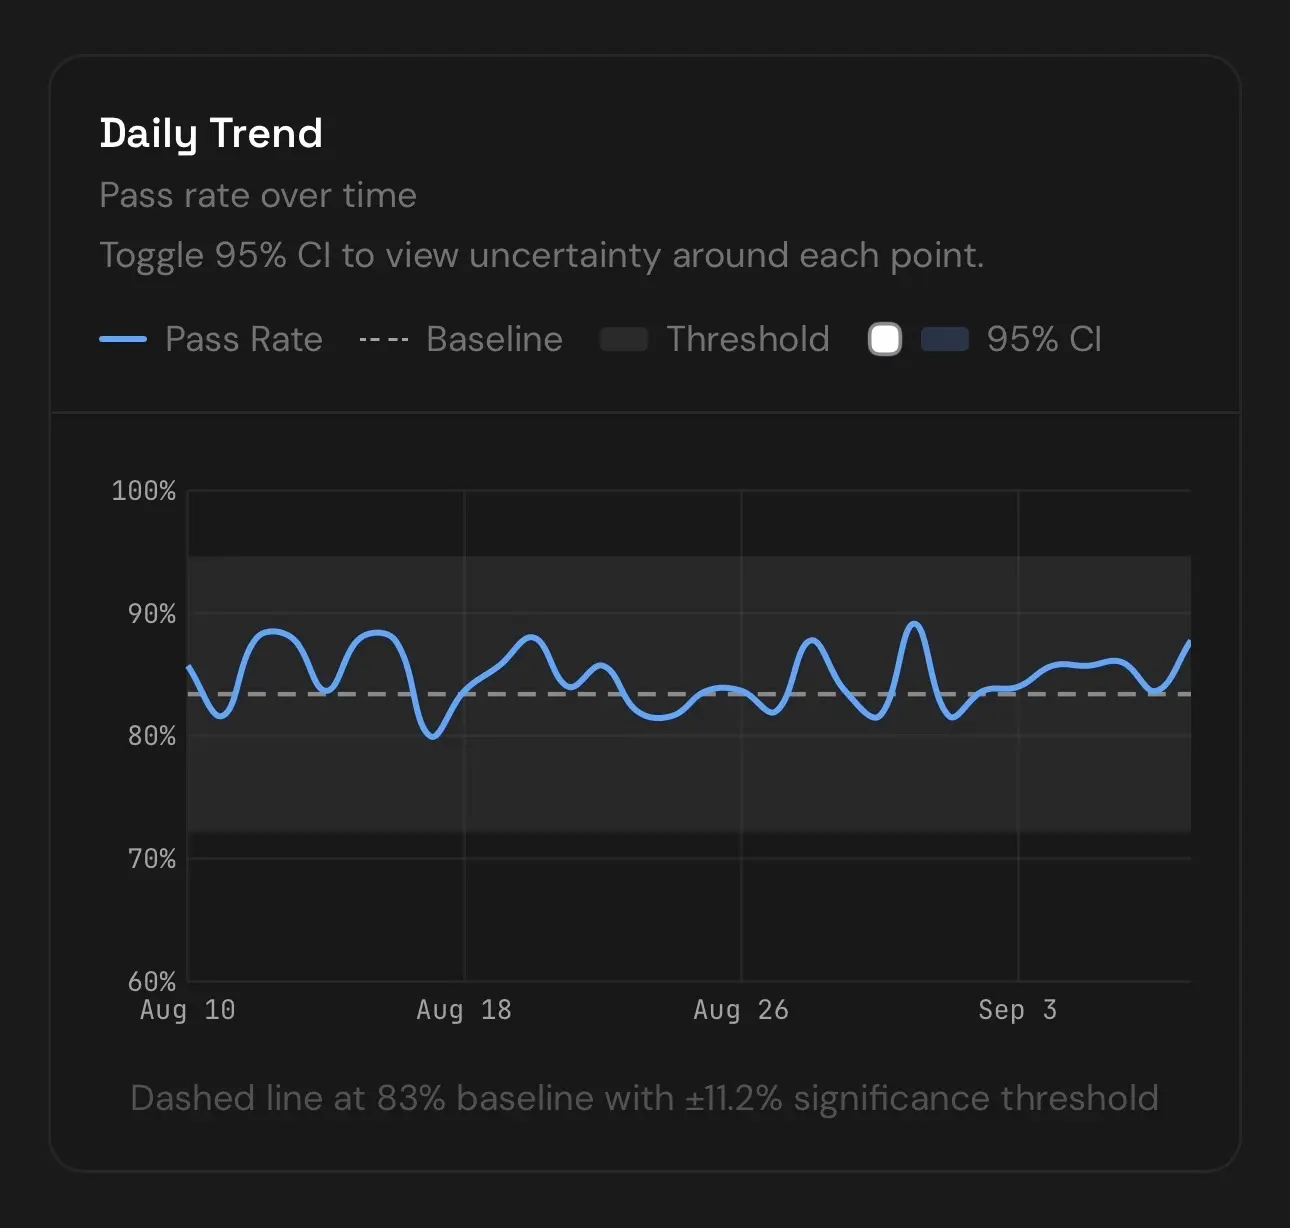
На 8 сентября у Codex с gpt-5.6-sol статус «Nominal»: трекер Marginlab значимой просадки на задачах по разработке не нашёл. Интереснее самого процента порог, после которого падение считается настоящим. На дневном графике он широкий: ±11,2% вокруг опорной линии.
Устроен трекер просто. Каждый день он прогоняет 50 задач из отобранного подмножества SWE-Bench-Pro. В этом бенчмарке агент чинит код в реальных репозиториях. Модель запускают прямо в Codex CLI без собственной агентной обвязки, так что замеряют ту же связку, с которой работают разработчики. Результат сравнивают с опорной линией 83%, это историческое среднее. Отклонение считается значимым только при p < 0,05. Замеры проводит MARGIN EVALS.
Последние цифры: за день 88% на 50 прогонах, за 7 дней 85% на 350, за 30 дней тоже 85% на 1 500. Дневные 88% означают 44 решённые задачи из 50.
На выборке в 50 задач коридор ±11,2% вмещает колебание больше чем в пять задач в каждую сторону, поэтому дневной график поднимет тревогу только при крупном обвале. Недельное окно в 350 прогонов точнее: там порог сужается до ±3,6%. Разницу трекер объясняет размером выборки: чем меньше прогонов, тем шире 95-процентный доверительный интервал вокруг точки. Недельные 85% выше опорных 83%, но тоже не выходят за этот узкий коридор.
Зачем здесь статистика, видно по чужому опыту. В постмортеме о деградации Claude Anthropic назвала причиной три инфраструктурных бага, из-за которых качество ответов периодически падало, и признала, что первые жалобы пользователей трудно было отличить от обычного разброса отзывов. В том же тексте компания написала: «Мы никогда не снижаем качество модели из-за спроса, времени суток или нагрузки на серверы». Из-за одного из этих багов часть запросов к Sonnet 4 уходила на серверы, настроенные под контекстное окно в 1 млн токенов. В худший час это коснулось 16% запросов.
В самом Codex сдвиги тоже находили. По разбору метаданных за февраль-июнь ответы GPT-5.5 непропорционально часто обрывались ровно на 516 токенах рассуждений, и доля таких обрывов выросла с 0,11% в феврале до 53,3% в мае.
Позже жалобы появились и на следующие модели. Пользователь Codex на Windows с подпиской ChatGPT Pro написал в трекере Codex на GitHub, что примерно с середины сентября gpt-6-astra и gpt-6.1-sol на максимальном уровне рассуждений заметно хуже справлялись с реальными задачами по коду и агентной работой. По его словам, прежнее качество ненадолго, дня на два, возвращалось, а ещё ему приходили ошибки «Selected model is at capacity».
А 10 октября в треде на форуме OpenAI Developer Community Codex назвали «практически непригодным». Автор треда подозревает, что запросы уходят на модель уровня GPT-4o-mini, какую бы модель ни выбрал пользователь.
Дальше
Кристиано усилит надзор за безопасностью OpenAI
«Независимый голос, который будет оспаривать допущения», так OpenAI описала роль Пола Кристиано в совете Foundation. Основатель Alignment Research Center войдёт и в комитет по безопасности и защите.
Читайте также
- Сохранение рассуждений подняло ARC-AGI-3 с 13,3% до 38,3%
- GPT-6.1 Sol переносит COBOL с точностью 86,6% вместо 5,4%
- Fast-режим отваливается в десктопном Codex с API-ключом
- Sol переписала ядра OpenAI и срезала 20% стоимости
- ChatGPT Work и Codex достигли 10 млн активных пользователей в неделю
- В Codex нашли подозрительную кластеризацию reasoning-токенов у GPT-5.5
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.