
OpenAI представила GeneBench-Pro
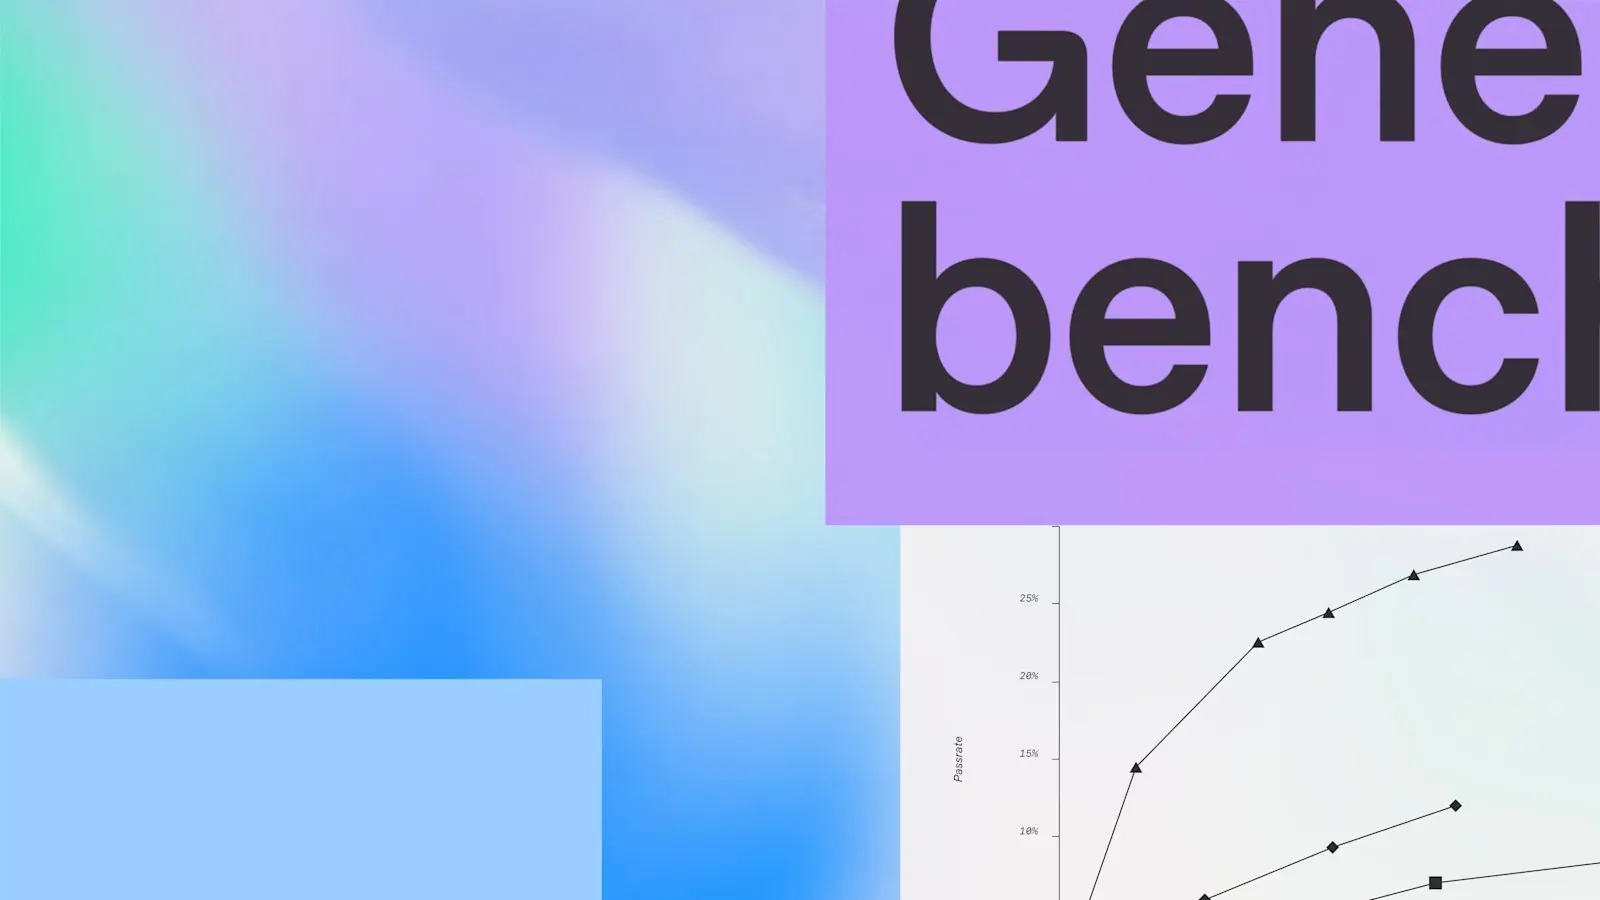
GeneBench-Pro это бенчмарк из 129 задач по вычислительной биологии: геномика, количественная биология, трансляционная медицина. Задачи проверяют не знание фактов, а способность модели делать исследовательские суждения: справляться с неоднозначностью, пересматривать гипотезы и выбирать верный путь анализа.
Каждая задача построена синтетически с известной причинной структурой, поэтому ответы оцениваются детерминированно. 82 из 129 задач проверяли внешние эксперты.
Лучшая модель GPT-5.6 Sol набирает 28.7% на максимальном уровне reasoning и 31.5% в Pro-режиме. Год назад на исходном GeneBench модель GPT-5 давала меньше 5%. Одна задача требует у человека 20-40 часов работы при инференсе в несколько долларов. OpenAI открывает 10 задач на Hugging Face и передаст 50 задач сервису Artificial Analysis для независимой оценки.
Дальше
Anthropic выпустила Claude Sonnet 5
Claude Sonnet 5 на максимальном reasoning подтягивается к Opus 4.8 на бенчмарках OSWorld-Verified и BrowseComp, но стоит дешевле большой модели. До 31 августа API отдают по 2 доллара за миллион входных токенов и 10 за выходные, потом цена вырастет до 3 и 15.
Читайте также
- Задачи OpenAI для Comparator решаются подменой определения
- Отключённые рассуждения дали Astra 96,7% на ARC-AGI-3
- GPT-6 Astra набрала 99,9% в ARC-AGI-3
- Codex решил 20 проблем Эрдёша на 20 параллельных аккаунтах
- Lean-версия доказательства OpenAI разошлась с текстом
- У 722 математических статей OpenAI нет адреса для писем
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.