
GPT-6 Astra набрала 99,9% в ARC-AGI-3
GPT-6 Astra от OpenAI прошла 99,9% полузакрытого набора ARC-AGI-3, но только в обвязке Provider Adapter, которая хранит непрозрачное состояние рассуждений модели между запросами. В стандартной обвязке, одинаковой для всех вендоров, лучший результат той же модели составил 62,7%. Об этом говорится в отчёте ARC Prize от 3 сентября.
Для этого бенчмарка скачок дают оба числа. В статье с описанием ARC-AGI-3 сказано, что в марте 2026 года передовые системы набирали на нём меньше 1%, а люди решают 100% сред. ARC-AGI-3 - третье поколение серии и первое интерактивное. Агент попадает в пошаговую абстрактную игру без инструкций, сам исследует её, угадывает цель по редким сигналам награды, строит модель правил и планирует ходы, поправляя план по мере появления новой информации. Среды опираются только на базовые представления о мире (core knowledge priors), а сложность выверена на живых участниках.
Что делает обвязка
Обвязка (harness) - программа вокруг модели: она передаёт наблюдения из среды, принимает действия и решает, что модель помнит между вызовами. В Standard модель получает всю информацию, нужную для решения, но из шага в шаг переносит только видимые заметки, которые решила сохранить сама. ARC Prize называет этот интерфейс минимальным и нейтральным к провайдеру, поэтому модели разных вендоров сравниваются в одинаковых условиях. Provider Adapter отвечает на другой вопрос: как модель играет, когда у неё есть средства управления контекстом, которые для неё сделал сам провайдер. У Astra это сохранение скрытого состояния рассуждений между запросами (его ARC Prize не видит) и сжатие длинных диалогов, чтобы модель могла повторно использовать уже сделанную работу.
Разница видна не только в очках. По всем уровням рассуждений на наборах Public и Semi-Private прогоны с Provider Adapter шли примерно в 3,66 раза быстрее по суммарному времени и израсходовали на 49% меньше токенов. Считали по 167 парам «игра - уровень рассуждений», которые решили обе обвязки.
Условием для будущего AGI организаторы считают Standard: по их словам, будущий AGI должен справляться с ARC-AGI-3 именно так. Так что заголовочные 99,9% получены в режиме, где рабочая память модели закрыта даже от тех, кто её тестирует. А у Astra эта закрытость уже вызывала вопросы: по сведениям The Information, модель раскрывает меньше своего «мышления», чем другие передовые модели.
Дальше ARC Prize будет публиковать в лидерборде результаты обеих обвязок с явной пометкой условий. Оба подхода описаны в открытом репозитории для тестирования и в правилах проверки.
Почему max обходится дешевле
Обычно больший бюджет на рассуждения стоит дороже. У Astra вышло наоборот: на высоких уровнях она решает игры за меньшее число действий, а значит, делает меньше вызовов и тратит меньше токенов. Полная таблица ARC Prize, полузакрытый набор, сначала Standard, затем Provider Adapter:
- max: 62,7% за 26 098 долларов; 98,6% за 17 332 доллара
- xhigh: 59,3% за 37 317 долларов; 98,4% за 18 147 долларов
- high: 54,8% за 40 705 долларов; 99,9% за 18 817 долларов
- medium: 38,6% за 48 090 долларов; 98,4% за 19 285 долларов
- low: 17,5% за 38 166 долларов; 98,0% за 21 298 долларов
- none: 35,2% за 49 791 доллар; 96,7% за 23 457 долларов
В Provider Adapter цена падает на каждой ступени от none к max. В Standard картина неровная: max там одновременно самый дешёвый и самый точный из шести режимов, а режим без рассуждений набрал больше, чем low. Лучший результат в Provider Adapter дал high, а max в этой обвязке оказался самым дешёвым прогоном во всей таблице.
Для сравнения ARC Prize приводит цену людей. Участникам контролируемого тестирования платили 115 долларов за 90-минутную сессию и ещё 5 долларов за каждую пройденную игру. За сессию человек пробовал около девяти игр, так что попытка обходилась примерно в 12,78 доллара без бонусов. Организаторы оговаривают, что эти деньги платят за время и согласие пройти тест. Если считать только энергию мозга (20 Вт по цене электричества 0,20 доллара за кВт·ч), сессия стоит около 0,6 цента, а попытка одной игры - 0,067 цента.
Меньше ходов, чем у медианного человека
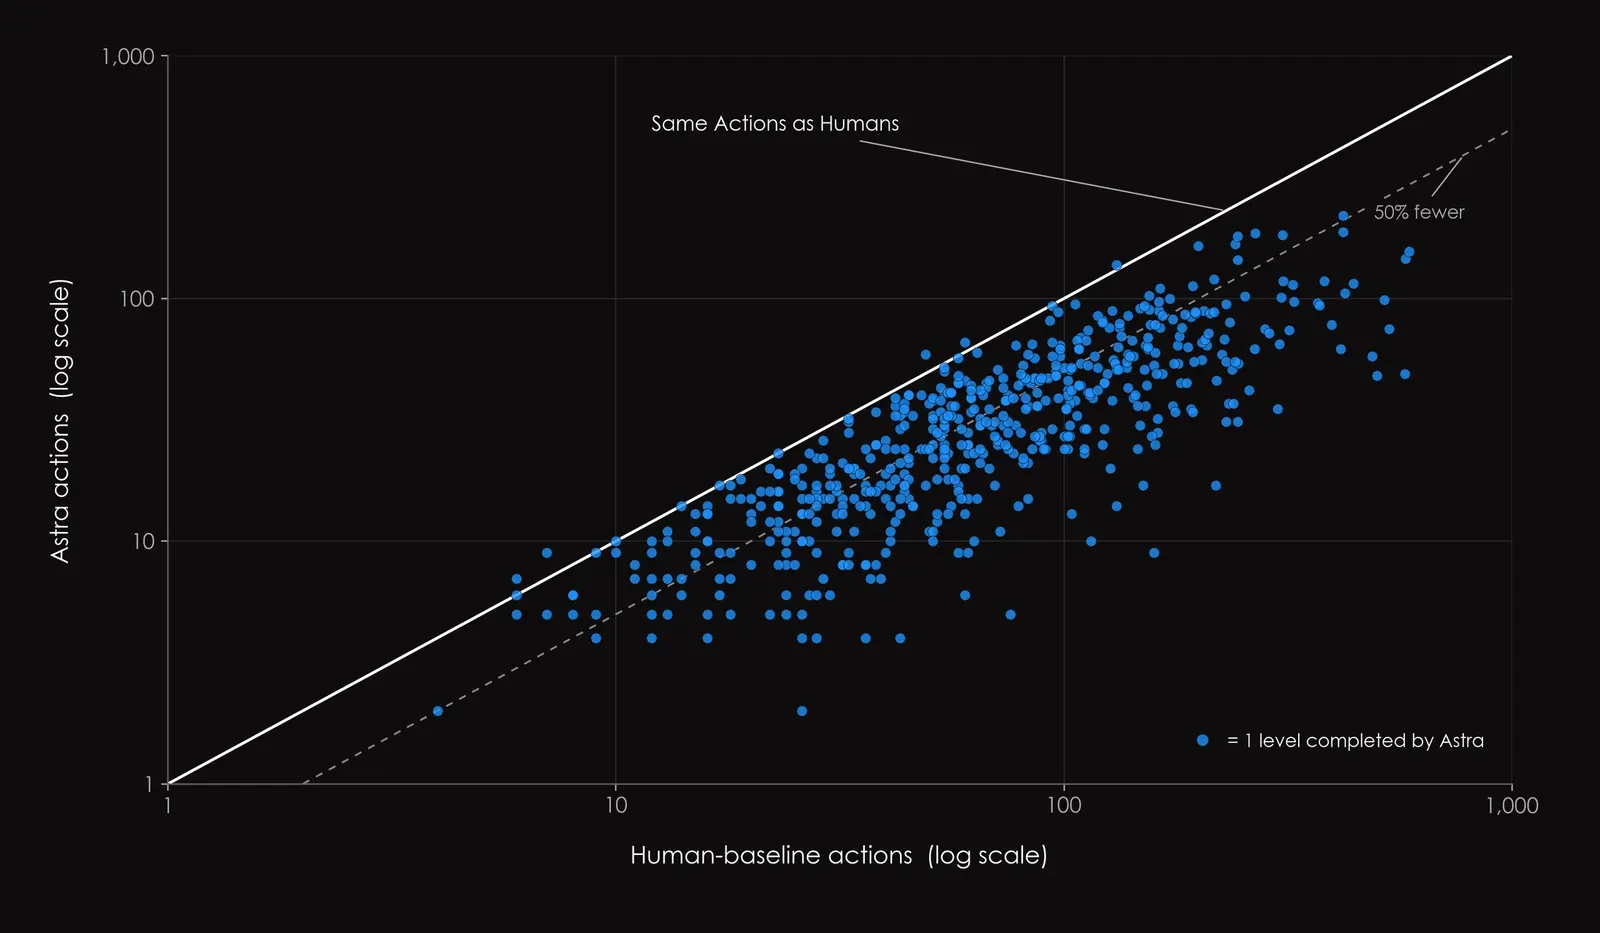
ARC-AGI-3 считает не только то, решена ли среда, но и сколько действий на это ушло. Перед запуском бенчмарка ARC Prize прогнала через игры около 500 человек из широкой публики, никого не отбирая по опыту в головоломках. Человеческим ориентиром для каждого уровня стала медиана числа действий среди тех, кто уровень прошёл.
Astra (max) в Provider Adapter обошлась меньшим числом действий, чем этот ориентир, на 96,0% уровней и в среднем тратила на уровень на 51,7% действий меньше. По мерке ARC-AGI-3 модель сравнялась с людьми по эффективности действий и превзошла их, организаторы называют это существенной вехой. Эффективность по стоимости показывает, сколько вычислений ушло на задачу, а эффективность действий - сколько опыта взаимодействия со средой понадобилось.
Сами организаторы до запуска ждали другого. Они предполагали, что эффективность действий останется границей между людьми и ИИ: даже решив среду, модель будет тратить на исследование заметно больше ходов. Для перебора грубой силой так и вышло, но у передовых моделей, по наблюдению ARC Prize, картина почти бинарная: «Как только передовой ИИ „понимает“ механику, он обычно действует в пределах человеческой эффективности».
Алгебра на лету
Из повторов игр видно, как Astra переводит незнакомую механику в рабочую модель. В заметках, которые она решает сохранить, модель отслеживает объекты, координаты, правила и незаконченные планы, а для сред придумывает собственную компактную запись. Похожее ARC Prize видела и у других моделей, но заметки Astra выделялись точностью и плотностью: в похожей на код символьной форме модель записывала, где стоят объекты, как они взаимодействуют и какие действия в каком порядке нужно сделать. Организаторы подчёркивают, что речь идёт о стенографии, придуманной на ходу, полноценным языком программирования она не стала.
Примеры из игры s5i5: план extend8 to3; retract10 to2; shorten8 to1 задаёт упорядоченную цепочку изменений для механизмов цвета 8 и 10, а строка 9−=(39,4), rotate=(49,18), 14+=(59,11) связывает операции с координатами элементов управления. В игре wa30 запись Turn 5: P=(24,20), empty, facing west соединяет номер хода, позицию игрока, то, что он несёт, и направление взгляда.
Отдельно Astra проверили в обвязке PRO-LONG, одного из первых партнёров ARC-AGI-3 по red-teaming. Там у модели была песочница для запуска собственного кода, и для каждой игры она собирала свой набор инструментов: парсеры поля, модели состояния, алгоритмы поиска, планировщики, постоянные заметки. В длинных прогонах дело доходило до маленьких библиотек под конкретную игру. В tu93, лабиринте с охраной и движущимися патрулями, модель начала с навигации и написала maze_solver.py, затем добавила правила боя в combat_solver.py, патрули в patrol_solver.py, а sync_state.py сверял её предсказания с наблюдениями. Попыток выбраться из песочницы, как уточняет ARC Prize в сноске, замечено не было.
С людьми эти результаты напрямую не сравнить: у участников тестирования не было ни интерпретатора кода, ни черновика. Поэтому PRO-LONG организаторы считают совместным результатом модели и её инструментов.
Почему это ещё не AGI
У ARC-AGI-3 жёстко ограничены рамки и формат: механика и цели во всех средах детерминированы и замкнуты, сложности и открытости реального мира в них нет. ARC Prize сейчас изучает вопросы, которые должны определить следующее поколение бенчмарков, в том числе как оценивать рекурсивное самоулучшение и изобретательство без заданного финала. Сам AGI организаторы определяют как способность системы освоить любой навык, доступный человеку, так же эффективно, как человек.
Ещё при запуске ARC-AGI-3 они оговаривали, что насыщение бенчмарка не станет доказательством AGI. Astra ARC Prize называет заметным скачкообразным изменением возможностей передовых моделей, но прямо добавляет: «мы не утверждаем, что это AGI».
Дальше
Gemini Live получил доступ к Gmail и Spark, Видео
Gemini Live получил доступ к Gmail. Голосом можно искать, кратко пересказывать, помечать, архивировать и удалять письма, причем все операции выполняются без рук.
Читайте также
- Отключённые рассуждения дали Astra 96,7% на ARC-AGI-3
- Astra заявлена лучшей в тестах работы за компьютером
- Цифры в блоге про Astra менялись после публикации
- Astra дошла до Pro и Business, Plus ждёт
- GPT-6 Astra спроектировала гаджет для Codex без правок людей
- Задачи OpenAI для Comparator решаются подменой определения
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.