
GPT-6.1 Sol переносит COBOL с точностью 86,6% вместо 5,4%
GPT-6.1 Sol переносит программы с COBOL на современные языки без изменения поведения в 86,6% случаев при низком уровне рассуждений. У GPT-5.6 Sol было 5,4%, сообщила OpenAI 19 октября в посте о малоресурсных языках. На графиках того же поста есть ещё одна цифра: на втором тесте, MultiLangBench, GPT-6.1 Sol набирает в среднем 87,03% против 87,38% у флагмана GPT-6 Astra, а прогон обходится в 7,53 доллара вместо 32,18.
Малоресурсными OpenAI называет языки, для которых в обучающих данных мало кода и документации: COBOL, Fortran, Visual Basic. Цифры по COBOL компания берёт у IBM: на нём держатся более 40% систем онлайн-банкинга, 80% очных транзакций по картам и 95% операций в банкоматах. На Fortran считают прогнозы погоды и анализ безопасности ядерных реакторов. По словам OpenAI, работу направляют отзывы разработчиков и корпоративных клиентов, которые жаловались, что модели для кода с этими языками часто не справляются. В таких системах документация бывает неполной, авторы кода давно ушли, а часть бизнес-правил записана только в самом коде.
Где ломается миграция
В тесте на миграцию модель переносит программы на COBOL на C++, Java, Kotlin, Python или Rust. Проверяют её скрытыми тестами, которые требуют побайтового совпадения наблюдаемого вывода, и миграция засчитывается, только если прошли все тесты. OpenAI приводит пример тонкой ошибки: арифметика с фиксированной точкой в COBOL отбрасывает лишние знаки после запятой, если округление не запрошено явно. Переписанная программа, которая вместо этого округляет, отработает без ошибок, но выдаст другие финансовые результаты.
На низком уровне рассуждений GPT-6.1 Sol набирает 86,6% при средней стоимости 0,31 доллара за задачу, а GPT-5.6 Sol на той же настройке выдаёт 5,4% за 0,51 доллара. Отсюда и «на 39% дешевле». Результат 97,9% достигается на уровне xhigh за 0,70 доллара и 28 454 выходных токена, а на max он тот же, но уже за 0,98 доллара и 45 838 токенов. Кривая немонотонна: на medium 96,9%, на high 95,9%. GPT-6 Astra на xhigh и max доходит до 96,8% за 3,26 и 4,51 доллара, GPT-6 Sol на max до 95,8% за 1,92, GPT-5.6 Sol на max останавливается на 65,2%.
Сама OpenAI оговаривается, что для продакшена всё равно нужны экспертная проверка и тесты на бизнес-правилах и зависимостях конкретной системы. Тесты миграции скрыты, ни набор данных, ни код к ним не опубликованы.
SQLite с нуля на 20 языках
В MultiLangBench модель пишет на заданном языке движок, совместимый с SQLite. Программа получает исходную базу и SQL-запрос и возвращает изменённую базу, а её содержимое проверяет эталонный SQLite, поэтому тесты одинаковы для любого языка. Подробности условий есть в README репозитория: движок пишется по документации SQLite 3.40.1, интернета нет, все следы SQLite из окружения удаляются, путь к базе передаётся аргументом командной строки, а запрос через stdin. Там же сказано, что тесты переделаны из TCL-набора SQLite и из 51 тысячи удалось конвертировать 24 тысячи, а результат записывается парой из стоимости API и доли пройденных тестов.
На максимальном уровне рассуждений GPT-6 Astra проходит в среднем 87,4% тестов, у GPT-5.6 Sol было 26,8%. COBOL вырос с 10,9 до 72,1%, OCaml с 25,6 до 85,8%, Fortran с 21,4 до 83,5%, Visual Basic с 27,5 до 89,4%. Выше 83% Astra набирает в 19 языках из 20, а за COBOL идут Fortran (83,5%), Lean (84,0%) и Scala (84,8%). Лучше всего у неё PHP с 91,3%.
GPT-6 Luna на максимуме набирает 40,3%, а прогон стоит в среднем 0,77 доллара против 3,48 у GPT-5.6 Sol, примерно на 78% меньше. COBOL у неё поднялся только до 17,1%, а слабее всего PowerShell с 31,1%.
В тексте поста OpenAI выдвигает на первый план Astra, а GPT-6.1 Sol на MultiLangBench появляется только на графике средних, со значением 0,8704. По данным графиков Astra опережает её на максимуме всего на 0,35 пункта, а стоит в 4,3 раза дороже. Один прогон Astra на COBOL обходится в 54,72 доллара. GPT-6.1 Sol на max обходит Astra в семи языках из 20: C, COBOL (72,6% против 72,1%), Fortran (84,1% против 83,5%), Go, OCaml, Python и Scala. Слабее всего у неё Lean с 81,9%.
Авторский разбор
Что мы проверили
20 октября мы скачали репозиторий MultiLangBench, пересчитали тесты, прогнали на них заглушку, которая просто передаёт запросы настоящему SQLite 3.40.1, и пересчитали 440 записей из графиков в посте OpenAI.
Заголовочные цифры OpenAI сходятся с данными её же графиков, а официальный набор тестов эталонный движок проходит целиком. Но OpenAI пишет, что выкладывает на GitHub среду оценки и результаты по каждому языку, а в репозитории лежат только тестовые данные и генератор эталонов, результаты по языкам есть лишь в графиках поста. Прогонщик для сторонних замеров каждой команде придётся писать самой.
- Тестов 23 939, из них 272 с префиксами 00, 01 и 02: именно этот набор README велит использовать для оценки. Все имена тестов совпадают с хешами их файлов.
- Скриптов в репозитории три: удаление SQLite, генерация эталонов и проверка хешей. Таймаут в 60 секунд, провал при падении и ноль за решение не на том языке описаны только в README, кодом это не проверяется. Язык решения README предлагает проверять другой языковой моделью.
- Средние по графикам: Astra 87,38%, GPT-5.6 Sol 26,77%, Luna 40,30%. Luna дешевле GPT-5.6 Sol на 77,9%.
- Заглушка с настоящим SQLite проходит все 272 теста за 13,9 секунды на одном CPU. Так что максимальный балл достижим, а дорого обходится сессия модели, а не проверка.
- На более широком срезе из 1 516 тестов с префиксом 0 та же заглушка провалила один:
degrees(acos(0.5))на нашей машине aarch64 вернул 60.00000000000001, а эталон ждёт 59.99999999999999. Прогон был один и на одной архитектуре, набор из 272 тестов это не затрагивает. Но при прогоне полного набора, который README разрешает ради точности, корректная реализация может потерять тест из-за платформенной плавающей точки.
Дальше
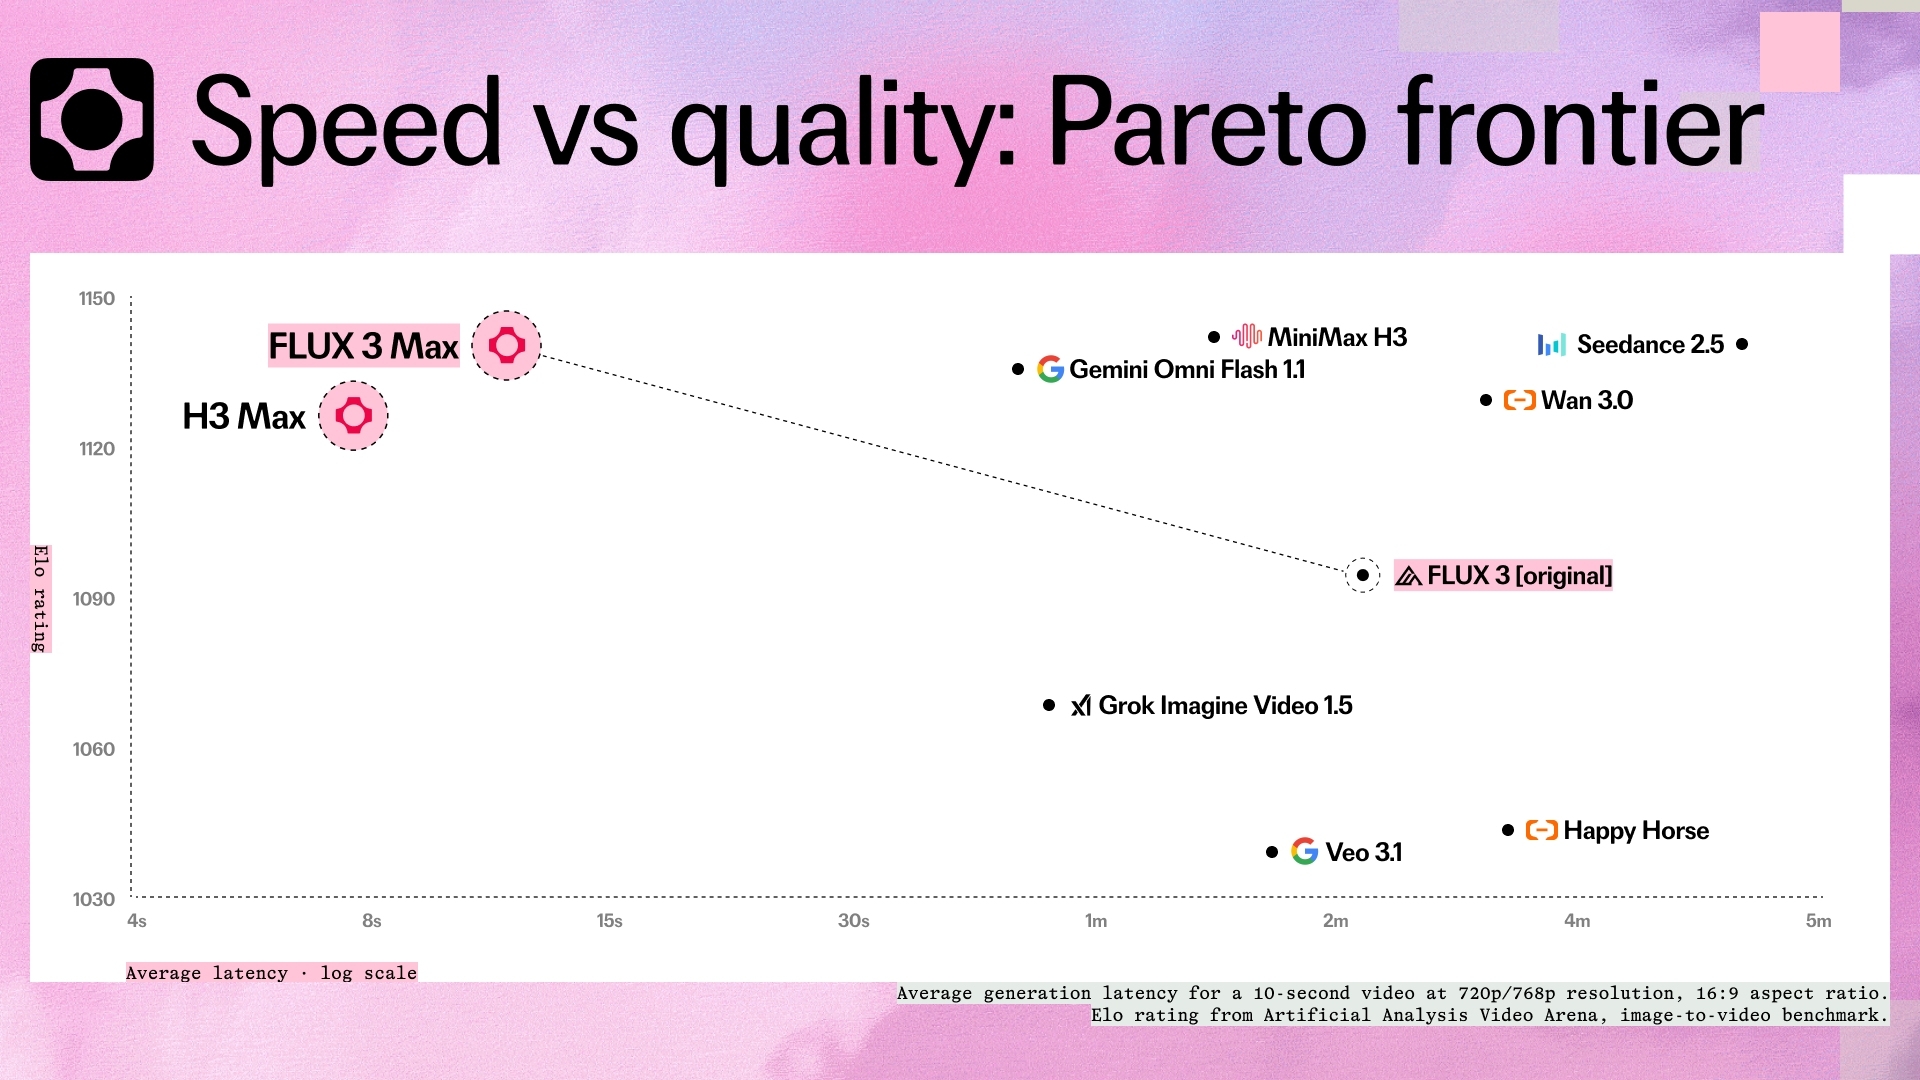
FLUX 3 Max делает 10-секундное видео примерно за 11 секунд
Десятисекундный ролик FLUX 3 Max собирает примерно за 11 секунд, а Seedance 2.5 в том же тесте fal тратила 277,8 секунды. Цифра снята в тестовой конфигурации, и fal прямо пишет, что реальное время зависит от настроек. Сколько секунд вы готовы ждать одну генерацию видео?
Читайте также
- Цены за токен у GPT-6 Sol и Luna упали вдвое и больше
- Независимый трекер меряет Codex на SWE-Bench-Pro ежедневно
- Fast-режим отваливается в десктопном Codex с API-ключом
- Sol переписала ядра OpenAI и срезала 20% стоимости
- ChatGPT Work и Codex достигли 10 млн активных пользователей в неделю
- В Codex нашли подозрительную кластеризацию reasoning-токенов у GPT-5.5
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.