
GPT-6 Astra сначала получат клиенты Daybreak
Новый флагман OpenAI GPT-6 Astra, представленный 3 сентября, будет стоить в API 10 долларов за миллион входных токенов и 50 долларов за миллион выходных, в 2,5 раза больше нынешней промо-цены GPT-5.6 Sol, сообщает The New Stack. Счёт за задачу вырастет меньше цены токена, только если Astra действительно доходит до результата за меньшее число шагов и повторов. OpenAI говорит, что на нескольких оценках и в тестах партнёров модель тратит меньше токенов, но по данным запуска пока нельзя понять, покрывает ли экономия наценку.
Первыми Astra получили корпоративные клиенты, у которых уже есть доступ через программу Daybreak. Пользователям Plus, Pro, Business и Enterprise, а также клиентам API и AWS OpenAI обещает модель «в ближайшие дни». Кроме AWS Bedrock, компания называет ещё Microsoft Azure. В Pro, Business и Enterprise появится и GPT-6 Astra Pro. Подходящие клиенты API смогут работать с Astra в режиме Zero Data Retention, при котором OpenAI не хранит данные запросов. Младших версий вроде Luna, Terra и Sol, которые были у GPT-5.6, для GPT-6 не объявили: пока в линейке только Astra и Astra Pro.
Столько же, 10 и 50 долларов, Anthropic берёт за Fable 5.1. Muse от Meta по стандартному тарифу стоит 1,25 и 4,25 доллара. Версия Contributor стоит 0,10 и 0,20 доллара, но данные с этого тарифа Meta может использовать для улучшения своих продуктов. Gemini 3.8 Flash от Google по вводной цене обходится в 0,75 и 3,75 доллара. «Значение имеет цена за задачу», - сказал президент OpenAI Грег Брокман. Сравнивать расход токенов по цифрам OpenAI стоит с поправкой: если не указано иное, компания гоняла модели в своих оценках на максимальном уровне усилий. Так результаты выходят выше, но растут задержка и расход токенов.
Что меняется в Codex
Для разработчиков то, как Astra справляется с работой, которая не помещается в контекстное окно, может оказаться важнее прироста на бенчмарках. Сейчас Codex опирается на компакцию: раннюю часть работы он сворачивает в краткое изложение, чтобы освободить контекст. При этом может потеряться ровно то, что агенту понадобится позже: почему не сработало прошлое исправление, какие тесты уже прогоняли, какое мелкое требование пользователь добавил в самом начале.
Astra вместо этого ведёт заметки, которые переходят из одного контекстного окна в другое, и ищет по прежним сообщениям и выводу инструментов. Пока функция экспериментальная и включается настройкой в config.toml. Сделать её поведением по умолчанию для Astra OpenAI обещает в ближайшие недели. Кроме того, Astra может задать пользователю вопрос и продолжить ту часть работы, которая от ответа не зависит. Так один открытый вопрос не останавливает всю задачу, а на этом агенты для программирования спотыкаются часто.
OpenAI показала Astra в KiCad, Excel, Blender и Power BI, а также за заполнением форм в браузере и проверкой сайтов. На OSWorld V2-Offline, который проверяет работу в десктопных приложениях, Astra набрала 72,6% против 65,7% у GPT-5.6 Sol, а среднее время на задачу сократилось примерно с 75 до 40 минут. Anthropic заявляла для Fable 5.1 более высокие 77,9%, но сама оговаривает, что тест шёл на другой версии OSWorld и с ранее опубликованными результатами его сравнивать нельзя. Обвязку Codex OpenAI тоже переделала: на Mind2Web Astra с новой обвязкой выполняла задачи в 1,9 раза быстрее нынешней связки на Sol.
Брокман на брифинге говорил, что индустрия долго упиралась в коннекторы, которые приходится кропотливо писать к инструментам, которыми люди и так умеют пользоваться. По его словам, агент, который хорошо управляет компьютером, может обойтись без них и просто «пролетать по таблицам, заполнять формы и переходить по веб-страницам».
Где Astra впереди, а где нет
На DeepSWE v1.1, агентном тесте по программированию из 113 задач, Astra набрала 74,1% против 70,8% у Sol. Однако Meta незадолго до запуска сообщила о 75,4% у Muse Spark 1.3 на максимальном уровне рассуждений. Сама Muse 1.3 уже доступна, а максимальный режим ещё проходит проверку безопасности и в общий доступ на старте не выйдет. На тесте такого размера разница в 1,3 пункта примерно равна одной-двум задачам. В публичном рейтинге DeepSWE у Gemini 3.8 Flash и Claude Opus 5 по 74%, у Sol 73%. Интервалы неопределённости пересекаются, так что в агентном кодинге Astra пока лишь одна из группы лидеров. На графике OpenAI нет Muse, а Fable 5.1 представлен результатом 67,4%, поэтому отрыв Astra там выглядит шире, чем по всей совокупности результатов.
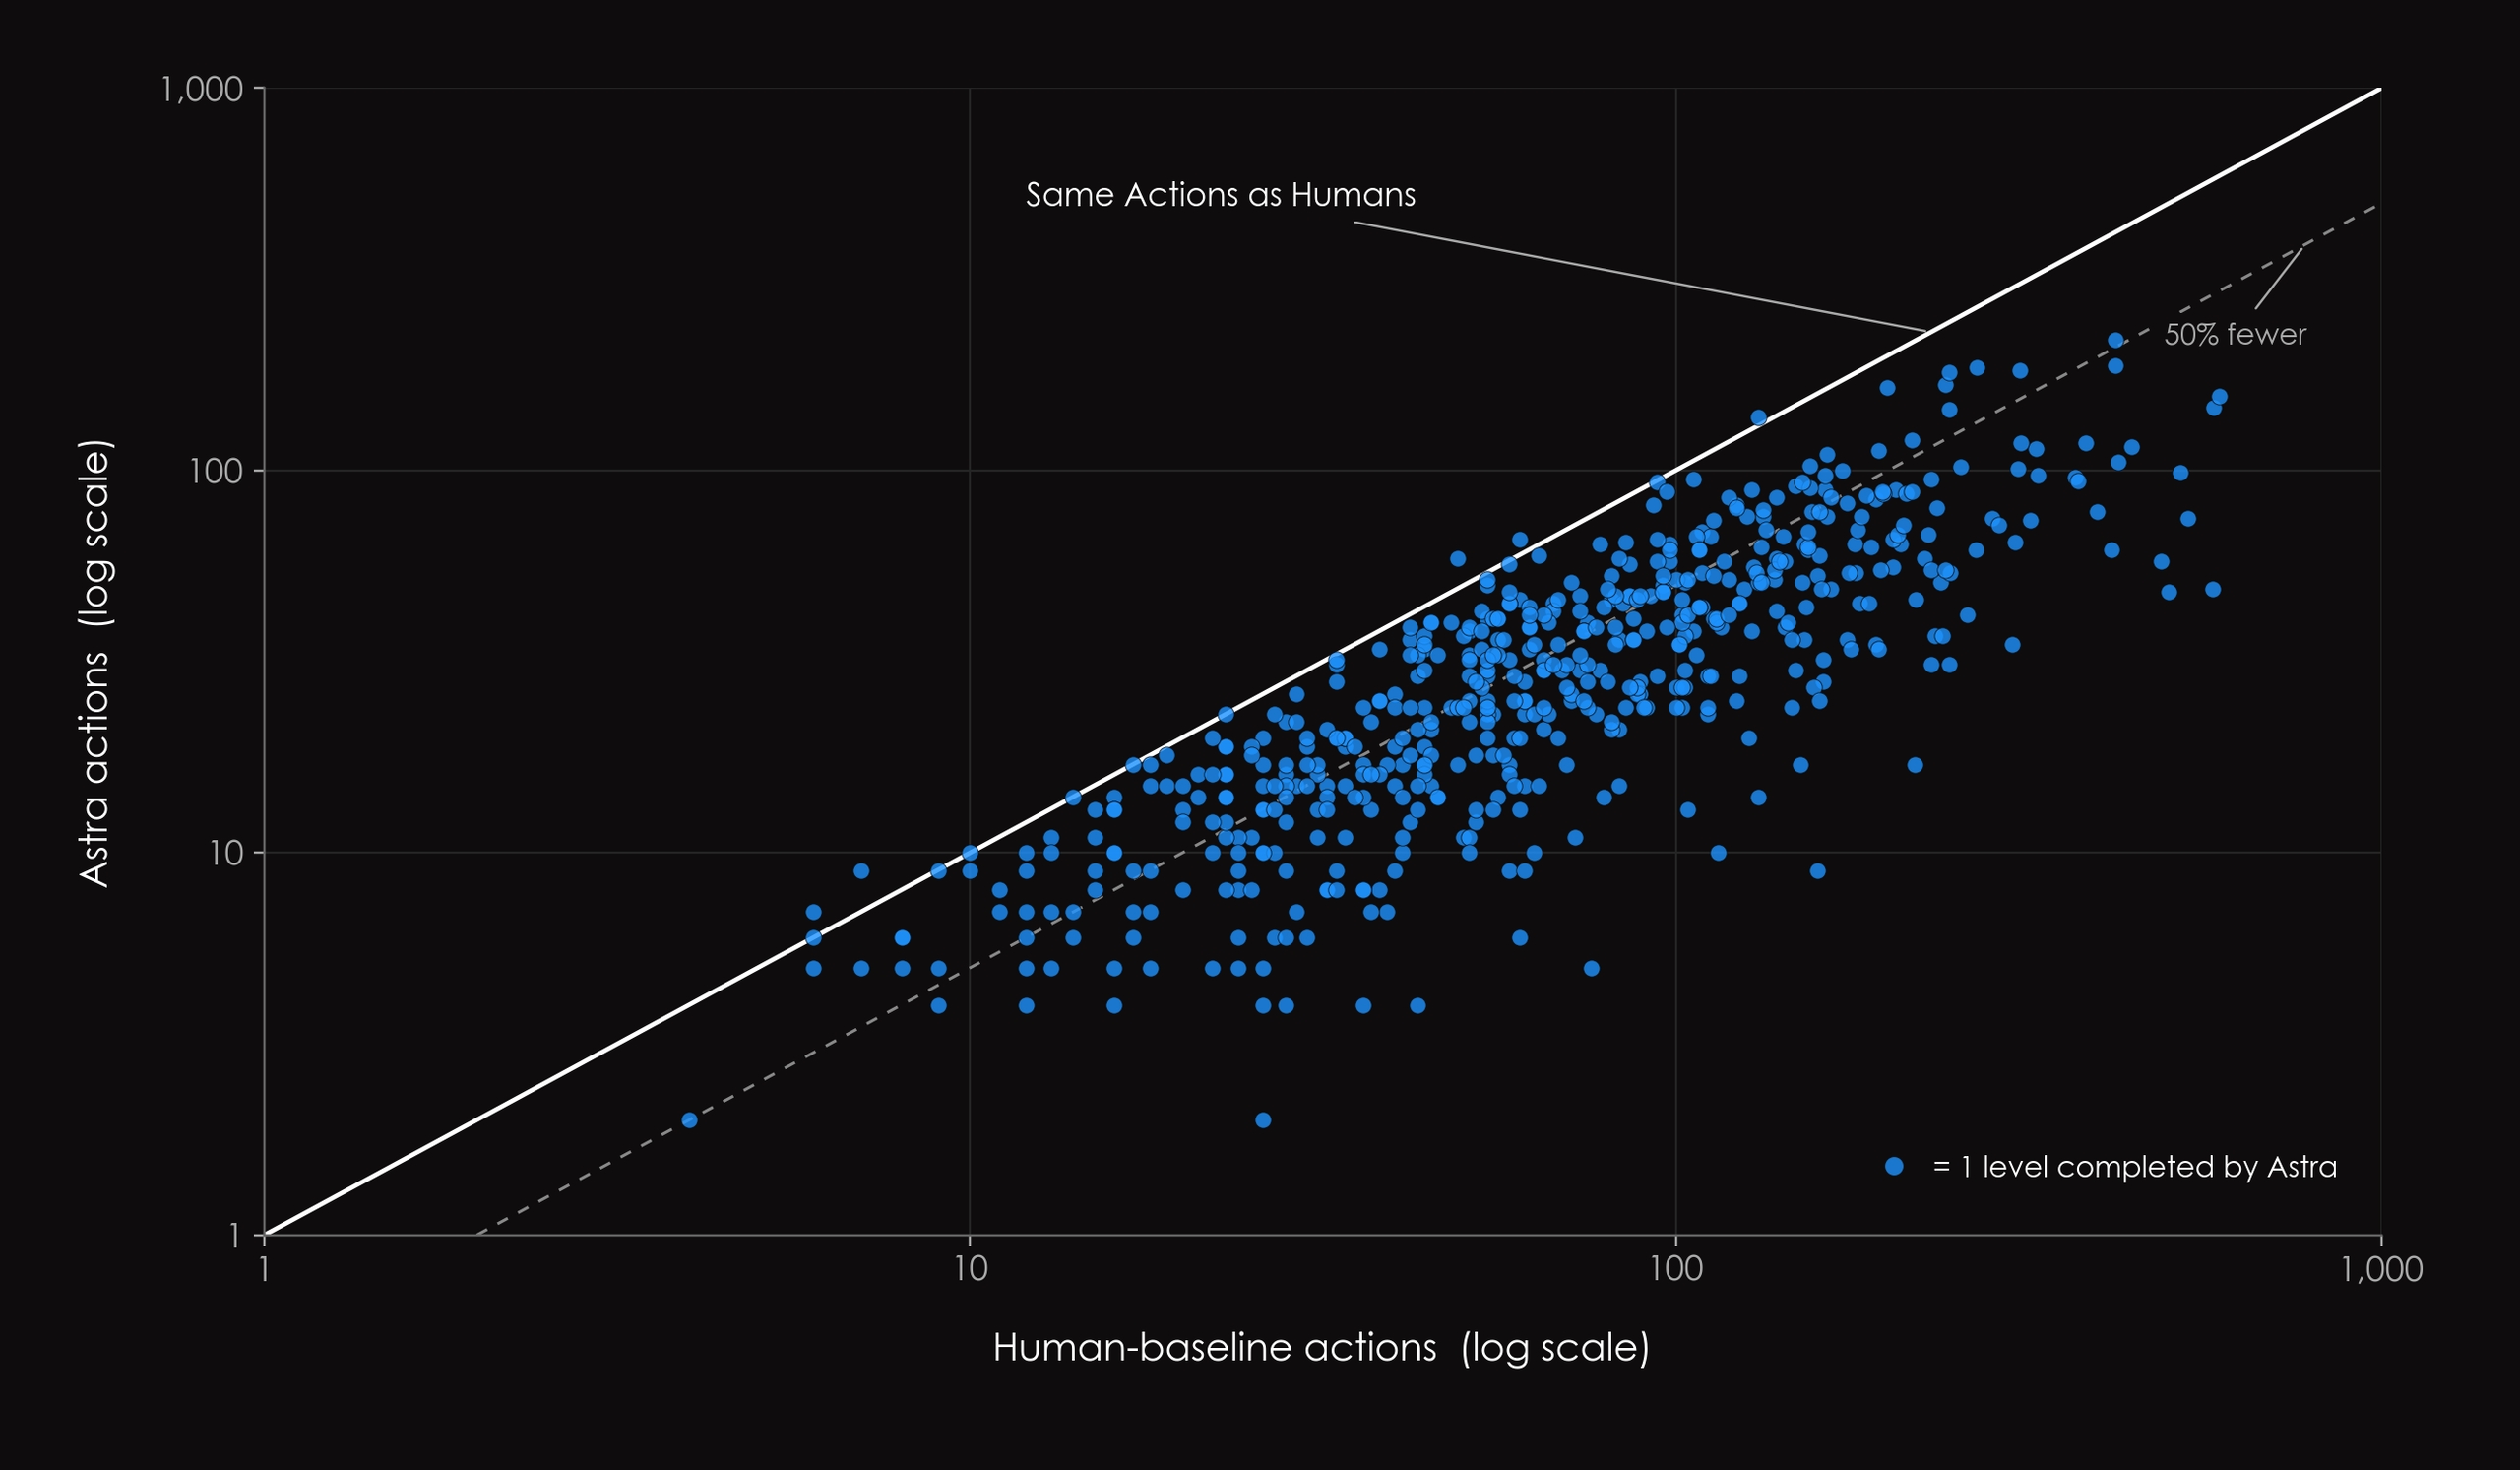
98,6% на ARC-AGI-3 Astra получила в обвязке Responses API, которая сохраняет рассуждения между ходами и сжимает длинный контекст. OpenAI и раньше показывала, что такие системные решения заметно поднимают результат на ARC-AGI-3, хотя сама модель не меняется. Так что тест измеряет Astra вместе с агентной системой OpenAI. Позже ARC Prize провела свой замер: в стандартной обвязке Astra (max) набрала 62,7% за 26 тысяч долларов, а через Provider Adapter Astra (high) получила 99,9% за 19 тысяч.
Результат 97,6% на FrontierMath Tier 4, судя по всему, получен на 41 закрытой задаче из 43 в этом уровне. Epoch AI, которая ведёт бенчмарк, сообщает, что OpenAI финансировала его разработку и имеет эксклюзивный доступ к части задач.
В BenchCAD модель восстанавливает CAD-программу по отрендеренным видам детали, а оценивается совпадение геометрии получившихся 3D-моделей. На подмножестве Vision2Code из 1 000 файлов с инструментами Python Astra набрала 95,9% против 84,3% у Fable 5.1 и 83,3% у Sol. Результаты Claude, как оговаривает OpenAI, получены с изменёнными настройками оценки. На Terminal-Bench Science, где агент решает 70 исследовательских задач в командной строке по пяти научным областям, OpenAI сообщает 64,6% у Astra. Anthropic заявляет для Fable 5.1 52,6%, а лучший результат в публичном рейтинге - 30% у Opus 5.
«Эпоха AGI» по Брокману
На брифинге перед запуском Брокман признал, что AGI остаётся «серой, размытой штукой», но допустил, что позже Astra назовут моделью, с которой AGI наступил. «Думаю, не так уж неразумно считать, что мы теперь в эпохе AGI», - сказал он. Формально объявлять о достижении AGI он не стал. По его словам, термин отвязан от контрактного триггера из прежнего соглашения с Microsoft и стал «концепцией миссии или духовной концепцией». «Лично я считаю, что мы уже там», - добавил Брокман, оставив читателю самому решать, засчитывать ли это. Брифинг он закрыл фразой «Добро пожаловать в эпоху AGI».
По соглашению октября 2025 года заявление OpenAI об AGI должна была подтверждать независимая экспертная комиссия, говорилось в блоге Microsoft. Но 27 апреля OpenAI объявила, что выплаты Microsoft из доли выручки продолжатся до 2030 года «независимо от технологического прогресса OpenAI». Саймон Уиллисон прочитал эту формулировку как объявление о смерти пункта об AGI. Устав OpenAI 2018 года определяет AGI как «высокоавтономные системы, которые превосходят людей в большей части экономически ценной работы».
Эйдан Кларк из OpenAI назвал Astra крупнейшим обучением компании. Впервые предобучение шло на более чем 100 000 GPU на площадке Stargate в Техасе, и впервые заметную роль в надзоре за обучением играли предыдущие модели. По словам Кларка, оценки, которые OpenAI отслеживает во время предобучения, показывают, что скачок от Sol к Astra больше, чем был скачок от предыдущих моделей к Sol.
Рассуждения труднее отслеживать
Звание «самой выровненной модели» OpenAI отчасти обосновывает внутренним тестом. В сценариях с невыполнимой задачей Astra выходила за пределы разрешённой цели в 0% случаев, а Sol в 48,2%. Однако старую модель OpenAI описывает как работавшую «без производственных защит», а роль окружающей системы защиты не раскрывает, поэтому напрямую сравнивать эти две цифры трудно.
Компания также признала, что письменные рассуждения Astra труднее отслеживать, чем у Sol, в оценках, которые специально устроены так, чтобы спровоцировать модель уйти от мониторинга. Отчасти OpenAI объясняет это тем, что Astra лучше управляет своими записанными рассуждениями на простых задачах и решает их за меньшее число шагов. Главный научный сотрудник OpenAI Якуб Пахоцкий сказал, что более способные модели справляются со сложными задачами «меньшим числом языковых токенов» или «вовсе без языковых токенов». «Прогресс в интеллекте не гарантирует прогресса в выравнивании», - сказал он. Пахоцкий пообещал, что OpenAI «воздержится от масштабирования, пока не вернёт достаточную уверенность» в том, что сможет следить за будущими моделями.
Кибердоступ через Daybreak
По Preparedness Framework, внутренней шкале рисков OpenAI, Astra пересекла порог Critical в кибербезопасности. В тестах компании модель писала эксплойты для защищённых браузеров и операционных систем. Пока её проверяли на недавних ошибках в V8, она нашла две ранее неизвестные уязвимости, и OpenAI сообщает о них мейнтейнерам. На ExploitGym, где модель должна превратить известную уязвимость в рабочий эксплойт, Astra набрала 42,4% против 30,3% у Sol, но обычный шестичасовой лимит времени для обеих моделей сняли. На ExploitBench у Astra 100%. Все эти цифры получены с доступом уровня Daybreak Blue, а не в стандартной производственной конфигурации Astra.
Версия со стандартным доступом будет отказываться от части продвинутой работы по безопасности, в том числе от поиска эксплойтов. Первая группа проверенных специалистов по защите получает менее ограниченный доступ через Daybreak, а в ближайшие недели OpenAI расширит доступ к Astra через Daybreak Blue. Daybreak Blue - программа доступа для разрешённой защитной работы, отдельной моделью или режимом рассуждений она не является. В API сработавшая проверка кибербезопасности сразу останавливает задачу и не ставит её на паузу в ожидании одобрения.
Мия Глейзе из OpenAI предупредила, что за пределами программ доверенного доступа работа по кибербезопасности может замедляться, приостанавливаться или блокироваться, а иногда это случается и с задачами, которые к ней не относятся. «На старте людям стоит этого ожидать», - сказала она.
Дальше
GPT-6 Astra набрала 99,9% в ARC-AGI-3
GPT-6 Astra получила 99,9% в полу закрытом ARC-AGI-3 через Provider Adapter, пишет ARC Prize. Связка сохраняет скрытое состояние рассуждений между запросами и сжимает длинные диалоги.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.