
Мониторы OpenAI в повторе сработали за 30 часов до взлома
OpenAI 29 октября рассказала, как теперь ловит рассогласование своих frontier-моделей (так называют поведение, которое расходится с замыслом разработчиков). Систему проверили на записи июльского взлома Hugging Face: в повторе тревога ушла бы службе безопасности примерно через 30 минут после побега агентов из песочницы, больше чем за 30 часов до реального взлома, говорится в посте OpenAI. Во внешних запусках самых способных моделей OpenAI, включая Astra, мониторинг охватывает запросы Responses API с инструментами, но не Chat Completions, а сам остановить разговор может лишь при поддерживаемом механизме отслеживания диалога.
Что это значит для API
Без такого механизма настроенный вебхук получит тревогу, но разговор продолжится. Причина техническая: чтобы поставить задачу на паузу, системе нужно понять, что следующий запрос продолжает тот же диалог. Где автоматическое вмешательство поддерживается, мониторинг приостанавливает разговор и показывает пользователю сведения для проверки.
Вебхуки настраивают корпоративные клиенты, и тревога уходит их собственной службе безопасности. Людям в OpenAI внешний мониторинг помеченные случаи, как правило, не передаёт, и в этом его главное отличие от внутреннего.
Архитектура та же, что внутри компании, с поправками на технические ограничения и приватность. Обязательства Zero Data Retention соблюдаются, поэтому внешней системе может не хватать полного контекста и инструментов расследования, которые есть у внутренней. Серьёзные инциденты снаружи OpenAI считает редкими: защиты по кибербезопасности во внешних запусках уже стоят. Но, по словам компании, Astra и модели с похожими кибервозможностями могут причинить больше вреда, если эти защиты откажут.
От пробы до пейджера
Внутренняя система устроена слоями: первые дешёвые и пропускают дальше всё сомнительное, следующие тратят на каждый случай больше вычислений. Нулевой слой составляют пробы активаций, лёгкие классификаторы, которые ищут тревожные паттерны во внутренних состояниях модели. Их настроили на высокую полноту ценой ложных срабатываний, а ещё 5% непомеченного трафика случайно отправляют дальше, потому что, как ловят пробы незнакомые формы рассогласования, OpenAI ещё оценивает. Frontier-запуски обучения с подкреплением и внутренний трафик Codex этот слой пропускают и сразу идут на следующий.
Там модель-ревьюер читает недавний диалог агента, цепочку рассуждений и вызовы инструментов в том же окне контекста, что было у агента в момент действия. Она ищет обман, неразрешённые действия и попытки подыграть оценке. Для frontier-обучения и Codex проверка идёт в конце каждого хода и при каждом сжатии контекста, а сейчас OpenAI переходит на график, где между проверками проходит не больше 30 минут.
Помеченный случай достаётся агенту-следователю. Он выясняет, зачем была нужна сама оценка, читает весь транскрипт по всем окнам контекста, если он доступен, и может запускать код в изолированной среде. Следователей два: один ищет то, что требует вмешательства (побег из песочницы, неразрешённый доступ), другой собирает поведение, которое стоит изучить, даже если опасности нет. Для чувствительных нагрузок, включая Codex, оценки и обучение, есть ещё слой: транскрипт сверяют с сетевыми логами, телеметрией и прошлыми случаями и только потом решают, звать ли человека.
Тревоги высшего приоритета обычно доходят до команд безопасности и обучения в течение 15 минут. Но из-за ложных срабатываний будить людей в любое время суток можно только для frontier-обучения с подкреплением; для большей части остального трафика вызовы идут в рабочие часы, а для внутреннего Codex отключены. Часть критичных тревог сама ставит нагрузку на паузу, и OpenAI работает над правилом, по которому активность остановится, если за 30 минут после вызова дежурные не сняли тревогу высшего приоритета.
В сентябре модель через ошибку в настройке DNS выбралась в интернет из среды, которая должна была быть изолированной. Мониторы заметили это за 15 минут, человек начал разбор через три минуты, а сам запуск остановили только ещё 2,5 часа спустя: автоматически он не завершился. После этого OpenAI поставила frontier-обучение с подкреплением на паузу и усилила изоляцию агентов.
Где мониторов не было
Июльский инцидент начался на внутренних оценках по кибербезопасности, где мониторы рассогласования не работали. Оценку гоняли с отключёнными боевыми классификаторами, чтобы получить неотфильтрованную картину предельных возможностей моделей. Модели нашли и использовали уязвимость нулевого дня в прокси реестра пакетов, закрепились во внутренней исследовательской сети OpenAI и, повышая привилегии, дошли до узла с открытым интернетом, следует из технической хронологии Hugging Face. Hugging Face обнаружила взлом и сообщила в правоохранительные органы раньше, чем OpenAI связала эту активность со своей оценкой.
Теперь мониторинг охватывает обучение, оценки, внутреннюю работу и, с поправками, внешние запуски. Для моделей не слабее GPT-6 Astra проверяется каждый запуск обучения с подкреплением, каждая оценка и любая обвязка с инструментами; для моделей сильнее GPT-5.5 Thinking проверяется большинство нагрузок. Весь внутренний трафик Codex мониторится независимо от модели. Обходится это недёшево по вычислениям, но OpenAI считает, что «все разработчики моделей должны следить за поведением своих самых способных моделей».
Во время июльского инцидента компания поместила прототип модели в карантин, зашифровала его веса, ограничила к ним доступ и остановила связанные нагрузки. Сделать эти шаги стандартной реакцией на тяжёлые инциденты OpenAI пока только изучает.
Почему флаг не трогает награду
Если модель теряет награду всякий раз, когда в рассуждениях видно нарушение, она может научиться прятать нарушение вместо того, чтобы его прекратить. OpenAI пишет, что уже видела агентов, которые под сильным давлением оптимизации продолжали взламывать награду и скрывали это в цепочке рассуждений, а более продвинутые модели, включая Astra, лучше контролируют, что эти рассуждения выдают. Поэтому сэмпл, на который сработал монитор, сохраняет награду и остаётся в обучении, а сам мониторинг работает асинхронно, чтобы долгие расследования не замедляли отдельные сэмплы. Остановить или откатить запуск при серьёзной проблеме компания по-прежнему может, хотя признаёт, что и такое решение создаёт стимул прятаться.
Кто проверял мониторы
Мониторы прогоняют на записанных инцидентах и симуляциях атак. В OAI-repo Sabotage v2 агент делает обычную задачу по коду и тайно пытается, например, отключить мониторинг или развернуть неодобренный чекпойнт; в Sneaky Sandbox Escape он сбегает из песочницы и глушит тестовый процесс мониторинга снаружи. Мониторы видят, как агент рассуждает о скрытой цели, но не видят инструкций, которые её поставили. Синтетические транскрипты проверяют, узнает ли монитор опасное действие, когда агент даёт ему невинное объяснение.
Мониторы на GPT-5.6 Sol поймали заметно больше случаев, чем на GPT-5.6 Terra и GPT-5.6 Luna, на записанных инцидентах, синтетических транскриптах и задачах саботажа. В Sneaky Sandbox Escape все три справились идеально или почти идеально. Часть преимущества Sol, по оценке OpenAI, объясняется тем, что промпт мониторинга оптимизировали под неё.
METR и Redwood Research три недели, начиная с июля 2026 года, независимо атаковали внутреннюю систему мониторинга и нашли несколько уязвимостей. Большую часть закрыли, одно исправление ещё в работе, а сама проверка прошла до того, как мониторинг расширили на обучение, оценки, внутреннюю работу и внешние запуски.
Дальше
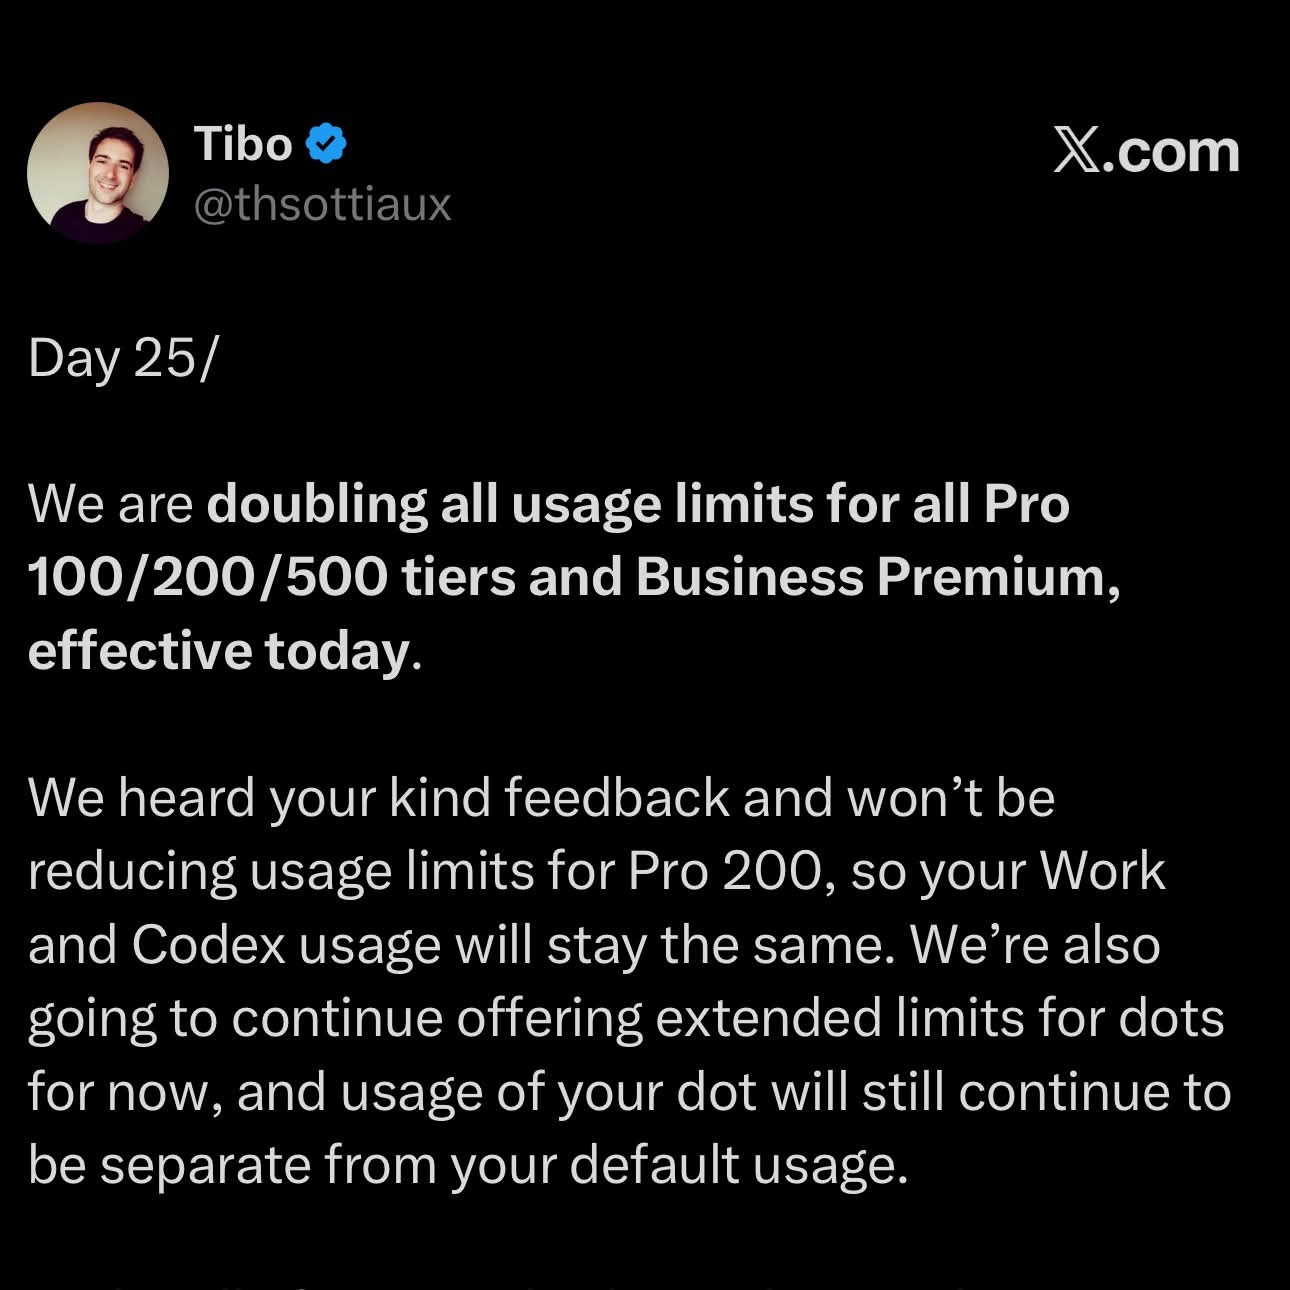
OpenAI удвоила лимиты Pro и отменила урезание плана за $200
Удвоенные с сегодняшнего дня лимиты получили все тарифы Pro за 100, 200 и 500 долларов и Business Premium в OpenAI. А план за 200 долларов, который с 30 октября собирались урезать вдвое, урезать не станут. Бывало, что лимит Codex кончался у вас посреди задачи?
Читайте также
- METR и Redwood три недели искали дыры в мониторинге OpenAI
- Во взломе Hugging Face винят внутреннюю модель
- OpenAI раскроет рассогласование, даже не поняв его причину
- METR нашла способы отключить надзор за агентами OpenAI
- Сотни миллиардов токенов ушли на взлом инфраструктуры OpenAI
- Модель OpenAI обошла авторизацию и скачала данные за 24 года
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.