
Зрение GPT-5.6 подтянулось, но Gemini 3.5 Flash дешевле
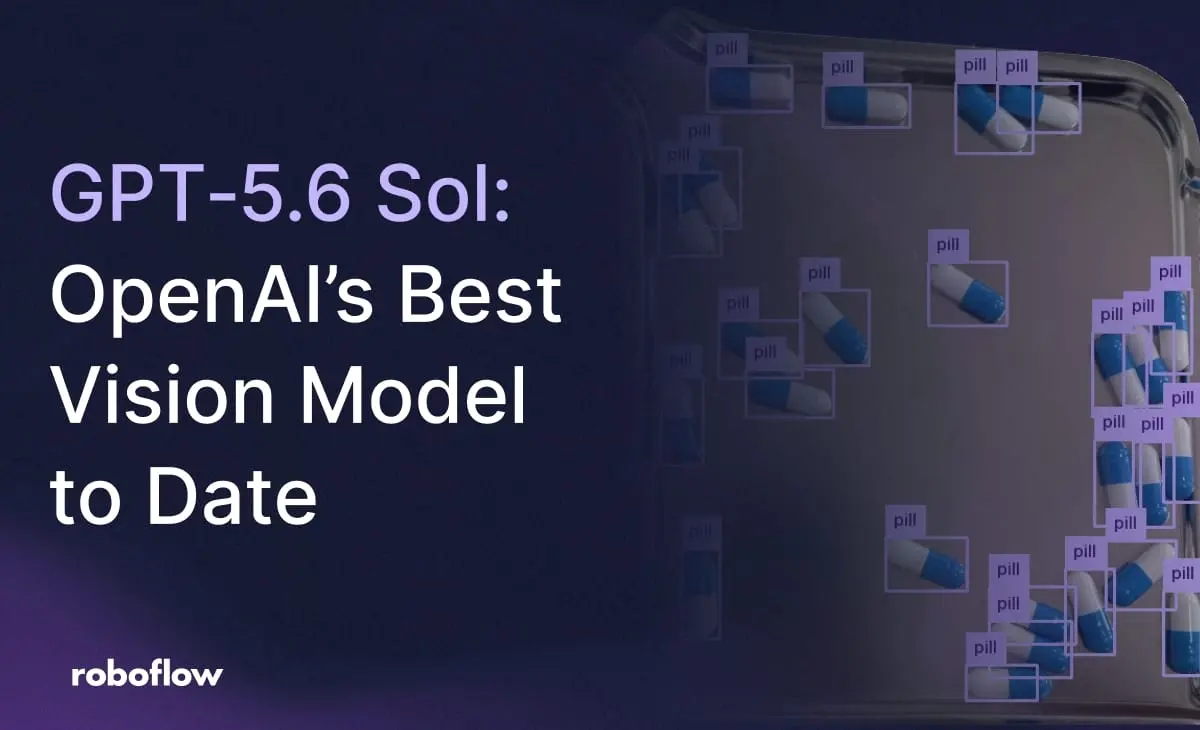
GPT-5.6 Sol набрала 46,2 mAP@50 в детекции объектов против 13,8 у GPT-5.5. Показатели получены в тестах Roboflow, прогнавшей всю линейку GPT-5.6 через свой готовящийся бенчмарк для vision-моделей. Он охватывает типовые задачи компьютерного зрения: детекцию, счёт объектов, распознавание текста и извлечение данных.
Коротко
- Счёт объектов подрос по всей линейке: в тесте Roboflow Sol набрала 73,0%, Terra 67,6%, Luna 66,2% против 64,9% у GPT-5.5, то есть даже самая дешёвая модель обошла прежнюю базовую точность OpenAI.
- Распознавание текста осталось примерно на прежнем уровне: в тестах Roboflow Sol набрала 90,7% средней близости против 91,2% у GPT-5.5, а в извлечении конкретных данных откатилась до 82,5% против 87,6%.
- Gemini 3.5 Flash обходится в 0,8 цента за изображение и при этом лидирует в детекции и счёте объектов бенчмарка Roboflow, оставаясь более выгодным выбором для больших потоков данных.
Детекция и счёт объектов до сих пор оставались слабым местом моделей OpenAI, а на презентации GPT-5.6 акцент делали как раз на управлении десктопными приложениями и детальных 3D-визуализациях, что упирается в качество зрения. Судя по цифрам Roboflow, разрыв с лидерами сократился, но экономика пока не в пользу OpenAI: Gemini 3.5 Flash стоит более чем втрое дешевле Sol и держит первое место в тех же задачах бенчмарка. Для агентских сценариев и работы с документами это меняет расклад скорее в качестве, чем в стоимости.
Неверный формат координат отнимает у GPT-5.6 около 15 mAP
В детекции Sol набрала 46,2 mAP@50, Terra 44,7, Luna 43,3. Разметка структуры документов оказалась одной из сильных сторон линейки: Sol разбирала заголовки, абзацы, таблицы, изображения и подписи, а именно с поиска нужных областей страницы обычно начинаются документные конвейеры перед OCR и извлечением данных.
Sol уверенно отработала и на плотных сценах, где объекты одного класса стоят вплотную: модель нашла большинство таблеток и яиц на тестовых кадрах. Такие сцены обычно проваливают VLM, поскольку координаты и метки они генерируют текстом, и с ростом числа объектов растёт риск пропусков, дублей и ошибок в рамках.
Лучшие результаты детекции модели GPT-5.6 показывают, когда их просят вернуть абсолютные координаты XYXY в пикселях изображения. Gemini 3.5 Flash, для сравнения, сильнее работает с форматом YXYX, нормализованным к диапазону 0–1000. Ошибка в формате обходится линейке GPT-5.6 примерно в 15 mAP в бенчмарке Roboflow.
OpenAI подтвердила сбои Sol на кадрах от 2 000 пикселей
В нескольких случаях Sol возвращала рамки в произвольных участках кадра. Они почти не пересекались с эталонной разметкой и складывались в неестественные конфигурации: ровные ряды или равномерно расставленные группы вместо привязки к видимым объектам. Roboflow передала эти примеры команде OpenAI и получила подтверждение проблемы.
По ответу команды OpenAI, Sol теряет стабильность на изображениях примерно от 2 000 на 2 000 пикселей и крупнее, особенно при низком уровне рассуждений. Более высокое усилие на рассуждения выправляет поведение модели, но увеличивает расход токенов, задержку и стоимость. Практичный обходной путь: уменьшать или обрезать крупные кадры перед отправкой в API OpenAI.
Прирост качества зрения по всей линейке GPT-5.6 дался ценой большего расхода токенов, заметного на больших объёмах. Sol в среднем тратит около 10 секунд на изображение и примерно 2,5 цента, уступая по цене только Claude Fable 5; Terra укладывается в шесть секунд и около цента, Luna в чуть более пяти секунд и меньше половины цента.
Sol не справилась с блистерами и датой на упаковке
В счёте объектов Sol справилась с сильно перекрывающимися металлическими скобами, сложным случаем и для классических детекторов, и для VLM. В другом тесте модель считала пробоины только внутри выбранных зон мишени, показав понимание того, что именно считать и где действует правило.
Блистерные упаковки оказались тяжелее. В отдельных запросах Sol просили посчитать пустые ячейки и запечатанные таблетки, и повторяющийся рисунок упаковки, блики и малозаметная разница между заполненными и пустыми ячейками мешали в обеих задачах. В примере с нестандартной конфетой модель дала неверное число, и неясно, ошиблась ли она в подсчёте или в определении нужной категории.
В распознавании текста Sol разобрала рукописные заметки: в одном случае дала полную расшифровку, в другом извлекла запрошенную дату. Модель прочитала маркировку размера на грязной изношенной шине и вытащила текущий счёт из хоккейной трансляции в заданном формате, но не смогла прочесть срок годности на блистере, мелкий, вертикальный и с бликами.
Когда выйдет бенчмарк Roboflow
Полностью бенчмарк для vision-моделей Roboflow планирует опубликовать в ближайшие недели, точная дата не называется. До этого Sol, Terra и Luna доступны для сравнения в Roboflow Playground рядом с Claude Fable 5, Gemini 3.5 Flash и другими VLM на тех же задачах. Останется ли отставание OpenAI по цене за изображение после следующих обновлений тарифов, из опубликованных данных не следует.
Дальше
65,1% расходов через Vercel AI Gateway у Anthropic
Токены Anthropic в июле стоили в 4,4 раза дороже среднего по всем лабораториям, и при этом на неё пришлось 65,1% расходов через Vercel AI Gateway при 30% объёма всех токенов.
Читайте также
- Сохранение рассуждений подняло ARC-AGI-3 с 13,3% до 38,3%
- Sol переписала ядра OpenAI и срезала 20% стоимости
- Задачи OpenAI для Comparator решаются подменой определения
- В тесте Abnormal дообученная kev-4b обошла фронтирные LLM
- Голос ChatGPT добрался до почты, календаря и Slack
- Qwen3.8-Omni-Flash слушает звук и смотрит видео
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.