
ElevenLabs выпустила голосовые модели под API OpenAI
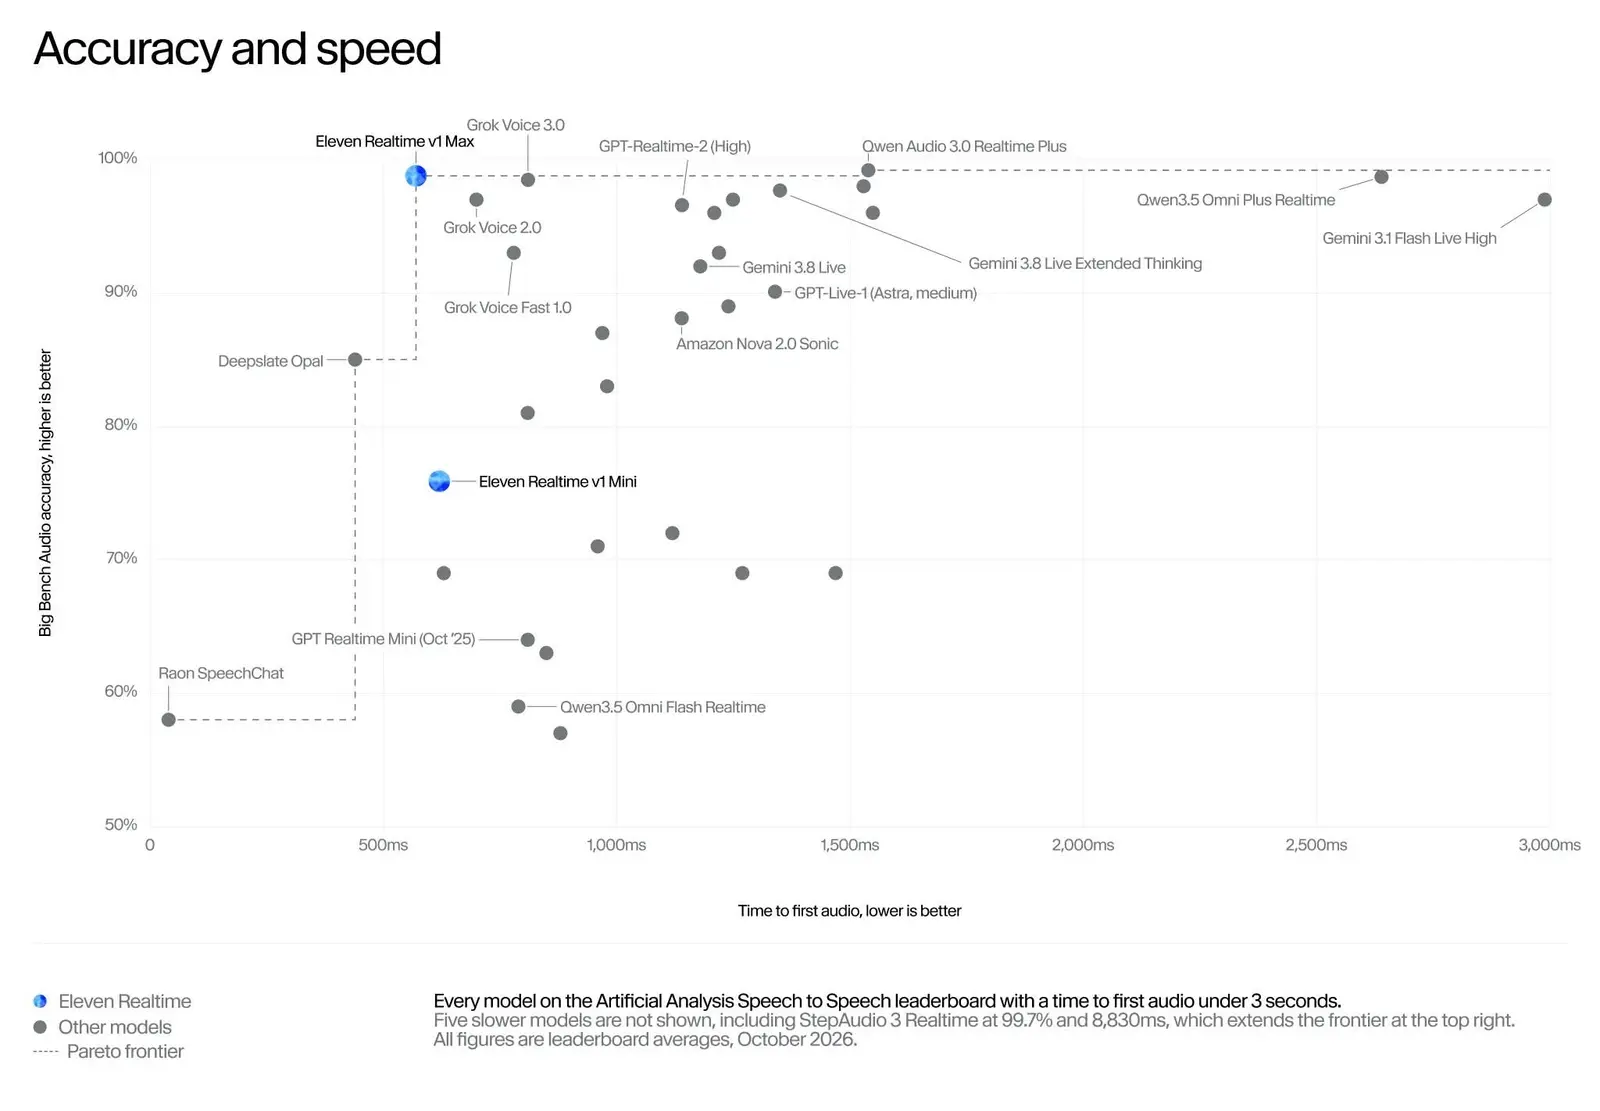
У ElevenLabs появились собственные speech-to-speech модели для голосовых агентов: 21 октября компания открыла Eleven Realtime v1 Mini и v1 Max. Главный аргумент на странице ElevenLabs - совместимость с Realtime API от OpenAI: для переезда хватит всего сменить эндпоинт и имя модели, остальной код остаётся прежним.
Speech-to-speech модель слушает голос и отвечает голосом. Обычно голосового агента собирают из отдельных частей: распознавание речи, языковая модель, синтез, плюс логика очерёдности реплик, которая решает, договорил ли собеседник и пора ли агенту вступать. ElevenLabs утверждает, что в Realtime все четыре части настроены совместно, end-to-end, как одна система.
Моделей две, и делит их компания по типу задач. v1 Mini рассчитана на живой, выразительный разговор: ИИ-ассистенты, репетиторы, интерактивные персонажи. Testing Catalog добавляет, что она дешёвая в работе. v1 Max нужна там, где ответ должен быть точным и продуманным, например в поддержке клиентов и квалификации лидов. Для неё Testing Catalog приводит две цифры: 98,8% на Big Bench Audio, тесте на рассуждение по вопросам, заданным голосом, и 0,57 секунды до начала ответа.
Цену ElevenLabs не назвала, есть только формулировка про низкую стоимость Mini. Для сравнения, xAI в октябре выставила Grok Voice 3.0 за 0,08 доллара в минуту.
Совместимость с OpenAI описана подробно. Все клиентские и серверные события приходят в том же виде, что и от OpenAI, поэтому написанные обработчики, логирование и инструменты продолжают работать. Подключение ElevenLabs предлагает доверить своему skill: его запускают одной командой, и он сам проводит настройку. По обещанию компании, голос в реальном времени появляется в продукте за минуты.
Второй путь - ElevenAgents, платформа агентов, которую компания раньше называла Conversational AI. При переименовании ElevenLabs сообщала, что клиенты создали на ней больше 2 миллионов агентов. Теперь при создании агента достаточно выбрать v1 Mini или v1 Max: транскрипция, очерёдность реплик и голос уже настроены, и с агентом можно сразу разговаривать. Того же агента выкатывают в телефонию, веб-виджет, WhatsApp и платформу контакт-центра без отдельной интеграции под каждый канал. К нему подключают базу знаний, задают ограничения поведения, прогоняют по заранее написанным сценариям и следят за каждым разговором в продакшене. Набор тестов на симуляциях компания обещала ещё при переименовании, а сейчас прогон по сценариям значится среди готовых функций.
Голосов на выбор больше 17 500, они разбиты по назначению: дикторские, разговорные, для соцсетей, персонажей, обучения, рекламы, развлекательного контента и мультиязычные. Разговор в реальном времени поддерживается больше чем на 90 языках с разными акцентами.
Каждый разговор логируется, по журналу можно искать, а для аудита есть отдельный интерфейс. Данные шифруются при передаче и хранении, заявлена поддержка SOC 2, HIPAA и GDPR. Для более жёсткого контроля доступны режимы EU Data Residency и Zero Retention.
Дальше
OpenAI обещает кэш навсегда в Codex и 12 часов в API
Возвращаться к вчерашнему разговору в Codex можно без штрафа за паузу, обещает OpenAI в посте 16-го дня спринта. У залогиненных пользователей Codex и Work кэш хранится «навсегда», а в API ему дали 12 часов. Через сколько часов вы обычно возвращаетесь к брошенной сессии в Codex?
Читайте также
- Mistral выпустила Voxtral 3 и SDK для голосовых агентов
- Голосовой ChatGPT стал реже застревать на «checking...»
- Grok Voice 3.0 обошла GPT-Live-1 и Gemini 3.8 Live
- MAI-Transcribe-2 получил потоковую версию для голосовых агентов
- FLUX 3 Max делает 10-секундное видео примерно за 11 секунд
- Открытой FLUX 3 Image Klein в пике нужно 31 ГБ видеопамяти
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.