
GPT-6 Astra на части аккаунтов похожа на gpt-5.6-luna
Авторы неофициального расследования на Pages, не связанные с OpenAI, 27 сентября показали: с 20 сентября часть аккаунтов ChatGPT получает в Codex под меткой gpt-6-astra ответы, которые на настоящую gpt-6-astra не похожи и по стилю и скорости ближе всего к gpt-5.6-luna. Если ваш Codex с тех пор пишет короче и обрывать его приходится чаще, аккаунт можно проверить их скриптом is_my_astra_fake.py. Но данные собрала одна команда на множестве аккаунтов ChatGPT Pro, и у того, кто работает с одного аккаунта, картина может быть другой.
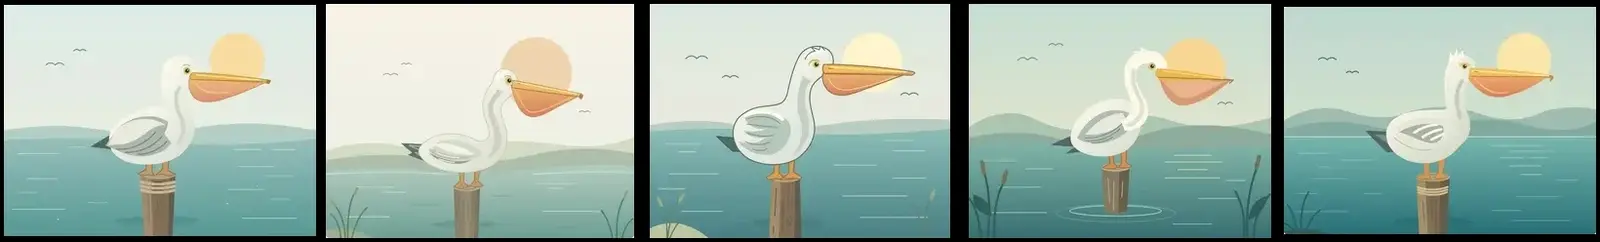
Одну и ту же картинку, пеликана в SVG, авторы заказывали у Codex десятки раз с одинаковыми настройками. Примерно половина рисунков вышла аккуратной, остальные оказались грубыми мультяшными птицами, которых классификатор изображений в основном принимал за уток и чаек. Какой рисунок получится, зависело от аккаунта, а промпт, настройки, версия клиента и время суток этого не объясняли. Сервер при этом в обоих случаях называл модель gpt-6-astra.
Как проверить свой аккаунт
Скрипту нужны залогиненный codex CLI и Python 3.8 или новее, сторонние библиотеки не требуются. Запуск: python3 is_my_astra_fake.py. Через ваш же Codex он отправляет от 3 до 9 коротких запросов к gpt-6-astra, раундами по три параллельных прогона, на это уходит 1-4 минуты и немного квоты. Потом скрипт читает тайминги из локальных логов сессий Codex и сравнивает скорость, с которой стримится текст ответа, с настоящей gpt-6-astra. Засекается только вывод после окончания рассуждений, поэтому медленная сеть, очередь и задержка на старте результат не портят. По словам авторов, скрипт ничего никуда не отправляет, а строка с аккаунтом берётся из локального файла логина и печатается только в терминал.
Настоящая gpt-6-astra в каждом их прогоне выдавала 32,5-33,8 токена в секунду, аномальным считается всё, что выходит за 30,5-36,5. Вердикт YES (код выхода 1) скрипт выносит, когда в одном раунде хотя бы два прогона из трёх заметно быстрее или медленнее нормы. NO (код 0) означает, что все три раунда выглядели нормально, но такой ответ лишь снижает шансы: затронутые аккаунты ведут себя с перерывами, и на одном из них в замерах авторов раунд из трёх прошёл как обычный. UNKNOWN (код 2) выпадает, когда Codex упал или чистых замеров набралось слишком мало. Если что-то кажется не так, авторы советуют перезапустить проверку позже, а делиться предлагают только вердиктом, датой и тем, один ли у вас аккаунт, без почты и логов сессий.
Что показали данные
Сдвиг резкий. До 20 сентября, около 09:00 UTC, затронутых аккаунтов в данных не было, после него ими оказались больше половины использованных (p = 2·10⁻¹²). Нормальная gpt-6-astra упирается примерно в 34 токена в секунду, и за две недели до этой даты быстрее почти ничего не приходило, а с 20 по 23 сентября доля длинных ответов сверх этого предела составляла от 2,8% до 9,7% в день.
Эффект держится на уровне аккаунта и стабилен: первая половина истории аккаунта предсказывает вторую (корреляция 0,79), при этом два аккаунта в один и тот же час могут вести себя по-разному. Страдают и рабочие задачи. В пересчёте на аккаунт ответы затронутых примерно на 25% короче, а пользователь прерывает ход примерно в 20 раз чаще.
На текстовом тесте из 12 вопросов ответы затронутых аккаунтов оказались менее похожи на gpt-6-astra во всех 12. А вот что на её месте именно gpt-5.6-luna, держится лишь на сходстве рисунков, формулировок и скорости, и авторы сами помечают этот вывод как наводящий: luna для сравнения выбрали уже после предварительного просмотра данных (p = 0,016).
Откуда разница
Почему так происходит, со стороны клиента не видно, признают авторы. Данные укладываются в три версии: эксперимент или когорта маршрутизации на уровне аккаунта, политика для отдельных аккаунтов или распределение нагрузки по мощностям.
В справке OpenAI, как её пересказывают сторонние разборы, сказано, что после исчерпания лимита ChatGPT может продолжить на меньшей резервной модели, не меняя подпись в выборе модели. Однако израсходованную квоту авторы среди причин исключили, как и уровень рассуждений, срок с первого использования аккаунта, версию и настройки Codex, промпт и контекст.
В контрольном опыте менялся только аккаунт: при той же машине, промпте и настройках на одном все прогоны были нормальными, на другом большинство аномальными. Авторы оценивают результат как значимый, но с каждой стороны в нём по одному аккаунту, а в живом сравнении бок о бок затронутый аккаунт работал в контейнере, нормальный на хосте.
Дальше
В OpenAI вырастили промпт-инъекцию, которая копирует себя
27 июня атакующая модель OpenAI нашла prompt injection, которая размножается как червь: агент сам вставляет её в ответное письмо. За пределами учебных симуляций, по словам OpenAI, последствий не было.
Читайте также
- Токены рассуждений Luna 6 в Codex зависят от способа входа
- GPT-6 Astra сначала получат клиенты Daybreak
- Fable 5.1 отказалась бить фигуру, но газ на плиту ставила
- OpenAI покупает Pierre, чьи Trees и Diffs уже стоят в Codex
- Новый бэкенд Git в OpenAI ускорил пуши почти в 5 раз
- ChatGPT и Codex с декабря тратят один общий лимит
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.