
Microsoft переводит свои ИИ-сервисы на собственные чипы Maia
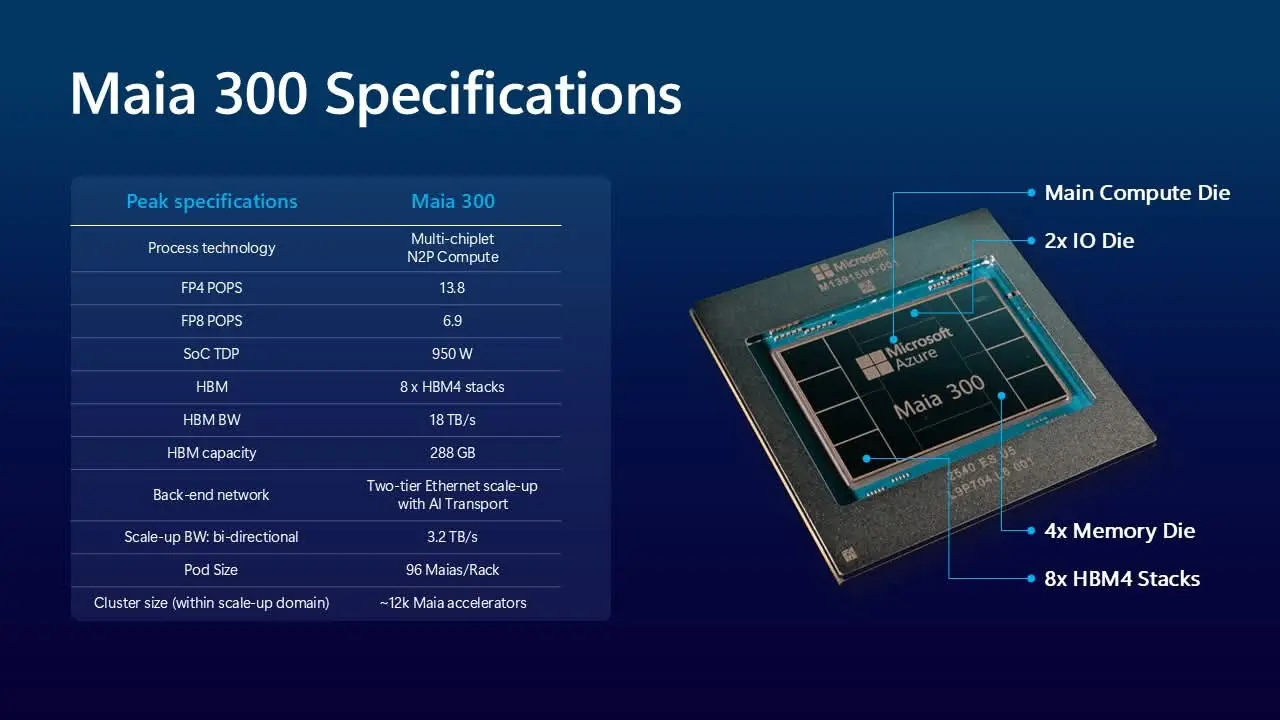
Главным тормозом больших систем инференса Microsoft называет перемещение данных, а не нехватку вычислений, и под эту мысль спроектирована Maia 300, третье поколение собственных ИИ-ускорителей компании. Как сказано в анонсе Microsoft, с 2027 года семейство Maia развернут на мощностях в несколько гигаватт, и оно станет основной системой инференса для продуктов и сервисов компании.
Коротко
- Maia 200 уже работает в продакшене Microsoft: обслуживает Microsoft Copilot и команду MAI, а GitHub Copilot и Microsoft Foundry к ней подключат до конца года.
- Стойка Maia 300 собирает 96 ускорителей в пределах 167 киловатт и, по расчётам Microsoft, даёт до 7 раз больше токенов, чем Maia 200, и на 40% больше токенов на мегаватт, чем ведущие GPU-системы.
- Все сравнения с GPU приводит сама Microsoft: какие именно ускорители взяты за точку отсчёта, в анонсе не сказано, а цифры на 2027 год пока остаются ожиданиями производителя.
Если вы не следили: первую Maia Microsoft показала в ноябре 2023 года, а подробно её архитектуру разобрали на Hot Chips 2024. Maia 100 делали по техпроцессу TSMC N5, у неё было 64 ГБ памяти HBM2E с пропускной способностью 1,8 ТБ/с и расчётная мощность до 700 Вт. Maia 200 анонсировали в январе 2026 года: чип на 3-нм техпроцессе TSMC, заточенный под инференс, с 216 ГБ HBM3e на 7 ТБ/с и TDP 750 Вт.
Maia 200 уже отвечает на запросы Copilot и даёт до 1,7 раза больше токенов на ватт
Maia 200 развёртывают в США, Европе и Австралии. Она уже обслуживает рабочие нагрузки Microsoft, включая Microsoft Copilot, и команду MAI, которая разрабатывает модели следующего поколения. До конца года к ней подключат GitHub Copilot и Microsoft Foundry. На этих чипах работают модели OpenAI, собственные модели MAI и ведущие открытые семейства. В Testing Catalog анонс назвали шагом к полному стеку.
Для встроенных ИИ-функций в Microsoft Teams, Copilot и Cowork Maia 200, по словам компании, выдаёт до 1,7 раза больше токенов на ватт, чем ведущая GPU-инфраструктура. Опыт эксплуатации этого поколения Microsoft напрямую заложила в Maia 300. Вместе два поколения должны обслуживать агентные сценарии GitHub, раздачу моделей в Foundry, инференс и генерацию данных для MAI, а также Dragon Copilot, который снимает с врачей часть административной нагрузки.
Стойка Maia 300 на 96 ускорителей укладывается в 167 киловатт и держит 27,6 ТБ памяти
Maia 300 выйдет в продакшен в 2027 году. Microsoft описывает её как систему с архитектурой «сначала инференс», рассчитанную на длинный контекст, задачи с большим аппетитом к памяти и фазу декодирования, когда модель выдаёт ответ токен за токеном. Целевые сценарии компания называет прямо: рассуждения над длинным контекстом, разговорные интерфейсы, чувствительные к задержке, и долгие многошаговые агентные задачи.
На один ускоритель приходится восемь стеков HBM4 с пиковой пропускной способностью 18,0 ТБ/с при TDP 950 Вт. Вычислительные чиплеты делают по техпроцессу TSMC N2P. Стойка объединяет 96 ускорителей в бюджете 167 киловатт, суммарно 27,6 ТБ HBM и 1,7 ПБ/с совокупной пропускной способности памяти. В полной конфигурации на 96 ускорителей она, по данным Microsoft, выдаёт до 7 раз больше токенов, чем стойка Maia 200.
Почему Maia 300 проектировали вокруг движения данных
Microsoft считает главным узким местом больших систем инференса перемещение данных. Поэтому у Maia 300 программно-определяемая dataflow-архитектура: маршруты данных между вычислениями, памятью и сетью задаёт софт, а ядра оптимизируют с помощью ИИ, чтобы данные лежали ближе к месту обработки. Встроенная в кристалл SRAM работает как управляемый программой черновик и снимает нагрузку с HBM.
Представьте повара, который режет быстро, но за каждой луковицей ходит в кладовую. Точить нож бесполезно, выигрыш даёт стол под рукой: SRAM здесь играет роль стола, HBM роль кладовой, и чем реже приходится туда ходить, тем больше блюд выходит за смену.
Вторая опора в компактных форматах чисел, включая улучшенный MXFP4: они сокращают требования к памяти и пропускной способности и для вычислений, и для хранения KV-кэша, так что в том же энергобюджете помещается более длинный контекст. Чиплеты разносят вычисления, контроллеры памяти и ввод-вывод по отдельным кристаллам. Связь между ускорителями заточена под тензорный параллелизм, а собственный транспорт поверх Ethernet масштабируется от одной стойки до дата-центра.
Все сравнения в анонсе идут против «ведущих GPU» без названия моделей и условий замера, а 40% на мегаватт для Maia 300 пока остаются ожиданием. Как пишет Inside Deep Tech, Maia выигрывает во внутреннем инференсе Azure, но проигрывает, когда нужна переносимость между облаками на арендуемых GPU, а сравнения на страницах Microsoft остаются заявлениями вендора без независимой проверки. Странно, на наш взгляд, что при ставке на чувствительные к задержке диалоги в анонсе нет ни одной цифры задержки.
Что покажут на Ignite 2026
Следующая точка будет уже в следующем месяце: на Microsoft Ignite 2026 в Сан-Франциско и онлайн компания обещает рассказать больше о стратегии и технологиях. Таблиц сравнения с конкретными GPU в анонсе нет, и ждать их логично оттуда. GitHub Copilot и Foundry должны перейти на Maia 200 до конца года, а точная дата первых развёртываний Maia 300 внутри 2027 года пока не называется.
Дальше
Торвальдс правит ядро Linux вместе с Claude Code
Сеанс отладки ядра Linux Линус Торвальдс назвал «адским», а бо́льшую часть черновой работы, по данным Penguin Alley, взял на себя ИИ. Теперь он, как пишет Phoronix, готовит с Claude Code крупное улучшение ядра. Черновую отладку вы доверяете ИИ или пока делаете руками?
Читайте также
- Copilot на Copilot+ PC начнёт считать часть задач локально
- MAI-Transcribe-2 получил потоковую версию для голосовых агентов
- Broadcom одолжит Anthropic до 42 миллиардов на свои же чипы
- Из 518 миллиардов Anthropic отменить нельзя 80%
- Создателей портретного режима iPhone купила OpenAI
- Nvidia купит Hugging Face за 12,9 млрд долларов
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.