
Nvidia дала ИИ-агентам открытый набор для данных компаний
Эмбеддинг-модель Nemotron Retriever подняла релевантность поиска на 65% в тестах Nvidia на открытой связке OpenSearch. Шагов поиска понадобилось меньше, а задержка почти не выросла. С этой цифры Nvidia 21 октября на GTC Berlin начала рассказ про Agent Knowledge Foundation, новый набор открытых компонентов, который должен дать корпоративным ИИ-агентам понимание данных компании, не забирая эти данные у платформ, где они уже лежат.
Набор вошёл в Agent Toolkit, открытый стек для корпоративных агентов, который Nvidia представила 16 марта на GTC. В Agent Knowledge Foundation собраны модели поиска Nemotron Retriever, новая библиотека Auto-Ontology, семейство моделей Kumo для структурированных данных и библиотеки обработки данных CUDA-X. Данные остаются на месте и под теми правилами доступа, которые компании уже настроили, рассказывает The New Stack со слов вице-президента Nvidia по продукту в направлении агентного ИИ Аделя Эль-Халлака.
По словам Эль-Халлака, подключить агента к Snowflake сегодня можно, но общего контекста компании агент от этого не получает. «Хотелось бы, чтобы всё было так просто: подключился к Snowflake, к почте, к базе знаний, и вдруг ИИ волшебным образом понимает все данные. Но в реальности всё иначе», - говорит он. Большие языковые модели «отлично предсказывают следующие токены», но в одной таблице с «целой кучей вкладок» агент нужное найдёт с трудом. «Ему будет тяжело».
Точнее поиск, меньше обращений
Логика Nvidia в поиске такая: точная модель немного медленнее на каждом запросе, зато агенту приходится спрашивать реже. «В мире агентов нужны самые точные модели эмбеддингов или реранкинга», - объясняет Эль-Халлак, даже если каждое обращение из-за этого чуть дольше. Агент тогда получает «гораздо более релевантную информацию. Так что в итоге число обращений, а с ним и общая задержка, на самом деле снижается».
Под этот тезис Nvidia приводит три цифры, и все три от самой Nvidia:
- эмбеддинг-модель Nemotron Retriever: релевантность поиска выше на 65% в тестах на открытой связке OpenSearch, при меньшем числе шагов поиска и почти без добавочной задержки;
- реранкер в версии, которую дообучила SAP: почти в три раза быстрее;
- реранкер у ServiceNow: качество ранжирования выросло, задержка ниже почти на 25%.
С чем сравнивали в случаях SAP и ServiceNow и на каких данных шли замеры, Nvidia не уточняет. Все три результата стоят на одной и той же логике меньшего числа обращений, но измерены они в разных системах и складывать их друг с другом нельзя.
От RAG к онтологиям
«RAG был отличной штукой, но хватает ли его?» - спрашивает Эль-Халлак. Ответ у него такой: графы знаний описывают понятия и связи между ними лучше, чем RAG, который подтягивает куски текста по сходству.
Auto-Ontology строит такие графы из собственных таблиц компании и сопоставляет сырые данные с бизнес-понятиями: клиентами, продуктами, заказами. В каталоге NGC у библиотеки указаны REST API и MCP-сервер, через которые к графу обращаются агенты. Пример Эль-Халлака из телекома: «Нам с вами это понять легко: тариф и план у мобильного оператора - одно и то же». Языковые модели, по его словам, такие вещи «путают».
Библиотека выросла из покупки. В феврале Nvidia приобрела израильский стартап Illumex, который автоматизировал создание семантических слоёв и онтологий для корпоративных данных (семантический слой описывает, какие бизнес-сущности стоят за колонками и таблицами), по сообщениям, за 75 миллионов долларов. Тогда представитель Nvidia говорил изданию Globes, что опыт команды в онтологиях поможет компании строить «библиотеки и модели, которые позволят организациям внедрять агентный ИИ».
Прогнозы по таблицам
Kumo - второй купленный актив в наборе. Этот стартап, который делал фундаментальные модели для реляционных данных, Nvidia купила в июне, The Information оценила сделку более чем в 400 миллионов долларов. С тех пор Nvidia выложила несколько моделей Kumo с открытыми весами на Hugging Face, в том числе Kumo Tabular в сентябре. Вместе с Illumex за команды, из которых выросли два компонента набора, Nvidia отдала, по сообщениям, больше 475 миллионов долларов. Обе суммы взяты из сообщений о сделках, сама Nvidia их не называла.
Эль-Халлак говорит, что модели Kumo заменяют отдельные конвейеры, которые команды данных раньше собирали «под каждую классификацию, под каждый отток, под каждый анализ тональности». Онтология и Kumo при этом работают в паре: «Весь смысл онтологии в том, чтобы, создавая графы знаний, привести данные к единому виду, чтобы между таблицами была согласованность. А дальше с помощью Kumo можно строить предиктивную аналитику».
Партнёры вместо конкуренции
«Я не стремлюсь конкурировать, например, со Snowflake. Наоборот, хочу с ними сотрудничать», - говорит Эль-Халлак. Примеры у Nvidia уже есть. Её собственная команда цепочек поставок работает с Agent Knowledge Foundation через платформу Foundry от Palantir, продолжая прежнюю совместную работу двух компаний. Databricks соединяет модель Kumo для поиска аномалий с Genie Ontology, слоем контекста, который представила в июне. Клиенты Snowflake могут запускать модели Kumo в Snowflake Notebooks.
Разделение ролей Эль-Халлак описывает прямо: «Я не думаю об ACL, доступе к данным и всём таком. Для этого мне и нужны партнёры». ACL, списки контроля доступа, и остальная безопасность данных остаются на стороне платформ.
Как поступила SAP
Не все вендоры идут тем же путём. SAP в июле закрыла покупку Prior Labs, разработчика табличных моделей TabPFN, и пообещала вложить в неё больше 1 миллиарда евро за четыре года. Теперь в SAP AI Core доступна TabPFN-3.5 Plus рядом с собственными моделями SAP серии RPT. Табличные модели у SAP живут внутри её облака, а у Nvidia раздаются наружу.
Раздаёт их Nvidia через Hugging Face. «Мы просто делаем небольшие веса и модели и публикуем их на Hugging Face», - говорит Эль-Халлак о площадке, которую Nvidia в сентябре договорилась купить за 12,9 миллиарда долларов.
Модели и библиотеки Agent Knowledge Foundation делает Nvidia, а данные и права доступа к ним остаются у Snowflake, Databricks и других платформ, где эти данные хранятся.
Дальше
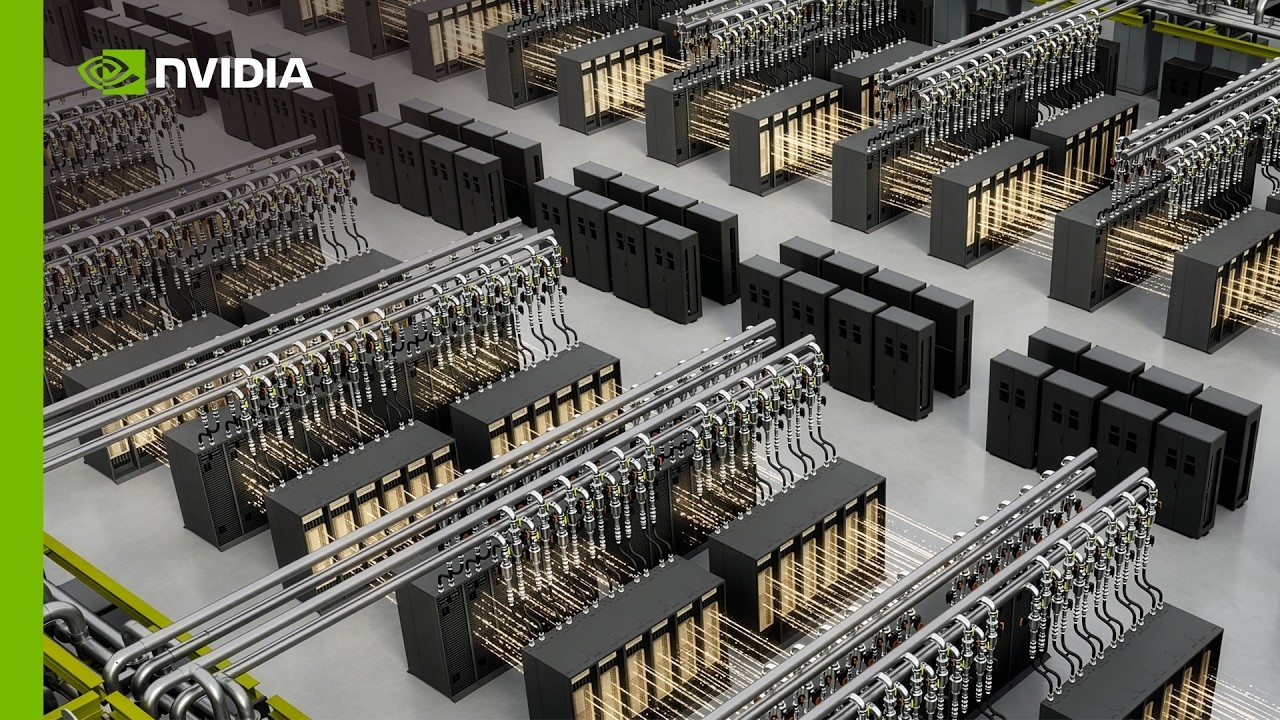
NVIDIA DSX POD обещает запуск ИИ-фабрики за 14 дней
Кабели, трубы охлаждения и тесты ИИ-фабрики NVIDIA переносит на завод: DSX POD на Vera Rubin приезжает в контейнере, и запуск на готовой площадке занимает в лучшем случае 14 дней вместо шести месяцев. Вы бы взяли готовый модуль с завода или собирали бы железо на месте под себя?
Читайте также
- Nvidia запирает ИИ-агентов в песочницу со сторожем на DPU
- Gemini agent от Google гоняет задачи и на моделях Claude
- AWS отдаёт свою модель-решалку вместе с рецептом обучения
- Perplexity пустила агента на Windows, но без стоковой Qwen
- Custom MCP в Gemini Business идут в Public Preview
- Роутер PAIR раздаёт субагентов по домашним компьютерам
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.