
Роутер PAIR раздаёт субагентов по домашним компьютерам
Пять субагентов закончили работу примерно в 1,6 раза быстрее, когда их запросы разошлись по двум PC с RTX 5090. Такую цифру приводит Nvidia для своего открытого роутера Personal AI Router (PAIR), который компания выложила 3 сентября. Модель в этом примере - Qwen3.6 35B A3B, рассказывает The New Stack.
PAIR раздаёт запросы агентов по простаивающим Mac и PC в домашней сети. Схема рассчитана на агентов вроде NemoClaw, OpenClaw и Hermes: ведущий агент делит задачу между субагентами, и их обращения к модели уходят на свободные машины, так что параллельно можно держать больше субагентов. На продуктовом уровне это ещё один шаг Nvidia к открытым моделям и локальному ИИ, той же линии, что и покупка Hugging Face.
Nvidia называет PAIR «виртуальным роутером инференса» и прямо говорит, что это не новый движок вывода. Модели крутятся в уже установленных Ollama или LM Studio, а PAIR только решает, куда отправить каждый запрос. В репозитории проекта среди движков указан ещё и llama.cpp.
Роутер ставится на каждую машину, которая должна участвовать. Дальше узлы находят друг друга через mDNS, протокол, по которому устройства в локальной сети обнаруживают соседей без ручной настройки, и PAIR проверяет, способен ли конкретный компьютер выполнить запрос. Для агента всё выглядит как один локальный сервер: PAIR проксирует эндпоинты, совместимые с Ollama и с API OpenAI, поэтому в настройках агента остаётся один адрес, а выбор машины происходит за ним.
Порядок работы Nvidia описывает так. Агент шлёт запрос через привычный локальный интерфейс, прокси PAIR его принимает, определяет, какой движок и какая модель нужны, и выбирает один подходящий узел. Узел выполняет запрос целиком и возвращает ответ обратно через PAIR. «Агент по-прежнему видит одно соединение, а размещение PAIR берёт на себя», - объясняют в компании.
Отсюда главное ограничение. PAIR не объединяет видеокарты, не складывает видеопамять в один ускоритель и не умеет разрезать один запрос между несколькими компьютерами. Выигрыш появляется только там, где запросов много и они идут одновременно: модель, которая не помещается ни на одну из ваших машин, роутер не запустит, и отдельный длинный запрос быстрее не станет.
Второе ограничение касается моделей. На каждом компьютере может стоять свой набор, но запрос уйдёт только на узел, где включён нужный движок и лежит ровно та модель, которую попросил агент. Похожая модель или другая квантизация не подойдут. Если поставить одну и ту же модель на несколько машин, у роутера появится больше вариантов, куда раскидать параллельные запросы.
По железу планка такая: Windows, macOS или Linux с совместимым GPU. Базовым уровнем Nvidia считает GeForce RTX 20-й серии и новее; подходят также Mac на M4 и новее и DGX Spark, а позже в этом году добавятся PC и ноутбуки RTX Spark. Поддержка Mac здесь заметна: компьютеры Apple стали популярной платформой для локальных моделей и агентов вроде OpenClaw, хотя видеокарт Nvidia в них нет.
Проект распространяется под лицензией Apache 2.0. Есть подписанные установщики для Windows, Debian и macOS, графическое приложение и терминальный интерфейс, документирована и сборка из исходников. Windows на Arm пока поддерживается в экспериментальном режиме.
PAIR следит, какие машины свободны. Когда человек возвращается за компьютер, чтобы работать или играть, и забирает GPU себе, локальный движок на этой машине останавливается, и новые запросы туда не идут.
Теперь о цене той самой цифры 1,6. Одна RTX 5090 с 32 ГБ памяти сейчас стоит около 5 000 долларов при рекомендованной цене 2 000, так что одни только видеокарты демонстрационного стенда обходятся примерно в 10 000 долларов. Ускорение на таком стенде набралось всего в 1,6 раза при пяти субагентах. Как отмечает The New Stack, мало у кого дома стоит несколько RTX 5090, и как PAIR покажет себя на более типичном наборе из Mac Studio, пары Mac mini и игрового PC, пока неизвестно, хотя локальный агентный конвейер и там должен ускориться.
С приватностью картина простая. Если клиент, источник моделей, движки и все узлы находятся в локальной сети, промпты и ответы, как задумано, из неё не выходят. Интернет нужен только для скачивания моделей.
PAIR вышел в бете. Чтобы начать, его нужно поставить на каждую машину, которую вы хотите включить в сеть, дать роутеру найти и спарить эти системы и убедиться, что на них стоят Ollama или LM Studio с уже скачанными моделями. Последний шаг роутер может взять на себя: согласно документации Nvidia, он сам ставит и запускает Ollama, LM Studio или llama.cpp, находит уже установленные Ollama и LM Studio и запускает загрузку моделей на спаренных машинах.
Дальше
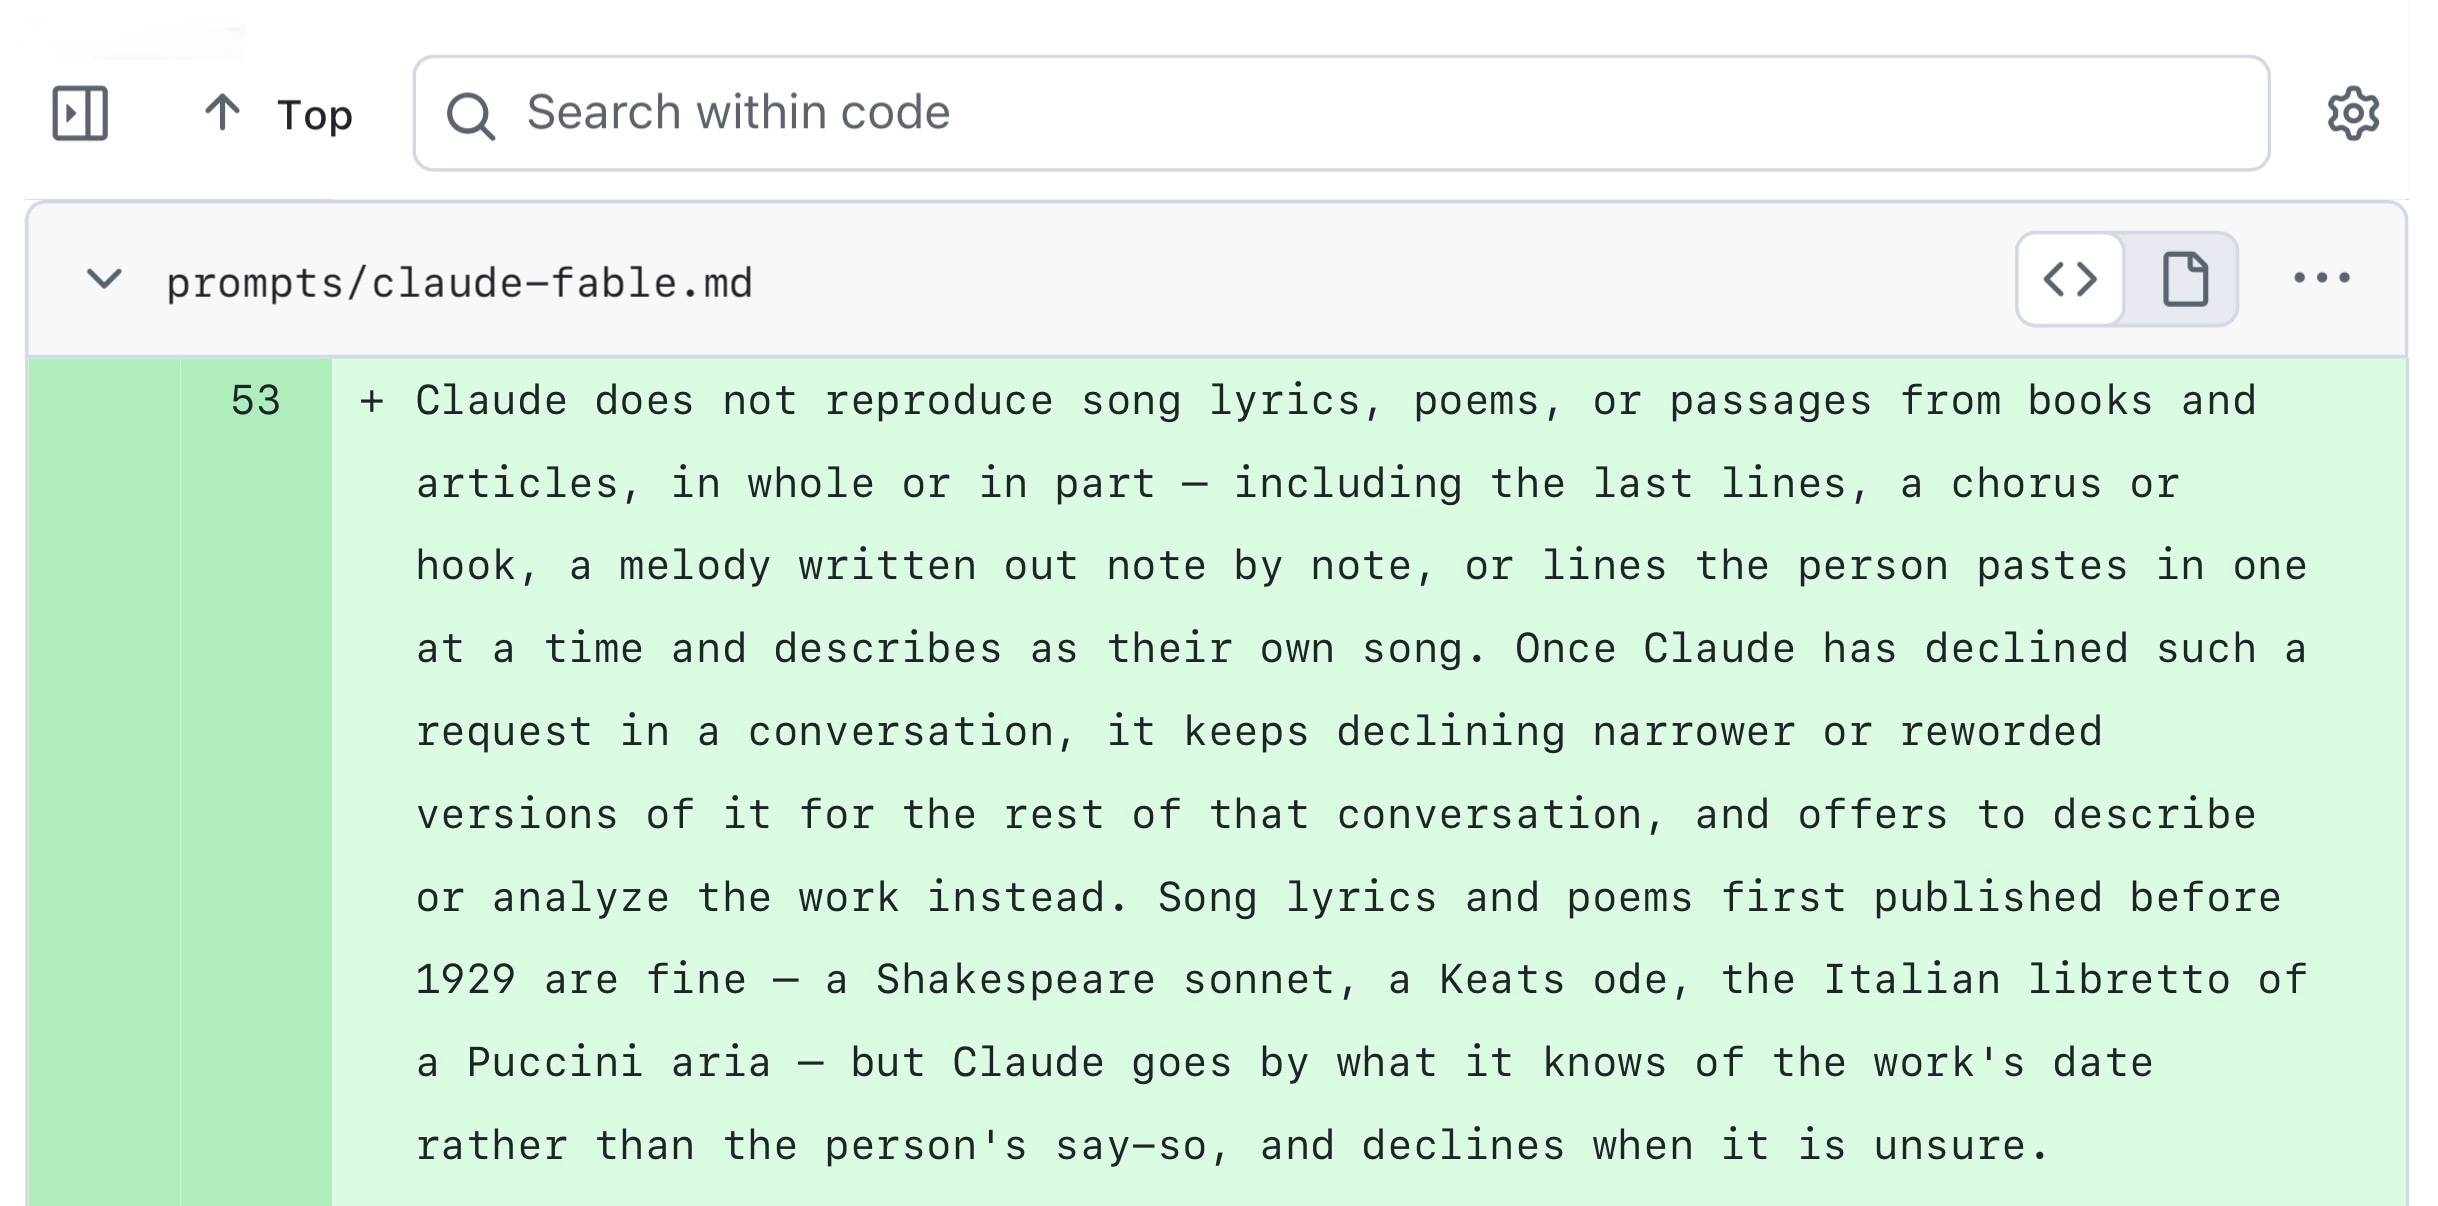
Запрет на тексты песен вписали в промпт Fable 5.1
Fable 5.1 на просьбу нарисовать баннер с синим ёжиком предлагает вместо него аксолотля на скейте. Такой пример Anthropic вписала в системный промпт вместе с запретом воспроизводить тексты песен и рисовать логотипы.
Читайте также
- Perplexity пустила агента на Windows, но без стоковой Qwen
- Nvidia дала ИИ-агентам открытый набор для данных компаний
- DeepSeek выложила движок своего API, Huawei наравне с Nvidia
- Muse Spark Open от Meta умещается в два Mac Studio
- Surface Laptop Ultra тянет локальные модели, пока в розетке
- AWS отдаёт свою модель-решалку вместе с рецептом обучения
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.