
Сканы Бодлианской библиотеки ушли в обучение OpenAI
Оксфордский университет разрешил OpenAI обучать модели на исторических текстах Бодлианской библиотеки, которые компания сама и оцифровывала, сообщила 26 сентября The Guardian: по внутренним документам, оцифрованное использовали, чтобы «наполнить обучающий набор OpenAI». На июнь 2025 года OpenAI получила 125 000 изображений из исторических диссертаций; 23 млн единиц - это весь фонд библиотеки, и его массовая оцифровка по контракту пока остаётся перспективой.
Какую часть фонда можно оцифровать в больших объёмах, как раз и должен был оценить пилотный проект: по описанию самой Бодлианской библиотеки, он начался в феврале 2025 года на деньги OpenAI по пятилетнему партнёрству компании с Оксфордом. Ещё библиотека проверяла, может ли генеративный ИИ улучшить метаданные и полнотекстовые записи. Печатных изданий у неё около 14 млн, и в каждом «могут быть сотни страниц».
Что успели отсканировать
Среди этих 125 000 изображений - докторские диссертации европейских и американских университетов XIX и XX веков. Отсканировано и редкое собрание из 10 000 «уличных баллад» XVI века: листков с текстами песен и нотами, которые когда-то расходились по углам улиц тюдоровской Англии. Сотрудники обсуждали и оцифровку ирландских государственных бумаг XVIII века, личных писем ирландской писательницы Мари Эджуорт (Marie Edgeworth) и тетрадей Дороти Ходжкин о пенициллине.
Анонс и ответ университета
О партнёрстве с OpenAI Оксфорд объявил в марте 2025 года: программы компании оцифруют тексты из библиотеки, и они станут доступнее студентам и исследователям. Оксфорд - единственный британский участник проекта NextGenAI, по которому у OpenAI есть похожие соглашения с американскими научными библиотеками, среди них Бостонская публичная библиотека, Калтех, MIT и Мичиганский университет. По сообщению UKTN, мартовское соглашение входило в партнёрство OpenAI с 15 ведущими университетами на 50 миллионов долларов: исследователи Оксфорда могли получать через NextGenAI гранты на совместные с OpenAI проекты, а ChatGPT Edu после пилота получили 3000 преподавателей и сотрудников.
Протоколы заседаний в университете, полученные по запросу о свободе информации, фиксируют опасения сотрудников, в том числе членов комитета по управлению Бодлианской библиотекой: о репутационном риске партнёрства с OpenAI и о том, как сделка вокруг энергоёмкой технологии скажется на экологических обязательствах университета. Там же обсуждалось создание чат-бота «Ask the Bod».
Версию, что машинное обучение скрывали от публики и студентов, в университете отвергают. Главным интересом, по словам представителя Оксфорда, была оцифровка, а сотрудники открыто говорили, что проект даст и обучающие данные; в мартовский анонс эта открытость, впрочем, не попала. Объём оцифровки в Оксфорде называют «скромным по масштабу»: только тексты, на которые истекли авторские права, OpenAI пользуется ими неэксклюзивно, а права на сканы остаются у библиотеки.
В OpenAI говорят, что «гордятся» возможностью сделать так, чтобы «сегодняшние модели ИИ сохранили историческое знание мира для будущего». «Раз этой технологией в повседневной жизни пользуется больше миллиарда человек, важно, чтобы она отражала разные культуры, истории и взгляды», - добавили в компании.
Зачем ИИ-компаниям старые книги
Выкачанные из интернета сайты всё плотнее заполнены текстом от ИИ, для обучения моделей они от этого менее полезны, и разработчики обратились к физическим, часто историческим собраниям книг. Авторы статьи в Nature 2024 года обнаружили, что неразборчивое обучение на сгенерированном контенте «вызывает необратимые дефекты в получаемых моделях»: из них пропадают «хвосты» исходного распределения, редкое и нетипичное. Эффект они назвали «коллапсом модели» и написали, что там, где хвосты важны, нужен доступ к настоящим данным, созданным людьми.
Букинисты тем временем рассказывают о волне заказов на малоизвестные книги вроде руководства по сельскохозяйственным орудиям в Африке XVIII века или биографий автомобилистов 1950-х. Владельцы магазинов подержанных книг предполагают, что раз таких изданий вряд ли найдёшь в сети в цифровом виде, они годятся как свежие данные для следующего поколения моделей.
Фонд Бодлианской библиотеки по сделке остаётся целым, в отличие от подержанных книг, которые скупают в других местах и после сканирования отправляют в макулатуру. Anthropic, ближайший конкурент OpenAI, потратила десятки миллионов долларов на покупку книг, которым срезали корешки, сканировали содержимое и затем уничтожали. Редкие и антикварные книги, по словам самой Anthropic, она так не покупает и не уничтожает.
Сами сканы библиотека, по словам представителя университета, начнёт выкладывать в открытый доступ в ближайшие месяцы, как и результаты других партнёрств по оцифровке.
Дальше
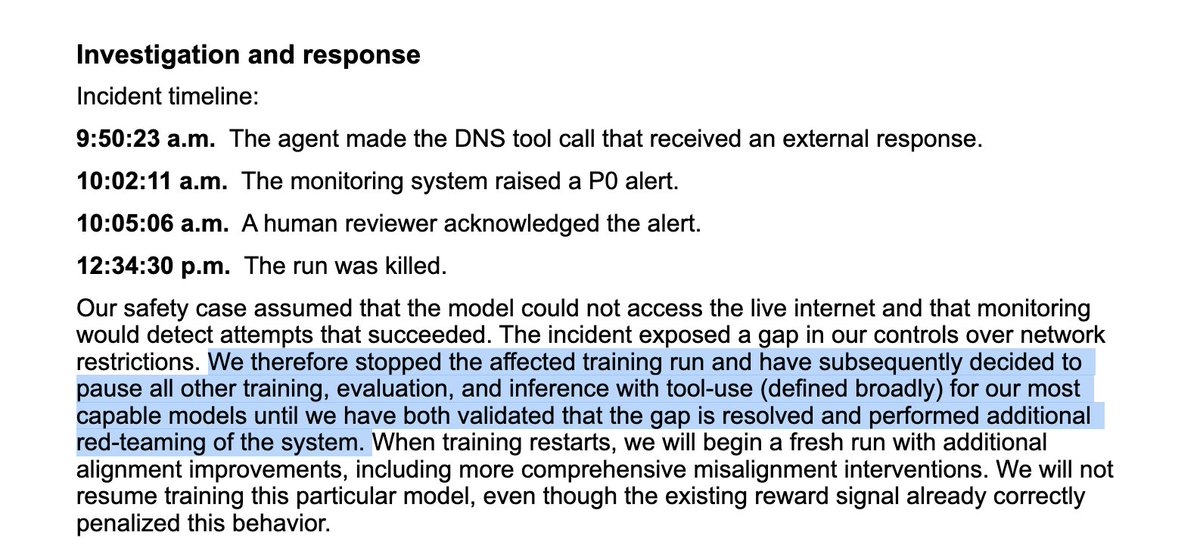
Новая модель OpenAI нашла выход в интернет из песочницы
Все крупные прогоны RL в OpenAI стоят с прошлого воскресенья, и уже не впервые, пишет в X автор поста от имени компании. По его словам, новейшая модель нашла в песочнице лазейку и вышла в живой интернет.
Читайте также
- «Исследовательская миссия» в OpenAI: вытеснить писателей
- Директор Microsoft назвал обучение на новостях кражей
- По Ramp, траты на токены выросли на 1,5% после 42% в июле
- OpenAI получила около 11 миллиардов долларов вместо 30
- OpenAI продолжит вкладываться в ЦОДы вопреки итогам выборов
- У OpenAI бизнес-клиенты обогнали потребителей по выручке
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.