
Модель выбора SubQ Snap берёт 384K токенов вместо 32K
Агент обращается к модели выбора почти на каждом ходу: какой файл открыть, какой инструмент вызвать, прошёл ли тест. В блоге Subquadratic представлена SubQ Snap. Она принимает такие решения, читая за один вызов до 384K токенов текста и изображений. Это в 12 раз больше окна в 32K у Jev от TypeSafe.
Коротко
- Subquadratic, автор разреженной модели SubQ, выпустила в публичное превью SubQ Snap: модель для ограниченных решений внутри агентов, которая стоит 0,05 доллара за миллион входных токенов и не берёт денег за выход.
- Длинный вход читает разреженное внимание SSA, а ответ выдаёт отдельная голова решений; по данным компании, 100K токенов обрабатываются примерно за секунду, а на 16 корпоративных тестах Snap набирает 67,6 против 61,6.
- Все цифры Subquadratic получила сама, сторонних проверок нет, окно 384K остаётся временным потолком превью из-за нехватки мощностей, а в трёх задачах из шестнадцати Snap уступает Jev.
Subquadratic вышла из тени 5 мая 2026 года с посевными 29 миллионами долларов и первой моделью SubQ; в компании 13 человек. SubQ построена на Subquadratic Sparse Attention (SSA), и, по словам компании, после всех обновлений держится на уровне передовых моделей. Модели выбора стали модной темой после того, как TypeSafe в середине сентября показала Jev. Как пишет The New Stack, вслед за ней свои варианты выпустили OpenAI, Perplexity, Cloudflare, Amazon и Microsoft.
Snap опережает Jev в 13 из 16 корпоративных тестов
Главная таблица Subquadratic собрана из 16 бенчмарков Decision Index, близких к корпоративной работе: маршрутизация обращений в поддержку, безопасность, юридические и финансовые задачи, проверка документов, код и вызов инструментов. В среднем у Snap 67,6 против 61,6 у Jev (в самой таблице 67,54). Самый большой отрыв в распознавании фишинга PhishNChips: 47,1 против 25,1, то есть плюс 22,0 пункта. Следом идут CRUXEval, где нужно предсказать вывод кода (73,8 против 57,1), и поиск галлюцинаций RAG на RAGTruth (64,8 против 51,3).
Проигрыши в таблице тоже есть: When2Call (67,0 против 74,6), API-Bank, где выбирают следующий вызов API (86,4 против 88,0), и разбор отзывов ACOS (26,7 против 27,3). На публичном наборе Decision Index 0.2.1, где все запросы короче 34K токенов, у Snap 61,7 против 57,9. Она впереди в четырёх из пяти подобластей, сильнее всего в «искусстве и вкусе» (+12,11) и понимании языка (+7,46). На Nimble Suite 13 от Bespoke Labs счёт 82,9% против 76,0%.
На Decision LCR Snap обходит Jev, читавшую документы частями, на 26 пунктов
Длинный контекст компания проверяет двумя тестами. Decision LCR оценивает рассуждение, когда сведения надо собрать из разных частей документа. На входах длиной 72K–115K токенов Snap читает всё за один проход и набирает 74,0, а Jev, которой материал подавали кусками, получает 48,0. Snap принимает текст и картинки в одном контексте, так что рядом с логами могут лежать скриншоты, графики, схемы и сканы страниц.
Decision RULER проверяет поиск по 11 типам задач. На 32K у Snap 99,8 против 94,1 у Jev, а дальше сравнивать не с чем. На 64K, 128K и 256K у Snap 99,8, 99,5 и 99,8, у Jev результатов для этих длин в таблице нет. В сводке компания называет и 96,3 на Decision RULER при миллионе токенов. Запрос на 100K токенов, по данным Subquadratic, обрабатывается примерно за секунду.
Subquadratic хочет, чтобы модель выбора забирала работу у больших LLM
Сейчас модели выбора в основном работают вокруг LLM: оценивают её ответы или решают, какой модели отдать задачу. Как пишет The New Stack, Workday с помощью Jev собирает интерфейс ассистента Sana на лету и подбирает под вопрос сотрудника готовые компоненты вроде карточки зарплаты или выбора даты. Subquadratic замахивается шире. Компания хочет отдать модели выбора решения, которые сейчас принимает LLM, а в отдельных случаях и целые крупные задачи.
В переписке с The New Stack сооснователь Subquadratic Алекс Уидон признал, что Snap делали, вдохновляясь Jev. По его словам, модели выбора хорошо совпадают с тезисом компании и в части задач вовсе избавляют от декодирования. Он же говорит о «вакууме видения» в этой нише. Пример из блога: агент для кода отдаёт Snap выбор инструмента и проверку результата, а большую генеративную модель вызывает только для написания кода и долгих рассуждений.
Почему модели выбора застряли на 32K токенов
Модель выбора получает контекст, вопрос и список допустимых ответов и выдаёт вероятность для каждого варианта, а не пишет текст. Subquadratic называет такое сужение специализацией. Как на экзамене с вариантами ответа: поставить галочку быстрее, чем писать сочинение, но условие задачи всё равно надо прочитать целиком.
Ресурсы как раз и уходят на чтение. По словам компании, почти все вычисления модели выбора приходятся на prefill, то есть на обработку входа. При плотном внимании стоимость растёт квадратично: контекст вдвое длиннее, работы вчетверо больше. Поэтому нынешние модели выбора держатся на 32K и решают, не видя большей части нужного.
Обходные пути сокращают вход ещё до модели: поиск через RAG, нарезка на куски, обрезка, пересказ. Компания перечисляет, чем это оборачивается. Обрезка теряет ограничение, которое пользователь задал 40 ходов назад, поиск может пропустить нужное, пересказ выбрасывает детали, которые потом окажутся важными. Каждый лишний шаг к тому же добавляет задержку и усложняет систему.
SSA читает выборочно, голова решений отвечает без генерации
Snap режет обе статьи расходов. Чтение берёт на себя SSA: модель не сравнивает каждый токен с каждым, она учится понимать, какие позиции важны, и считает внимание только по ним. Отбор идёт по содержимому, без фиксированных позиционных шаблонов и скользящего окна. Как утверждает компания, сам этап отбора не возвращает квадратичный рост, и стоимость внимания растёт линейно.
Так юрист читает договор: он не сверяет каждый пункт с каждым, а сразу ищет оговорки, которые касаются вопроса. Ответ выдаёт голова решений, которая переводит внутренние представления прямо в распределение вероятностей по допустимым ответам. Snap рассчитана на четыре роли в цикле агента: маршрутизацию, выбор инструмента, проверку и остановку. У конкурентов другое устройство: Laya соединяет двунаправленный энкодер с головой решений, а Decider v1.1 от Perplexity переделывает готовую языковую модель под некаузальное внимание.
Все цифры взяты из блога Subquadratic, а прошлый запуск учит осторожности: в мае каждую модель в сравнении с SubQ прогоняли по одному разу, а результат SubQ на RULER 128K разные источники приводили как 95%, 95,6% или 97,1%. Неясно и то, откуда взялся результат Decision RULER на миллионе токенов, если окно Snap 384K. На наш взгляд, сильнее всего настораживает проигрыш на When2Call (67,0 против 74,6): тест проверяет, вызвать ли инструмент, переспросить, ответить или отказаться, а это и есть заявленные роли Snap.
Когда Snap выйдет за 384K
Окно 384K компания называет временным потолком превью, который упирается в нехватку мощностей, но срок расширения не называет. Неизвестно и то, останется ли после превью цена в 0,05 доллара за миллион входных токенов с бесплатным выходом. Отдельно стоит дождаться сторонних замеров на Decision Index и Decision LCR, потому что пока все результаты опубликовала сама Subquadratic.
Дальше
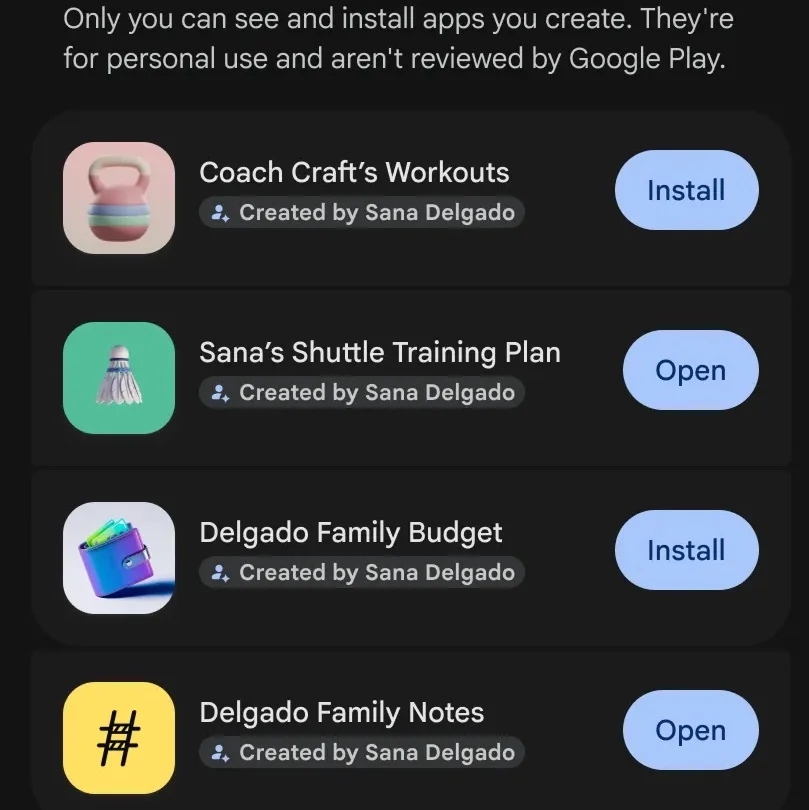
Google Play пускает самоделки из AI Studio на ваш телефон
Google Play убрал входной билет для самодельных приложений: то, что навайбкодили в Google AI Studio, запускается на вашем телефоне без аккаунта разработчика. В общий каталог оно при этом не попадает. Вам случалось собирать себе приложение, потому что нужного не нашлось в магазине?
Читайте также
- У Microsoft-Decision-1 выходные токены бесплатные
- AWS отдаёт свою модель-решалку вместе с рецептом обучения
- Jev от TypeSafe AI не берёт денег за выходные токены
- У LFM2.5 от Liquid AI из 24B параметров работают 2B
- Gemini 4 Argon на Arena: пятое место, позади Opus 5.5
- Mistral Large 4 обошла GLM-5.3 на DeepSWE, пишет VentureBeat
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.