
Opus 5.5 обошёл GPT-6 Astra в тесте на стабильность
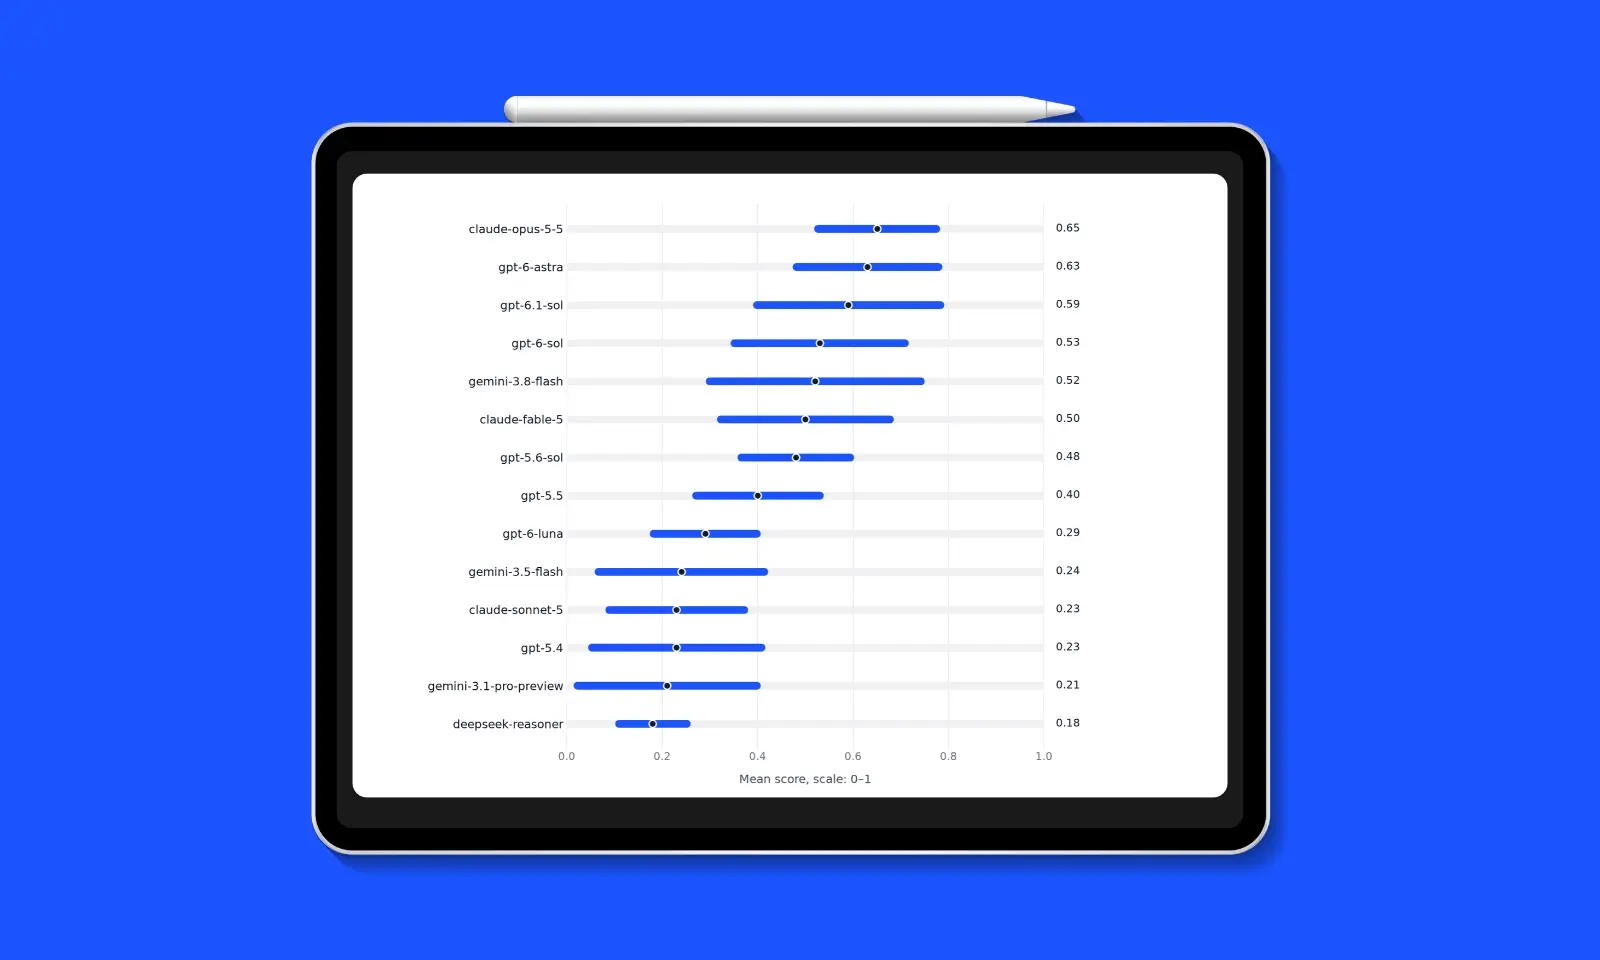
Claude Opus 5.5 возглавил новый рейтинг EDA Benchmark, который deepsense.ai опубликовала в своём блоге 2 ноября. У Opus 5.5 0,62 балла с поправкой на стабильность и 0,65 по среднему, у GPT-6 Astra 0,55 и 0,63. Тем, кто выбирает модель для агента, который разбирает данные, на отрыв Opus 5.5 от Astra можно опираться: в нашем пересчёте он сохраняется в 98,5% случайных перевыборок прогонов. Но почти весь отрыв набран на одной задаче, а порядок мест ниже первой пары зависит от того, как код считает провальные задачи.
EDA Benchmark проверяет разведочный анализ данных: модель открывает файлы, чистит несогласованные записи, сводит источники, ищет аномалии и возвращает структурированный ответ. Задач десять, все синтетические, и каждую модель решает пять раз. Средний балл показывает качество ответа, а балл с поправкой штрафует разброс между прогонами. В README проекта задачи названы намеренно ограниченными по сложности, числу и охвату. Модели июльского раунда заново не запускали, их цифры оставили для сравнения.
Откуда отрыв Opus 5.5
Средние у лидеров почти равны, а после поправки разница вырастает до 0,07. В deepsense.ai объясняют это большей нестабильностью Astra. Мы разложили баллы по задачам: разрыв почти целиком дала store-audit. Там у Astra три прогона на 1,00 и три на 0,063, поэтому балл задачи с поправкой упал до 0,06. Opus 5.5 решил её на 1,00 пять раз из пяти. Остаток пришёлся на solar-farm-daily-yield, где средний балл у Astra 0,263, а у Opus 5.5 0,585. На hospital всё наоборот: у Astra пять прогонов по 1,00, у Opus 5.5 пять по 0,50.
У Opus 5.5 пять задач из десяти решены идеально во всех прогонах, но на identify-unusual-values он набрал 0,024. Claude-fable-5 в июльском раунде получал там 0,958 во всех пяти прогонах.
Opus 5.5 гоняли через Claude Code с reasoning_effort: xhigh 20-21 октября, Astra через Codex тоже на xhigh. Так записано в файлах репозитория, сами мы этот параметр не замеряли. В Intelligence Index v5 Opus 5.5 в октябре тоже был впереди, 58 против 57, но там обе модели работали в режиме max.
Середина таблицы
Gpt-6.1-sol набрала 0,46 при среднем 0,59, gpt-6-sol 0,43 при 0,53. Gpt-5.6-sol из прошлого раунда сохранила 0,46 и делит с gpt-6.1-sol третье-четвёртое место. Claude-fable-5 с 0,42 стоит вровень с gemini-3.8-flash, хотя средний у gemini выше: 0,52 против 0,50. Главный пример у deepsense.ai: gpt-6-sol по среднему лучше gpt-5.6-sol, 0,53 против 0,48, но после поправки отстаёт, 0,43 против 0,46. Поэтому в продакшене авторы называют более надёжным выбором gpt-5.6-sol.
И этот пример, и ничья gemini с fable держатся на одном правиле в коде. Если модель получила ноль во всех пяти прогонах задачи, разброс не считается, и задача выпадает из балла с поправкой, хотя в средний входит нулём. Таких случаев девять, у gpt-5.6-sol и gemini-3.8-flash по одному, оба на hospital. Если считать их нулём, gpt-5.6-sol опускается до 0,410, ниже gpt-6-sol с её 0,434, а gemini-3.8-flash до 0,381, ниже claude-fable-5 с 0,423. У Opus 5.5, Astra, gpt-6.1-sol и gpt-6-sol таких задач нет, их цифры правило не меняет.
Авторский разбор
Что мы проверили
9 ноября мы пересчитали рейтинг кодом из репозитория проекта на выложенных там данных. Кроме того, сделали 10 000 случайных перевыборок пяти прогонов внутри каждой задачи, сами задачи при этом не перевыбирали.
Лидерство Opus 5.5 над Astra подтвердилось. Вывод, что новая gpt-6-sol уступает старой gpt-5.6-sol в надёжности, не устоял: порядок этой пары меняется и от правила подсчёта, и от случайного набора прогонов. Опубликованную таблицу по выложенным данным точно не собрать.
- В посте балл с поправкой описан как средний, умноженный на
exp(-2.25 × CoV^0.88). Код считает эту формулу отдельно для каждой задачи по её пяти прогонам и затем усредняет по десяти задачам. Если подставить в формулу общие цифры Opus 5.5, получится 0,38 вместо 0,62. - Разница между Opus 5.5 и Astra в перевыборках лежит в пределах от +0,04 до +0,145. Gpt-6-sol обходит gpt-5.6-sol в 26% перевыборок, разница от -0,063 до +0,054.
- Пост озаглавлен 28 октября, а вышел 2 ноября. Прошлый раунд в нём назван «26 июля», но это обновление от 14 июля, опубликованное 16 июля. Даты 26 июля в репозитории нет, вероятно, это опечатка.
- Скрипт проекта на этих данных падает с ошибкой: в четырёх парах «модель-задача» не по пять строк, а у claude-fable-5 и claude-sonnet-5 вовсе нет строк по the-heirs-estate (в файлах результатов там по пять таймаутов). Цифры Astra совпадают с опубликованными, только если убрать одну из строк 0,063 в store-audit. Со всеми шестью строками выходит 0,54 и 0,62. Судя по всему, таблицу собрали из выборки по пять строк, которой в репозитории нет.
Дальше
Anthropicразбор
CNBC: оценку IPO Anthropic опустили до 1-1,5 трлн
Дарио Амодеи ещё в августе назвал отношение людей к ИИ «кризисом доверия». Теперь Anthropic идёт на IPO, и её инвесторы, по данным CNBC, ждут оценку в 1-1,5 триллиона долларов вместо прежних 2. IPO Anthropic вы бы скорее купили или понаблюдали со стороны?
Читайте также
- Opus 5.5 отдаёт запросы о кибербезе Opus 4.8 до конца чата
- Opus 5.5 на уровне Fable 5.1, но на 40% дешевле Opus 5
- Opus 5.5 обошёл GPT-6 Astra в индексе v5: 58 против 57
- В Vending-Bench GPT-6 Astra впервые обошёл Claude Fable 5.1
- GPT-6 Astra опередил Claude Fable 5.1 на 35 баллов
- Тест на клипе: Claude Fable 5 против GPT-5.6 Sol за $100
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.