
Веса Kimi K3.1 Pro открыты: 104 млрд активных параметров из 2,8 трлн
Веса Kimi K3.1 Pro, MoE-модели Moonshot AI на 2,8 трлн параметров, из которых на токен работают 104 млрд, 4 ноября появились на HuggingFace под собственной лицензией «Kimi K3.1 Pro». На вышедших релизах vLLM и SGLang модель на 5 ноября не поднять: её архитектуру знают только day-0 образы и ветки, а одним весам, как показала наша проверка, нужно 1 454 ГиБ видеопамяти, что на B200 укладывается в один узел из восьми GPU, а на H100 занимает три.
В карточке модели Moonshot AI K3.1 Pro описана как открытая, нативно мультимодальная агентная модель с окном в 1 млн токенов, дообученная из Kimi K3 обучением с подкреплением сразу по сотням прикладных областей. Единственный коммит в репозитории датирован 2 ноября, публичными веса стали через два дня. Через API модель доступна на platform.kimi.ai под именем kimi-k3.1-pro, интерфейсы совместимы с OpenAI и Anthropic.
Чем запускать
Moonshot рекомендует vLLM, SGLang и TokenSpeed, но ни один вышедший релиз этих движков на 5 ноября не обслуживает архитектуру из config.json, это мы проверили сами. Рецепт vLLM требует версию 0.34.0 или новее, а последняя на PyPI - 0.33.0 от 2 ноября. До релиза остаются day-0 образы vllm/vllm-openai:kimi-k31-cu134 для CUDA и vllm/vllm-openai-rocm:kimi-k31 для AMD, выложенные в день публикации весов.
В SGLang релиз 0.5.23 от 30 октября модель не поддерживает. Основная ветка получила базовую поддержку K3.1 вечером 4 ноября, а кукбук собирает сервер из отдельной ветки kimi-k3.1-day-0. В рецептах TokenSpeed на момент проверки описан только Kimi K3.
Глубину рассуждений задаёт поле верхнего уровня reasoning_effort со значениями low, high и max, и запросы без него идут на max. В многоходовых диалогах и при вызовах инструментов модели нужно возвращать полное сообщение ассистента в том виде, в каком его отдал API.
Порог в 20 миллионов долларов
Лицензия K3.1 Pro отличается от лицензии Kimi K3 двумя строками, названием и именем модели для интерфейса: мы сравнили тексты. Основа у неё MIT с двумя условиями. Компания, которая продаёт доступ к моделям как сервис (Model as a Service) и вместе с аффилированными лицами получает больше 20 миллионов долларов выручки за любые 12 месяцев подряд, до любого коммерческого использования должна подписать с Moonshot отдельный договор. Продукты с аудиторией больше 100 млн пользователей в месяц или выручкой больше 20 миллионов долларов в месяц обязаны заметно показывать «Kimi K3.1-Pro» в интерфейсе. Внутреннее использование и «сертифицированных партнёров по инференсу» Moonshot отдельный пункт из-под условий выводит.
Пункт о сервисах пришёл в июле вместе с K3. K2.5, K2.6 и K2.7-Code выходили под Modified MIT License, где единственным условием было имя модели в интерфейсе.
Как читать таблицу Moonshot
Результаты K3.1 Pro Moonshot получила сама, в кодовых тестах чаще всего в обвязке Claude Code, а цифры конкурентов взяла из лидербордов, блогов и отчётов. Если не оговорено иное, модель работала на reasoning effort max с temperature 1,0 и top-p 0,95; в BrowseComp top-p был 1,0. В Terminal-Bench 4.0 у K3.1 Pro 65,7 против 66,4 у Claude Opus 5.5 и 58,2 у GPT-6 Astra, в SWE Marathon v1.1 она впереди: 51,7 против 46,3 у Opus 5.5. А в Program Bench у неё 31,5 против 65,0, в HLE-Full без инструментов 51,1 против 59,8 у того же Opus 5.5.
В октябре Kimi говорила, что перед открытым релизом вычистила из обучения данные по кибербезопасности, чтобы ослабить навыки взлома. В ExploitBench K3.1 Pro при лимите в 300 ходов набирает 74,7 (лучшая из пяти попыток) против 91,0 у Opus 5.5 и 100 у GPT-6 Astra, в ExploitGym с шестью часами на задачу 20,7 против 34,5 и 42,4.
Авторский разбор
Что мы проверили
5 ноября мы разобрали заголовки всех 96 шардов safetensors, config.json и лицензию K3.1 Pro, сравнили их с репозиторием Kimi K3 и посчитали, сколько GPU нужно под одни веса.
Масштаб из карточки подтвердился: по формам тензоров выходит 2,78 трлн параметров и 104,6 млрд активных на токен. В карточке сказано, что слои полного внимания Gated MLA заменили на Gated DSA, но веса MLA в этих слоях остались прежними, а DSA добавил к ним индексаторы. И кластер из нескольких узлов весам нужен только на Hopper.
| GPU | GPU под веса | Узлов по 8 GPU |
|---|---|---|
| H100 80 ГБ | 19 | 3 |
| H200 141 ГБ | 11 | 2 |
| B200 192 ГБ | 8 | 1, запас 81,9 ГиБ |
Это нижняя граница без KV-кэша и активаций. Yotta Labs для K3 называла кластер из нескольких узлов с памятью от 1,6 ТБ, а базовый рецепт vLLM для K3.1 Pro указывает один узел B300 или MI355X. В MXFP4 хранятся только маршрутизируемые эксперты, 97,9% параметров; внимание, общие эксперты, lm_head и визуальный энкодер остались в BF16.
- От весов K3 чекпойнт отличается всего на 178,5 млн параметров индексаторов DSA, 357 МБ в BF16, остальные формы совпадают. Слои DSA стоят каждым четвёртым плюс последний, 24 из 93. Вывод сделан по формам тензоров, Moonshot его не делала.
- Кэш на одну последовательность в полном окне в 1 048 576 токенов по нашему расчёту из конфига занимает 33,0 ГиБ в BF16 или 16,5 ГиБ в FP8 вместе с ключами индексатора; движки считают по-своему, vLLM хранит латент MLA в NVFP4. 69 слоёв KDA при любой длине контекста держат постоянные 0,44 ГиБ.
Дальше
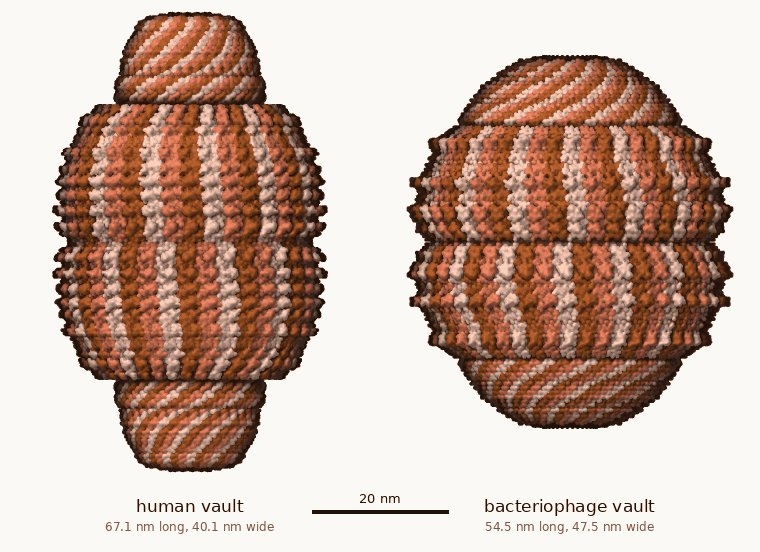
Claude собрал первую 3D-структуру волта прокариот, Видео
Выделение волт-частиц обычно занимает около трёх дней, у биологов Anthropic ушло примерно 90 минут. Колонку и способ проверки подсказал Claude, который сначала как раз отговаривал от этого подхода. Вы бы послушали модель, которая отговаривает от вашего плана, или проверили бы сами?
Читайте также
- Kimi K3.1 Pro отстала от Opus 5.5 на Terminal-Bench 4.0
- Веса Kimi K3 на 2,8 трлн параметров открыты
- Hy4 от Tencent получил зрение по цене превью, веса позже
- NVIDIA научила модель расшифровки речи слушаться промптов
- Открытой FLUX 3 Image Klein в пике нужно 31 ГБ видеопамяти
- Nemotron 3.5 Super VL сильна в терминале, слабее в коде
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.