
Muse Spark Open от Meta умещается в два Mac Studio
Meta 15 октября открыла веса Muse Spark Open, флагманской модели линейки Muse. Компания заявила, что модель работает на столе: нужны две Mac Studio с M5 Ultra и свежая версия MLX. Днём позже Apple назвала скорость. На паре машин модель генерирует около 25 токенов в секунду.
В блоге Meta Muse Spark Open называют «самой способной американской моделью с открытыми весами». Модель изначально мультимодальная и построена как смесь экспертов: всего у неё 816 миллиардов параметров, а на каждый токен работают 42 миллиарда. Контекстное окно составляет 1 миллион токенов. Делали её под код, агентные сценарии и многошаговые рассуждения. Марк Цукерберг написал, что модель «отлично работает на новых Mac Studio» благодаря совместной работе с Джоном Тернусом и Apple.
Почему хватает двух Mac Studio
Mac Studio устроена так, что встроенный GPU в M5 Ultra использует до 512 ГБ объединённой памяти. Две машины вместе дают терабайт, и по замыслу Meta в него помещаются все веса. Пропускная способность памяти у чипа 1,2 ТБ/с. При смеси экспертов на каждом шаге читаются веса только активных экспертов, поэтому такой полосы хватает. В Meta говорят, что две Mac Studio «ведут себя как один суперкомпьютер с терабайтом объединённой памяти».
Агентные сценарии Meta гоняла целиком на устройстве, через собственного агента Muse Code. Модель вносила изменения в Ice Cubes, открытый iOS-клиент для Mastodon: чинила баги, добавляла функции, проводила полную сборку. В DaVinci Resolve она сама покадрово просматривала отснятое видео, выбирала самые сильные моменты и кадрировала их под вертикальный формат.
Облачных вариантов много. По API модель доступна у Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter и Together AI. Веса лежат на Hugging Face, в Amazon SageMaker AI, Google Cloud Model Garden и Microsoft Foundry Models. Для SGLang Meta выпустила самонастраивающиеся GPU-ядра Helion и заявляет ускорение ядер в 1,03-3,95 раза на NVIDIA и AMD, а на AMD MI350 3% прироста от начала до конца запроса. Перед выпуском модель прошла дополнительное дообучение на безопасность. По словам Meta, она уложилась в пороги, которые требует внутренний Meta Superintelligence Scaling Framework. Полный отчёт об оценке компания обещает выпустить позже.
Мы сверили таблицу бенчмарков в модельной карточке. Во всех трёх строках про код Muse Spark Open уступает Kimi K3: в DeepSWE 1.1 у неё 60 против 68, в SWE-Atlas-QnA 58 против 66, в Terminal-Bench 2.1 76,4 против 85,0. В агентных задачах и задачах на знания она впереди. В MCP-Atlas у неё 89,2 против 82,3, в JobBench 61,8 против 54,3.
Как Meta шла к открытым весам
Первая Muse Spark была закрытой. Она бесплатно работала в meta.ai и приложении Meta AI, а API оставался в закрытом превью. Ещё в анонсе Meta называла слабыми местами долгие агентные задачи и работу с кодом.
- апрель: Meta Superintelligence Labs представила Muse Spark, первую модель линейки Muse;
- 9 июля: вышла Muse Spark 1.1 с окном в 1 миллион токенов и публичным превью Meta Model API;
- 10 августа: Meta выложила веса Muse Glimmer, модели на 30 миллиардов параметров под Apache 2.0;
- август и сентябрь: вышли Muse Spark 1.2 и 1.3, и к 1.3 Meta уже обещала открытую версию «скоро»;
- 15 сентября: на Hugging Face появился официальный репозиторий Muse Spark Open, за месяц до релиза;
- 15 октября: веса Muse Spark Open открыты.
Отличий от прежних шагов два. Открыта сама флагманская линейка, а не маленькая модель рядом с ней. И лицензия своя: Glimmer распространяется под Apache 2.0, а Muse Spark Open под Muse Model License, где Meta говорит об «ограниченных коммерческих условиях».
Мы прочитали текст лицензии. В каждом продукте на основе модели или её производных нужно показывать надпись «Built with Muse Spark Open». Компании, которые продают модель как API и получают больше 20 миллионов долларов валовой выручки за любые 12 месяцев, обязаны уведомить Meta и подписать отдельный договор. На внутреннее использование и функции в собственных продуктах это требование не распространяется. Производными считаются и модели, обученные или дистиллированные на её ответах. Политика использования запрещает военные задачи и задачи под ITAR, критическую инфраструктуру, оружие и выдачу ответов модели за человеческие. Права на ответы модели Meta за собой не оставляет.
Авторский разбор
Что мы проверили
18 октября мы открыли репозитории модели на Hugging Face, модельную карточку, таблицы Apple и пулреквесты в движках вывода, а потом посчитали память и потолок скорости.
Meta пишет, что две Mac Studio вмещают модель целиком. Это верно только для 4-битного чекпойнта NVFP4 на 533 ГБ. Выпущенная модель в BF16 весит 1,64 ТБ, и по модельной карточке ей нужно 2 ТБ памяти. Скорость на Mac Meta в анонсе не назвала. Apple опубликовала замеры 16 октября, скорость генерации считали по 128 токенам после контекста.
| Конфигурация | Генерация, 8k, ток/с | Генерация, 64k, ток/с | Первый токен, 8k, с | Первый токен, 64k, с |
|---|---|---|---|---|
| 2 Mac, конвейер | 15,74 | 14,37 | 8,4 | 47,6 |
| 2 Mac, тензорный параллелизм | 24,99 | 23,84 | 8,2 | 70,3 |
| 4 Mac | 36,73 | 34,66 | 4,8 | 40,6 |
- По нашей приблизительной оценке, полоса памяти двух чипов даёт потолок около 88 токенов в секунду. Замер Apple на паре машин составляет примерно 28% от него. Вычисления и передачу данных между Mac оценка не учитывает.
- KV-кэш, где хранится контекст, при 1 миллионе токенов в BF16 занимает около 66 ГБ. Вместе с весами NVFP4 выходит около 599 ГБ без учёта активаций и системы, и это укладывается в терабайт.
- Поддержка в движках неравномерная. В llama.cpp, Transformers, mlx-lm и Unsloth её уже приняли. В vLLM пока лишь черновик пулреквеста, и он ждёт изменений во flashinfer. В SGLang приняты три части из пяти, а части с поддержкой AMD ROCm и ядрами Helion ещё открыты. Цифры ускорения Helion мы нашли только в блоге Meta.
Как запустить
На Apple Silicon веса подтягивает MLX прямо с Hugging Face. Поддержку чекпойнта NVFP4 добавили в mlx-lm 0.32.0 от 15 октября. На странице для разработчиков Meta указывает два варианта железа: две Mac Studio по 512 ГБ или четыре по 256 ГБ. В модельной карточке есть оговорка, что квантованная версия может немного отличаться по качеству. Одной машиной можно обойтись только с 2-битной версией. GGUF Q2_K от ggml-org весит 304 ГБ и помещается в 512 ГБ, 2-битная сборка Unsloth укладывается в 256 ГБ. Для 8-битной версии нужно 900 ГБ. Дообучать модель Meta предлагает через TorchTitan на PyTorch. Официальный репозиторий Meta закрыт, доступ выдают после ручного одобрения. Зеркала unsloth, mlx-community и ggml-org скачиваются без заявки.
Дальше
Claude Code начал сжимать переписку перед отправкой модели
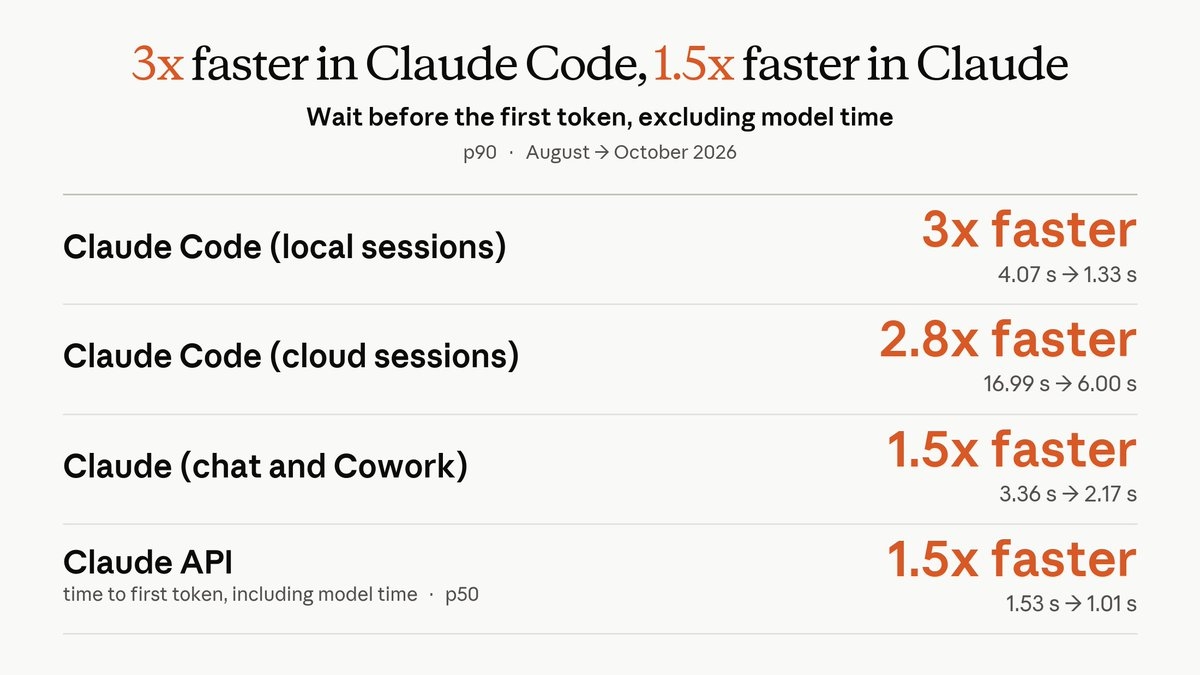
Claude Code начал сжимать gzip всю переписку, которую шлёт модели на каждом ходу, и потому она доходит быстрее, а Claude начинает отвечать раньше. Долгие задачи в Claude Code вы ведёте в одном разговоре или часто начинаете новый?
Читайте также
- Открытая Muse Spark Open от Meta проигрывает Kimi K3 в коде
- Веса моделей DeepSeek и Kimi указали на чипы Blackwell
- DeepSeek выложила движок своего API, Huawei наравне с Nvidia
- Surface Laptop Ultra тянет локальные модели, пока в розетке
- Perplexity пустила агента на Windows, но без стоковой Qwen
- Nvidia купит Hugging Face за 12,9 млрд долларов
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.