
После снижения цены на 80% Luna вышла в лидеры SQL
MotherDuck заново прогнала свои агентные бенчмарки после того, как OpenAI на 80% снизила цену GPT-5.6 Luna. На бенчмарке семантического моделирования расходы упали в 10 раз даже по сравнению с Luna неделей ранее. Об этом команда написала в блоге MotherDuck 14 августа.
Второй результат касается агентного SQL-бенчмарка, где модель сама пишет запросы к базе, получает ответ и доводит его до результата. Там Luna на максимальном усилии рассуждений вытеснила с первого места Gemini-3-Flash на низком усилии. Точность осталась на уровне 99,8%, а цена получилась в 5 раз ниже. По словам авторов, сначала они даже решили, что где-то ошиблись.
Откуда берутся 5x и 10x
Новая цена Luna в API - $0,20 за миллион входных токенов и $1,20 за миллион выходных, она действует с 30 июля. Минус 80% к цене токена дают как раз пятикратную экономию, и на SQL-бенчмарке MotherDuck получила именно её. На семантическом моделировании вышло вдвое больше. Этот дополнительный двукратный выигрыш в команде связывают с улучшениями кэширования на стороне модели. Сам бенчмарк семантического моделирования MotherDuck пока подробно не описала и обещает отдельный пост.
С чем сравнивать, видно по прежнему лидеру. Агентная SQL-система MotherDuck для бенчмарка DABStep, описанная в репозитории компании на GitHub, с gemini-3-flash на низком уровне рассуждений решила все 419 из 419 задач очищенного полного тестового набора. Прогон стоил около $7,91, примерно 1,9 цента за вопрос. Там же сказано, что низкий уровень рассуждений давал ту же точность, что средний, за половину цены. Вариант без рассуждений обходился дешевле всего, $7,3, но давал разброс около 1% в соблюдении правил. Теперь MotherDuck пишет, что связка современной небольшой модели и быстрой аналитической СУБД отвечает с низкой задержкой дешевле чем за полцента за ответ, причём в эту сумму входят и расходы на ИИ, и расходы на базу.
Есть и цифра за пределами аналитики. В DeepSWE Luna отстаёт от Fable на 3% и стоит меньше десятой части её цены. Авторы сравнивают масштаб сдвига с выходом Opus 4.5: тогда модели стали практичны для профессионального объёма кода, сейчас похожий скачок случился в другой точке кривой «цена-качество». Luna, по их словам, хорошо пишет SQL и при этом, в отличие от Opus, быстрая и дешёвая.
Из этого MotherDuck выводит первый практический шаг. Если вы гоняете большую модель на низком усилии, попробуйте вместо неё Luna на максимальном. Раз вы уже снизили усилие, вы фактически отметили задачи, где максимальный интеллект не нужен, и на них модель можно просто заменить. Второй шаг - задавать больше вопросов. Авторы ссылаются на парадокс Джевонса: когда технология дешевеет, её начинают применять чаще. На практике это проверка пяти гипотез разом до ответа агента, более глубокие итерации по деталям или заранее подготовленные ответы на вероятные вопросы клиентов, чтобы не ждать, пока клиент выберет вопрос из списка.
Узким местом стала база
В агентных сценариях общее время раньше упиралось в запрос к LLM. Когда один ход агента занимал десятки секунд, ускорение базы данных мало что меняло. С быстрой моделью расклад другой. В MotherDuck утверждают, что аналитические СУБД бывают в 1000 раз быстрее транзакционных, если нагрузка аналитическая, а такие запросы среди вопросов агентов встречаются часто. По их оценке, после обновления Luna пользовательский опыт теперь тормозит транзакционная база.
Второй пример про холодный старт. Если аналитическому хранилищу нужно 30 секунд, чтобы подняться, база с низкой задержкой успела бы за это время ответить на 10 вопросов агента. Нагрузка от агентов идёт всплесками, поэтому авторы советуют бессерверную схему с низкой задержкой, особенно для агентных функций, которые видят клиенты. MotherDuck сама продаёт облачную аналитическую базу на DuckDB, и в её собственной обвязке данные лежат именно там.
Контекст для слабой модели
Модель по-прежнему хороша ровно настолько, насколько хорош её контекст. Раньше, пока слабые модели не умели писать точный SQL, документацию по домену хватало довести до уровня, понятного сильнейшей модели. Теперь MotherDuck советует расписывать контекст подробнее, чтобы его разобрала и модель послабее: потраченное на документацию время снижает расходы и ускоряет ответы.
В той же обвязке для DABStep видно, как это устроено. Она опирается на две идеи из работы Anthropic о самостоятельной аналитике данных. Первая - компактный навык, файл skill/SKILL.md, который вставляется в системный промпт. Вторая - семантический слой: инструмент semantic_lookup отдаёт знания о предметной области постепенно, сначала список доменов, затем однострочные описания пунктов, затем полный текст. Вся база знаний занимает около 53 тысяч символов, но на трудный вопрос агент подгружает примерно 16 тысяч. Постоянная часть промпта примерно в 3,4 раза меньше, чем если бы в него вставили весь справочник.
Из этой схемы команда вынесла правило: самые важные инструкции должны жить в навыке, который загружен всегда, а не в пунктах, до которых агент добирается запросом. Иначе модель с низким уровнем рассуждений или без рассуждений их пропускает.
Зачем эвалы чаще
Тесты в мире данных исторически сводились к проверкам качества: нет дублей в ID клиентов, нет NULL в ценах заказов, каждый заказ связан с реальным товаром. Для агентной аналитики MotherDuck предлагает другой набор: вопрос на естественном языке и правильный ответ по данным. Агент получает вопрос, бизнес-контекст и подключение к базе, а эвал проверяет, сошёлся ли ответ. Такие прогоны подешевели в 5 раз, и авторы предлагают потратить экономию на то, чтобы запускать их намного чаще: смотреть каждую новую модель и подбирать настройки внутри неё, а не принимать значения по умолчанию от одной лаборатории.
Частые эвалы, по мысли команды, ловят и колебания самой модели. Качество ответов зависит не только от весов, но и от инфраструктуры, на которой модель обслуживают: когда мощностей не хватает, модель отвечает хуже. Хорошо откалиброванная система эвалов это заметит, и бизнес сможет переключиться на другую модель, например в дни перед новым релизом или в часы пиковой нагрузки.
Проверять стоит и сам контекст: каждый новый кусок знаний об организации может помочь или навредить. В посте упоминается, что команда данных OpenAI считает отлов регрессий в своём контекстном слое одной из главных пользы от фреймворка эвалов. Еженедельных прогонов для этого, по оценке MotherDuck, мало. Меняется и бизнес. Если появилась новая программа скидок, агент может перестать правильно считать выручку, и лучше поймать такую логическую ошибку до того, как график уйдёт совету директоров.
Свои эвалы MotherDuck гоняет через OpenRouter в собственной обвязке, поэтому любую новую модель любой из ведущих лабораторий может проверить в течение нескольких часов после запуска. Авторы советуют вкладываться в обвязку и контекст, а модель считать взаимозаменяемым товаром, держать стоимость переключения низкой и переходить на следующую лучшую модель, как только та окупается. Позже, 28 августа, MotherDuck опубликовала сравнение облачных и локальных моделей на DABStep по соотношению цены, времени работы и точности, в том числе с Qwen3.8 27B.
Дальше
Локальная Qwen3.8-27B вышла с контекстом 262K
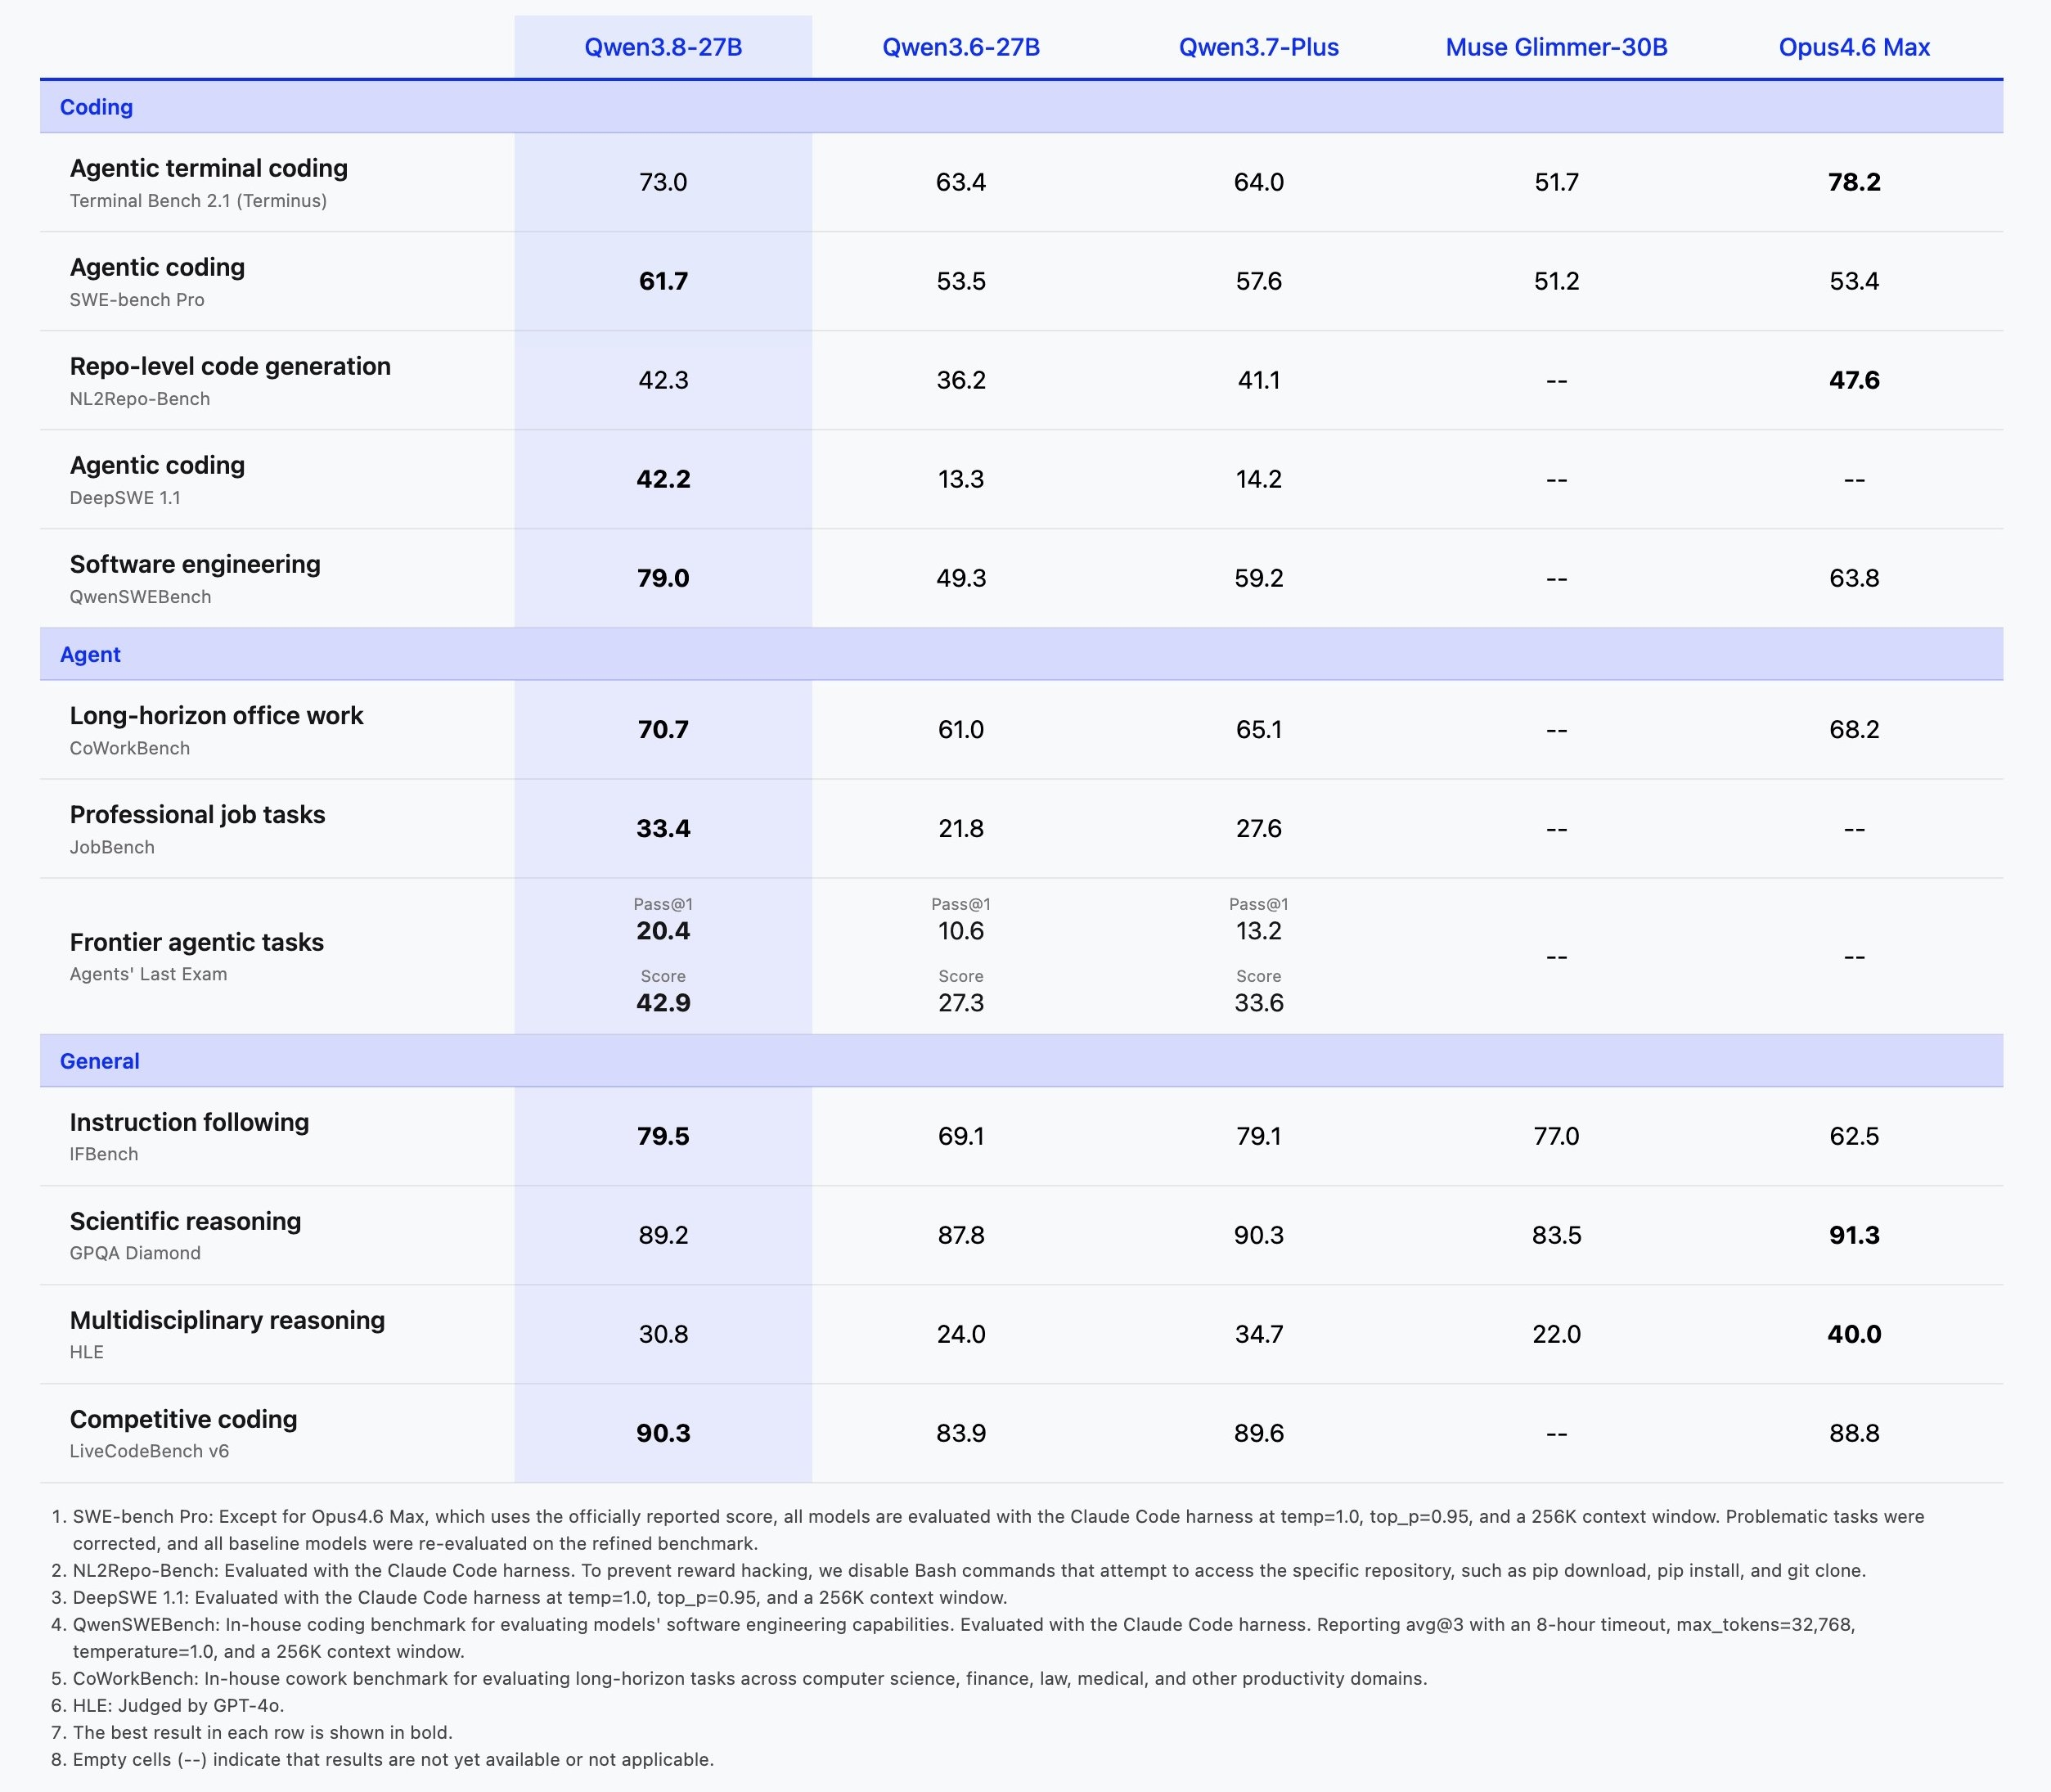
Веса Qwen3.8-27B появились на Hugging Face под лицензией Apache 2.0. Модель плотная и нативно мультимодальная, запускается локально, при этом нативное окно контекста 262K токенов расширяется до 1 миллиона через YaRN.
Читайте также
- Luna в API подешевела на 80%, Terra на 20%
- Haiku 5.5 заметила утечку, которую пропустил GPT-6.1 Sol
- OpenAI раздаст учёным бесплатный ChatGPT Plus
- Fable 5.2 решил тесты как Opus 5.5, но почти вчетверо дороже
- Fable 5.2 обошлась в 13,39 доллара против 3,99 у Astra
- Opus 5.5 обошёл GPT-6 Astra в тесте на стабильность
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.