
anthropic
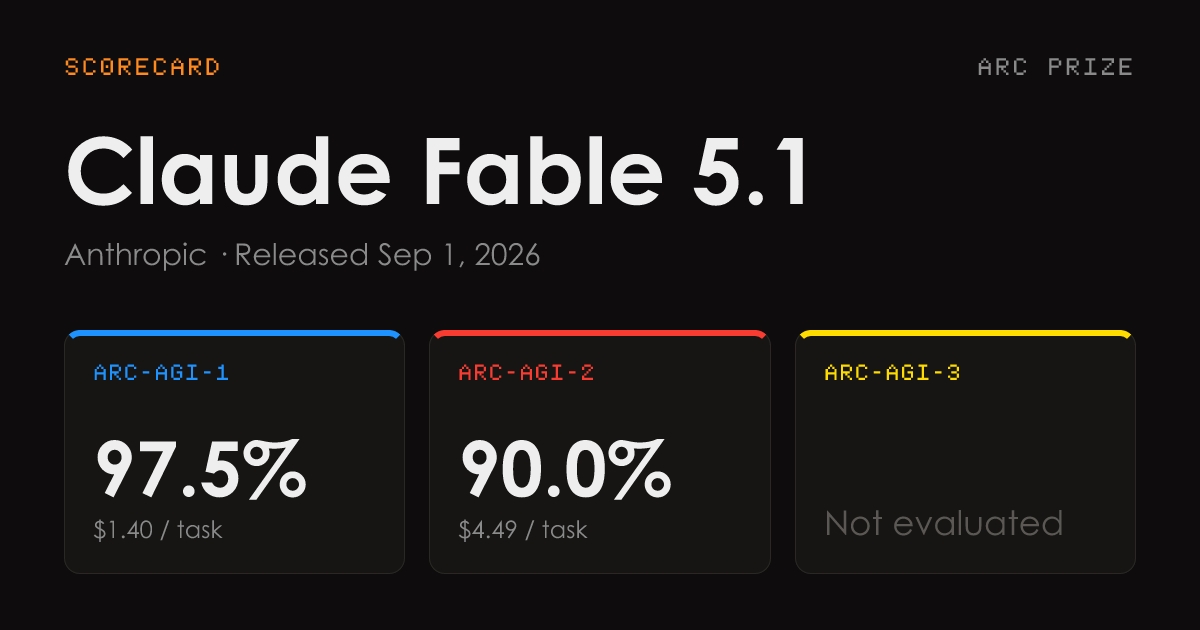
90% на ARC-AGI-2 стоят 4,49 доллара за задачу
Promtime
 anthropic
ARC Prize опубликовала проверенные результаты Claude Fable 5.1: на максимальном режиме рассуждений модель Anthropic набирает 90,0% на ARC-AGI-2 Semi-Private при цене 4,49 доллара за задачу. Тот же режим на ARC-AGI-1 Semi-Private даёт 97,5% при 1,40 доллара за задачу, следует из результатов ARC Prize.
Коротко
- Проверено пять уровней рассуждений, от Low до Max: на ARC-AGI-1 их результаты укладываются в диапазон от 90,0% до 97,5%, на ARC-AGI-2 в диапазон от 78,3% до 90,0%.
- В сводной таблице режим XHigh повторяет результат Max на ARC-AGI-2, оба дают по 90,0%, и уступает ему один процентный пункт на ARC-AGI-1, где показывает 96,5% против 97,5%.
- Кроме итоговых процентов, опубликована разбивка по отдельным задачам: 120 заданий в ARC-AGI-2 Public Eval и 400 в ARC-AGI-1 Public Eval, с отметкой прохождения для каждого из пяти режимов.
Разница в стоимости между двумя бенчмарками говорит больше, чем разница в процентах: в режиме Max одна задача ARC-AGI-2 обходится более чем втрое дороже задачи ARC-AGI-1, и при этом решается хуже. Судя по таблице, отдача от наращивания бюджета рассуждений на ARC-AGI-2 упирается в потолок: XHigh даёт ровно тот же процент, что и Max. Для тех, кто считает стоимость инференса, это выглядит как ориентир: верхний режим окупается не на всех наборах.
На ARC-AGI-1 верхние четыре режима укладываются в диапазон от 94,5% до 97,5%: Max набирает 97,5%, XHigh 96,5%, High 96,0%, Medium 94,5%. Низший из проверенных уровней, Low, отстаёт заметнее и даёт 90,0% на том же наборе, то есть ровно столько, сколько Max показывает на ARC-AGI-2.
На ARC-AGI-2 разброс между уровнями рассуждений заметно шире. Max и XHigh дают по 90,0%, High опускается до 88,8%, Medium до 86,3%, а Low останавливается на 78,3%. Разрыв между крайними режимами на этом наборе достигает 11,7 процентного пункта против 7,5 пункта на ARC-AGI-1.
Разбивка по отдельным задачам показывает, что результат растёт с уровнем рассуждений не всегда. В публичном наборе ARC-AGI-2 задача 800d221b провалена в режиме Max, но пройдена на XHigh и High, а 88bcf3b4 взята только на High. В наборе ARC-AGI-1 задача f3b10344 решена на High, Medium и Low и провалена на XHigh и Max.
Есть и задачи, которые не поддались ни одному из пяти режимов: 88e364bc в публичном наборе ARC-AGI-2 и 0d87d2a6 в ARC-AGI-1. В таблице лидеров ARC-AGI-2 рядом с Claude Fable 5.1 указаны Claude Opus 5, GPT-5.6 Sol, Gemini 3.7 Flash, Grok 4.6, DeepSeek V4 Pro 0813, Kimi K3 и Inkling.
Цены названы только для Max
Из пяти проверенных вариантов стоимость за задачу опубликована только для максимального режима рассуждений. Для XHigh, High, Medium и Low ценовых значений в опубликованных материалах нет, поэтому сопоставить экономику уровней рассуждений между собой по этим данным не получится. Результатов на ARC-AGI-3 в таблице тоже нет: столбец пуст для всех пяти проверенных вариантов.
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.
Из Google мы используем только имя и аватар. Почту не сохраняем.