
Mistral выложила веса Large 4 на 1 трлн параметров
Mistral 29 октября открыла веса Mistral Large 4 по прозвищу Le Chonk. Это MoE-модель на 1 трлн параметров, из которых на каждый токен работают 49 миллиардов, и она лежит в репозитории Mistral AI на Hugging Face. Если вы собираетесь запускать её на своих серверах, коммерческое использование лицензия разрешает, а продавать модель как сервис можно только по отдельной коммерческой лицензии Mistral. Официальные рецепты запуска рассчитаны на узел из восьми GPU.
Превью открыли 6 октября, и тогда модель была доступна только через API. После него Mistral три недели дообучала её с подкреплением и теперь говорит о более экономном рассуждении и более дешёвом инференсе. Цена в API, по материалам Testing Catalog, начинается с 0,70 доллара за миллион входных токенов, 0,07 доллара за кэшированные и 2,10 доллара за выходные, а в превью брали 1,36 и 4,18 доллара. Mistral Large на странице цен Mistral стоит меньше: 0,5 доллара за вход и 1,5 доллара за выход. Но у Large 3 контекст 256 тысяч токенов, а у Large 4 - 1 миллион.
Как поднять у себя
Хотя на токен работают 52 миллиарда параметров вместе с эмбеддингами и выходными слоями, в памяти приходится держать весь триллион. Внутри 128 маршрутизируемых экспертов, из которых на токен включаются четыре, плюс один общий. Модель принимает текст и картинки, отвечает текстом и знает больше 160 языков. Обучали её с нуля на 3 800 GPU Grace Blackwell в собственных дата-центрах Mistral в Европе.
Для продакшена Mistral рекомендует vLLM и официальный образ vllm/vllm-openai:mistral-large-4. В примере запуска стоит --tensor-parallel-size 8, а без флагов --tool-call-parser mistral и --reasoning-parser mistral не будут работать вызовы инструментов и рассуждение не отделится от ответа. Если памяти GPU не хватает, компания советует снизить --max-model-len или --max-num-seqs. Отдельно выложен квантованный чекпойнт NVFP4 в 4-битном формате для видеокарт Blackwell. По словам Mistral, он занимает меньше памяти и работает быстрее при том же качестве. Его поддерживают vLLM и SGLang.
В основной чекпойнт встроена черновая голова DSpark для спекулятивного декодирования: три плотных слоя в BF16 предлагают сразу блок из трёх токенов, а основная модель их проверяет, поэтому её ответы не меняются. В vLLM она включается аргументом --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'. Mistral намерила до 1,9 раза более высокую пропускную способность, чем без драфта, и оговаривается, что выигрыш зависит от железа и нагрузки. В рецепте SGLang DSpark уже включён флагом --speculative-algorithm DSPARK, а число одновременных запросов зафиксировано на 64. Если убрать --max-running-requests, SGLang вернётся к 48.
Режимов рассуждения три: low, medium и high, по умолчанию high. High компания советует для сложных запросов и агентов, medium для повседневной работы, low для быстрых ответов в чате, а для всех трёх рекомендует temperature 1,0 и top_p 0,95. Лимит max_completion_tokens учитывает и видимый ответ, и токены рассуждения, так что на high его стоит ставить с запасом.
Кроме vLLM и SGLang, модель запускается через transformers из ветки main и через llama.cpp с готовыми GGUF, а дообучать её можно в Axolotl, Unsloth и TRL. Если локальный запуск выходит хуже, Mistral сама советует перейти на её API, где модель называется mistral-large-4. По данным Testing Catalog, Large 4 есть также в Mistral Studio, OpenRouter, Microsoft Foundry и на эндпоинтах NVIDIA. Официальные демо в галерее Le Chonk Gallery первую неделю после релиза работают на небольшом бесплатном бюджете для каждого посетителя.
Что измерено
В карточке модели Mistral сравнивает Large 4 только с открытыми моделями. На Coding Agent Index от Artificial Analysis у неё 48%, вровень с GLM-5.3, при этом на задачу в среднем уходит на 47% меньше токенов. В сводном Intelligence Index v5 той же Artificial Analysis у модели 26 баллов, лучший результат среди западных открытых моделей. Ведущие китайские открытые модели, признаёт Mistral, набирают в этом индексе больше.
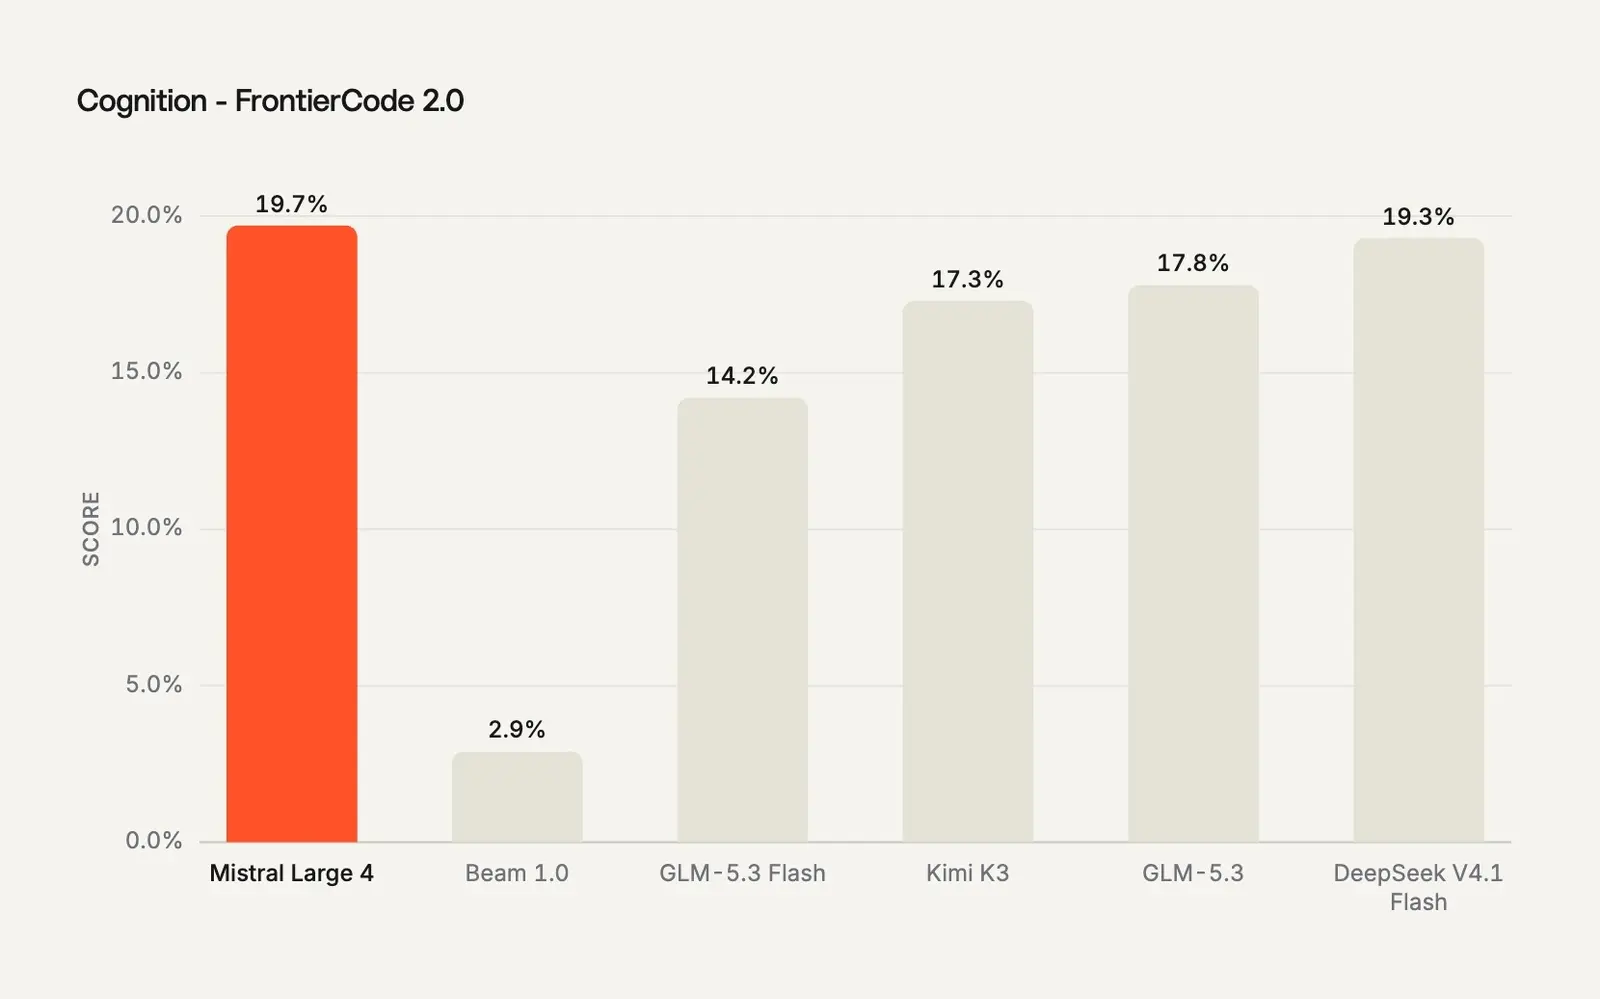
Остальные цифры приводит Testing Catalog. На закрытом бенчмарке Cognition FrontierCode 2.0 модель набрала 19,7% и стала первой среди открытых. На Terminal-Bench 4.0 результат с превью вырос на 13 процентных пунктов, до 41%, а выходных токенов стало на 30% меньше. В слепых сравнениях Surge Code Large 4 оказалась выше GLM-5.3, Kimi K3 и DeepSeek V4.1 Flash и уступила только Claude Opus 5.5. Вне кода у модели 73,3% на финансовом Finch и 84,5% на BrowseComp против 75% у SFT-чекпойнта. Устойчивость к атакам на агентском бенчмарке B3 Agent Security Benchmark выросла с 93,3% в превью до 97,1%.
Кибербезопасность
На Cyber Index от Artificial Analysis, который проверяет поиск, воспроизведение, валидацию и исправление уязвимостей так, чтобы не сломать существующие функции, Large 4 набрала 51%, пишет Testing Catalog. По словам Mistral, её защитные фильтры не мешают оборонительной работе и при этом отклоняют в среднем 96,6% вредоносных запросов, больше всех открытых моделей в замерах компании.
Однако мониторинг живого трафика, как признали в Mistral, показал, что модель потенциально может помочь в реальных атаках, и фильтры сейчас дорабатывают. Отдельную кибер-версию модели тестируют с проверенными корпоративными партнёрами и только на системах, которыми те владеют или которые им разрешено проверять.
Дальше
The Information: DeepSeek и Moonshot учились на GPT-6 Astra
Kimi K3.1 Pro от Moonshot AI вышла только на прошлой неделе, и, по данным The Information, её во многом учили на ответах GPT-6 Astra от OpenAI. То же издание говорит и про DeepSeek V4.1-Flash 1017, выпущенную 17 октября. Kimi или DeepSeek: какая из двух моделей у вас сейчас в работе?
Читайте также
- Mistral Large 4 обошла GLM-5.3 на DeepSWE, пишет VentureBeat
- Large 4 от Mistral: API сегодня, веса в конце октября
- Новая модель Mistral обходит китайские в отдельных областях
- Минорный апдейт DeepSeek обогнал Opus 5 на DeepSWE
- У LFM2.5 от Liquid AI из 24B параметров работают 2B
- Дообучение MiMo-V2.6-Pro обошлось Xiaomi в 2,62 миллиона
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.